TGViewer
Channel Public Channel
Android under the hood

Android under the hood

@android_under_the_hood

Разбираю Android, Kotlin и JVM изнутри.
Коллекции • Coroutines • Compose • JVM • Android internals

while (isAlive) { beHappy(); }

лс: @dmitry_tsyvtsyn
Subscribers
1.53K
Photos
67
Videos
1
Links
75
Recent Posts 20 shown
Post #138 619
Всем привет, хочу поделиться проектом, который запустил 1 октября — ЗдесьЯ.

Это цифровая стена, где каждый может заполнить небольшой квадратик фоткой и написать текст на обратной стороне.
Получается своего рода капсула времени — место, куда можно зайти спустя годы и понастальгировать о прошлом.
Вообще в планах сохранить эту стену до 2036, то есть на 10 лет, так что присоединяйтесь, будет прикольно)

ЗдесьЯ — оставь свой след.
👉 https://www.iwashere.su

PS. С VPN'ом может долго открываться.
  • 🥴 9
  • ❤ 1
  • 👍 1
  • 👏 1
  • 😎 1
Post #137 670
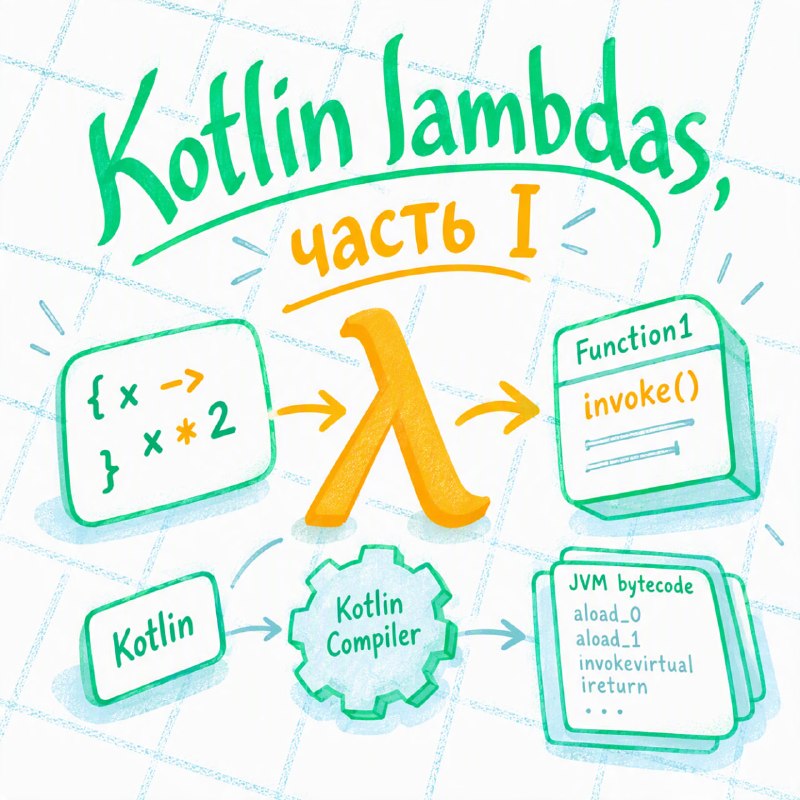
Kotlin lambdas, часть I.

До версии Kotlin 2.0 лямбды компилировались в анонимные классы, реализующие один из интерфейсов FunctionX:
val twice: (Int) -> Int = { value -> 
value * 2
}

// лямбда является обычным классом который наследует интерфейс FunctionX
final class TwiceLambda implements Function1<Integer, Integer> {

// лямбды которые не захватывают переменные простые синглетоны, это нужно для переиспользования
public static final TwiceLambda INSTANCE = new TwiceLambda();

private TwiceLambda() {}

@Override
public Integer invoke(Integer value) {
return value * 2;
}
}


Базовых интерфейсов для Kotlin лямбд всего 24, начиная с Function0, лямбда которая ничего не принимает, только возвращает результат, заканчивая Function22, лямбда которая принимает 22 параметра, также есть FunctionN для лямбд с переменным количеством аргументов.

Если лямбда захватывает переменную, то ее значение просто передается в конструктор:
val koeff = 2
val twice: (Int) -> Int = { value ->
value * koeff
}

final class TwiceLambda implements Function1<Integer, Integer> {

private final int koeff;

// в таком случае сложнее переиспользовать обьект лямбды
public TwiceLambda(int koeff) {
this.koeff = koeff;
}

...
}


Захват с var практически ничем не отличается, только значение кладется в IntRef, ObjectRef и тд, тут можно почитать.

Во второй части поговорим что стало с лямбдами в Kotlin 2.0+
  • 👍 18
  • ❤ 7
  • 🔥 1
Post #136 1.15K
Делегат свойства в Kotlin.

В Kotlin есть конструкция, которой нет в JVM:
var name by NameDelegate() // в JVM такого нет


Под капотом компилятор превращает все это в такую штуку:
// по сути в JVM нет такого поля как name, вместо этого создается объект делегата
final NameDelegate name$delegate = new NameDelegate();

// дополнительное поле которое хранит данные о свойствах, заполняется при конструировании объекта, нужно чтобы различать несколько свойств
private static final KProperty[] $$delegatedProperties;

final String getName() {
// данные о свойстве достаются просто по индексу
return name$delegate.getValue(
this,
$$delegatedProperties[0]
)
}

final void setName(String name) {
name$delegate.setValue(
this,
$$delegatedProperties[0],
name
)
}


Получается что работа со свойством просто передается другому объекту, то есть делегируется, отсюда и название "делегат".

Сам по себе делегат выглядит так:
class NameDelegate {

// operator говорит компилятору что это специальная функция, которая используется в синтаксисе языка (by)
operator fun getValue(
thisRef: User,
property: KProperty<*>
): String {
return "Volga GAZ 21"
}

operator fun setValue(
thisRef: User,
property: KProperty<*>,
value: String
) {}
}


Для делегатов свойств которые не меняются (val) setValue() не переопределяется.
  • 👍 19
  • 🔥 4
Post #135 1.43K
val vs var под капотом.

На уровне Kotlin все просто:
val x = 10
var y = 20

y = 30 // компилятор разрешает
x = 30 // компилятор запрещает


Если глянуть глубже, на уровне JVM, то там ничего подобного вообще нет:
class Dessert {

val name = "Cake" // превратится в private final String name с getName() методом

var count = 0 // превратится в private int count c getCount() и setCount() методами

}

Ключевое слово final запрещает полю присваивать новое значение, это проверка реализована на уровне верификатора JVM, специальный компонент JVM который проверяет корректность команд байт-кода, очень важная штука для безопасного выполнения кода.

Локальные переменные проверяются только на уровне Kotlin компилятора:
val x = 10 // В JVM байт-коде разрешены записи в такую переменную, но Kotlin компилятор не сгенерирует такой байт-код


C лямбдами поинтереснее:
var dessert = Dessert() // создается обертка ObjectRef, которая внутри хранит объект как element поле

val lambda = {
// под капотом будет objectRef.element = Dessert()
dessert = Dessert()
}

При создании лямбды ссылка на объект копируется, а это значит если в dessert присвоить другой объект, у лямбды будет ссылка на старый, поэтому var переменные оборачиваются в специальные классы ObjectRef, IntRef и тд.

Ну и вообще проверки Kotlin компилятора и JVM верификатора не означают что val переменные / поля нельзя изменить, всегда есть механизм рефлексии и вызов Си / C++ кода через JNI.
  • 👍 26
  • 🔥 7
Post #134 1.66K
Возвращение

Прошло уже полгода с последней записи на канале.
За это время в моей жизни произошло немало событий — что-то поменялось в лучшую сторону, где-то я совершил кучу ошибок, а какие-то вещи вообще не изменились. Но, как говорится, главное — голова осталась на месте)

Теперь я готов вернуться к тому, ради чего когда-то создал этот канал — разбору внутрянки Android / Kotlin / JVM.
Так что заготавливайте самые вкусные десерты 🍰
Будем разбирать их по кусочкам (про внутрянку тоже не забудем).

Поехали! 🚀
  • ❤ 46
  • 🎉 18
  • 🔥 7
Post #133 3.18K
Пару фактов о Go, часть II.

4) Вместо Kotlin Nullability указатели как в С/C++, то есть обычные переменные не могут быть nil, только указатели:

// проинициализируется нулем
var number1 int

// будет nil
var number2 *int

type Config struct { ... }

// все поля структуры проинициализируются дефолтными значениями
var config1 Config

// будет nil
var config *Config


Полезно использовать указатели для ответов бэка, так как в конечном итоге данных может не быть (nil).

5) Работа с массивами самая базовая, без кучи крутых и полезных функций, как в Kotlin:

var numbers = []int{ 1, 2, 3 }

// вместо функции map нужно писать цикл
for i, num := range numbers {
numbers[i] = num * 2
}

var filtered = []int {}
// вместо функции filter также надо писать цикл
for _, num := range numbers {
if num > 2 {
filtered = append(filtered, num)
}
}

// функция contains имеет похожий аналог
slices.Contains(1, numbers)


6) Очень просто начать писать бэк, буквально 10 строчек и первый запрос готов:

func games(
w http.ResponseWriter,
_ *http.Request
) {
w.Write([]byte("OK!"))
}

router := mux.NewRouter()

router.HandleFunc(
"/games",
games
).Methods("GET")

http.ListenAndServe(
":8080",
router
)


В добавок легко начать работать с файлами и базой данных.

P.S. Что скажите по поводу мерча "наклейки с ГАЗ 21" ? Пишите свое мнение в комментах.

Хорошего дня и поменьше заморачивайтесь!
  • 👍 10
  • 🔥 3
  • 😴 2
  • ❤ 1
Post #132 3.05K
Пару фактов о Go, часть I.

1) Нет объектов и классов, только структуры и функции. Если сравнивать с Kotlin то код в Go по большей части статические функции, а для реализации "методов класса" используется следующий подход:

type Validator struct {
...
}

// на что-то похоже...
func (vl *Validator) Validate(token string) bool {
return vl.GoogleValidator.Validate(token)
}

var validator = Validator { ... }
validator.Validate("google666")


Такой синтаксис чем-то напоминает Kotlin Extension функции, только в отличии от Kotlin в Go это единственный способ соотнести структуру с функцией.

2) Нет модификаторов доступа. Тут все чертовски просто, чтобы сделать private в пределах файла надо написать имя функции / структуры с маленькой буквы:

package games

// доступен только в текущем файле
type request struct {
...
}

// тоже доступен только в текущем файле
func writeResponse(...) { ... }

// можно получить в любом месте
func GamesEndpoint(...) { ... }


Для функций еще ок, а вот для названий структур мне лично такое не по душе, так как постоянно ассоциируешь структуру с классом, поэтому я всегда писал с заглавной, а проблему одинаковых имен решал разными названиями пакетов.

3) Функции могут возвращать несколько значений:

func Open(driver, source string) (*DB, error) { ... }

// знак равенства вместе с двоеточием := означает что одновременно объявляем переменную и кладем в нее значение
db, err := sql.Open(...)
if err != nil {
return
}

// объявление переменной
var result sql.Result
// без двоеточия : так как тут только запись значений в переменные
result, err = db.Exec("DROP TABLE games")


Возвращать несколько значений полезно для обработки ошибок, так как второе значение всегда будет напоминать о себе при вызове, но прям увлекаться этой фичей не стоит.

P.S. Спрашивали в комментах про Волгу, с ней все хорошо, прокатился на Новый год вокруг дома, прекрасно работает, так что фоточки и видосы еще будут.

Всем хорошего настроения!
  • ❤ 13
  • 👏 6
  • 🔥 5
  • 👍 1
Post #131 2.66K
Всем привет, еще в феврале этого года я начал один Pet проект на Compose Multiplatform, давно хотел попробовать эту технологию. Начал со всяких экранчиков и навигации между ними, добавил мультиплатформенные приколы по типу буфера обмена, камеры, галереи, а потом захотелось прикрутить какой нибудь простой бэк, тут как раз узнал про Go, ну и понеслось...

...Скачал компилятор Go и запилил первый запрос, проверил в Android прилке, все работает, прикрутил MySQL для хранения данных, стало еще круче, теперь практически полноценное мобильное приложение!

Но как говорится локально неплохо, а нелокально еще лучше, буквально в этом месяце взял облачный сервак и задеплоил бэк на Go вместе с БД на MySQL, подробнее что за проект, ссылочка на apk и тд, все будет в следующем году.

По итогу работы над проектом материала накопилось очень много, так что в следующем году точно есть о чем черкать посты...

Всех с Наступающим / Наступившим / или Прошедшим Новым Годом!!!
  • 🔥 41
  • 👍 17
  • ❤ 1
Post #130 3.15K
Любая крутая штука в моей жизни чаще всего появлялась когда я сам начинал что-то делать, взять мой канал, я просто начал писать технические посты, кому то это начало заходить, заинтересованные люди начали подписываться и я такой, окей, буду еще черкать текст, как говорится бумага не тратится и с деревьями все хорошо) А все начиналось с текста из сохраненок телеграма...

Конечно это все очевидно и банально: ничего не делать - ничего не будет, но почему то самые банальные вещи не кладутся в переменные, они просто забыты как старая дока. Поэтому если вы что-то хотели сделать в этом году, но почему то решили перенести на следующий, начинайте прямо сейчас: пишите статьи, выступайте, пилите канал, повышайте зп, главное начать! А там уже посмотрим что будет, если сделаете свой "Google" не забудьте про тех кто вас вдохновил)

Кстати я сейчас задумался почему желаю всем хорошего кода, если это понятие в принципе неоднозначное и слишком субъективное, наверно потому что это призыв к изменениям, ведь хорошего кода нет, есть только возможность решить задачу оптимальным путем и делать это с каждым разом эффективнее, корректируя свои навыки.

Ну что ж, хорошего кода наверно на сегодня хватит...
  • 🔥 35
  • 🫡 7
  • ❤ 3
  • ❤‍🔥 1
Post #129 3.1K
Хэш-таблицы, часть II.

В прошлом посте был показан механизм работы хэш-таблицы, который состоит в вычислении индекса массива с помощью так называемой хэш функции:

val index = hash(key)
// хэш таблица под капотом является обычным массивом
hashMap[index] = value

// хэш-функция вычисляет индекс практически моментально
fun hash(...) { ... }


К сожалению не все так просто и хэш функции порой возвращают один и тот же индекс для разных ключей, это называется коллизией, есть несколько вариантов как их разрулить:

1. Затирать предыдущие значения

Это может быть полезно в кэшировании, где данные не прям важны, но все должно работать моментально.

2. Использовать дополнительные структуры данных

Как раз текущая реализация хэш-таблицы в Kotlin (JVM таргет) и Java юзает этот вариант: при возникновении коллизии, создается связанный список куда кладутся все значения с одинаковым индексом, если возникнет ситуация когда список стал очень большим (плохая работа хэш-функции, неправильное переопределение hashCode и тд), на его замену приходит красно-черное дерево.

3. Использовать специальные алгоритмы

Почему бы в случае коллизии просто не попытаться использовать другой индекс:

// i это номер попытки, к примеру вычислили индекс для ключа3, а там уже есть ключ1, попробовали прибавить некоторое значение, а там ключ2 и так пока не найдется свободное место
val i = 1,2,3

// алгоритм линейного пробирования, просто прибавляем номер попытки (увеличиваем индекс на единицу) пока не найдется свободное место
val nexIndex = index + i

// алгоритм квадратичного пробирования, прибавляем помимо номера попытки еще и степень этой попытки, это увеличивает интервал между коллизиями и лучше распределяет значения по таблице
val newIndex = index + i + i*i


Кстати алгоритм квадратичного пробирования используется в структурах данных AndroidX Collection, вот классная статейка про разбор коллекций из этой библиотеки:
https://habr.com/en/articles/811415

Всем хорошего кода!
  • 🔥 12
  • 👍 2
Post #128 2.74K
Хэш-таблицы, часть I.

Бывают ситуации когда нужно хранить какое-то значение на основе определенного ключа и не просто хранить, а еще иметь возможность быстро его изменить, например это может быть кэш для картинок или загруженных файлов:

// храним картинки в кэше, в качестве ключа используется адрес
val imageCache = mutableMapOf<Uri, Bitmap>()

// храним файлы в кэше, в качестве ключа также используется адрес
val downloadCache = mutableMapOf<Uri, File>()


Для реализации подобной структуры данных часто используется обычный массив, индексы которого вычисляются с помощью хэш функции, отсюда название хэш-таблица:

val images = Array(10) { "" }

val url = "https://images.com/image0"
val image = downloadImage(url)
// за счет практически мгновенного вычисления индекса в хэш-таблице время добавления и изменения значений в среднем составляет O(1)
val index = hash(url)
images[index] = image

fun downloadImage(url: String) { ... }

// простая хэш-функция
fun hash(url: String): Int {
return url.last().digitToInt()
}


В примере достаточно примитивная хэш функция, которая просто извлекает цифру из строки и принимает ее за индекс.

В боевой же реализации HashMap используется другая хэш-функция, а также метод hashCode():

// что-то типо модульного деления, ограничивает индекс до размера массива - 1
int index = hash(key) & (size - 1);

// боевая версия хэш-функции
static final int hash(Object key) {
if (key == null) return 0;

// о переопределении этого метода уже наверно книги есть, короче если он плохо написан индексы будут одинаковые, а это коллизия и ее надо как-то решать
int h = key.hashCode();
// смешивает младшие биты со старшими
return h ^ (h >>> 16);
}


Смешивание младших и старших битов нужно для более равномерного распределения индексов, так как при небольшом размере HashMap старшие биты могут просто обрезаться и не учитываться из-за операции по модулю.

В следующем посте поговорим о коллизиях и способах их решения, короче продолжение следует...
  • 👍 14
  • 😁 2
Post #127
Android under the hood pinned «Что ж пора замутить небольшой закреп по крутым материалам. Полезные статьи: Новые коллекции в Android Kotlin Coroutines под капотом Kotlin Coroutines под капотом: CoroutineContext и CoroutineScope Kotlin Coroutines под капотом: отмена корутин Полезные посты:…»
Post #126 3.6K
Что ж пора замутить небольшой закреп по крутым материалам.

Полезные статьи:
Новые коллекции в Android
Kotlin Coroutines под капотом
Kotlin Coroutines под капотом: CoroutineContext и CoroutineScope
Kotlin Coroutines под капотом: отмена корутин

Полезные посты:
Пару слов о базовой концепции Dagger?
Как вьюшки получают touch события?
Как устроена библиотека Picasso?
Полезные факты о библиотеке OkHttp.
Кратко о реализации пула потоков.
Немного о структуре данных SparseArray.
Немного о JVM.
Немного про iOS.
Как вычислить ближайшую степень двойки числа?
Пару фактов о JVM стэке.
Как работает remember из Jetpack Compose?
Пару фактов о StateFlow и SharedFlow.
Dispatchers.Main под капотом.
Пару фактов о Android контексте.
Как работает compareAndSet?
Рекурсия на основе корутин.
Gradle скрипты.
Виртуальные потоки в Java 21.
Получение реализации интерфейса по имени класса в Kotlin.
Пару слов про CoroutineScheduler.
Как потоку эффективно дождаться следующих задач?
Как устроены LockSupport.park() и LockSupport.unpark() под капотом?
Что такое modCount в ArrayList'е?
Массивы.
ArrayList.
LinkedList.

Полезные Github репозитории:
Kotlin-Algorithms-and-Design-Patterns
AlgoSortingAnimations
A-Little-About-Dagger
DI-internals
Fluently

Поддержка канала: Boost ссылочка
Поддержка автора: Tribute ссылочка
  • 🔥 37
  • ❤ 8
Post #125 2.57K
Стэк и очередь.

Мы уже рассмотрели базовые структуры данных такие как массивы и связанные списки, теперь можем глянуть как на их основе строятся другие, но для начала чуток терминологии:

1) Стэк - структура данных, основанная на принципе LIFO (last in first out), то есть значения добавляются в конец, извлекаются тоже с конца.

2) Очередь - структура данных, основанная на принципе FIFO (first in first out), то есть значения добавляются в конец, а извлекаются с начала. Есть еще очереди с приоритетом, но это немного другая история.

Давайте попробуем построить стэк с помощью динамического массива и связанного списка:

// реализация стэка на динамическом массиве
val stack1 = ArrayList<String>()
// добавляем значение в конец стэка
stack1.add(10)
stack1.add(20)
// извлекаем значение с конца стэка
stack1.removeLast()

// реализация стэка на связанном списке
val stack2 = LinkedList<String>()
stack2.add(10)
stack2.add(20)
stack2.removeLast()


Для очереди практически то же самое:

// реализация очереди на динамическом массиве
val queue1 = ArrayList<String>()
// добавляем значение в конец очереди
queue1.add(10)
queue1.add(20)
// извлекаем значение с начала очереди
queue1.removeFirst()

// реализация очереди на связанном списке
val queue2 = LinkedList<String>()
queue2.add(10)
queue2.add(20)
queue2.removeFirst()


Обе реализации практически идентичны, разве что в динамическом массиве при удалении происходит сдвиг всего массива, а в связанном списке удаляется только ссылка, поэтому в скорости однозначно выигрывает связанный список, особенно это отражается на очередях, где должен извлекаться первый элемент.

Всех с выпавшим снегом, хотя может у вас снега нет, короче хорошего кода!
  • 👍 13
  • 🤔 9
  • 🤣 5
Post #124 2.98K
LinkedList.

Связанный список устроен весьма просто: каждый объект хранит ссылку на следующий кроме последнего:

class Node(
val value: Int,
var next: Node? = null
)

// всегда ссылается на первый элемент
val root = Node(1)

// добавляем в список значения
root.next = Node(2)
root.next.next = Node(3)
root.next.next.next = Node(4)

// у последнего next равен null
root.next.next.next.next // null


Список при этом может быть динамический, так как достаточно хранить ссылку токо на первый элемент, до остальных можно добраться с помощью простого цикла:

// root - ссылка на первый элемент
val node: Node? = root
// цикл для прохода по всем значениям списка
while (node != null) {
// выводим значение элемента
println(node.value)
// идем к следующему
node = node.next
}


В итоге объекты могут храниться в любой части памяти так как в них буквально зашиты адреса на следующие значения в отличии от массивов, где нет подобных ссылок, а навигация происходит по индексам, что и требует последовательного хранения.

P.S. Есть еще двусвязный список в котором помимо ссылки на следующее значение, есть еще ссылка на предыдущее.

Всем хорошего кода!
  • 👍 20
  • 🤣 15
  • 🔥 9
  • ❤ 4
  • ✍ 1
Post #123 3.24K
ArrayList.

Следующая структура данных - динамический массив или как часто его называют в Android разработке - ArrayList.

ArrayList - это самый обычный массив, который при переполнении просто удаляется, а его значения тупо копируются в новый, более вместительный массив, выше на картинке это наглядно продемонстрировано, вообще это очень крутая структура данных, так как сохраняется преимущество массивов - произвольный доступ.

Но и есть недостаток связанный с удалением, к примеру надо удалить значение в самом начале, в ArrayList это реализовано через сдвиг массива на позицию удаляемого значения, то есть чтобы удалить первое значение надо сдвинуть все остальные на одну позицию влево, а это не очень эффективно когда массив имеет приличный размер.

Как альтернативный вариант можно вместо сдвига заменять удаляемое значение каким нибудь пустым, например null, но здесь появляется другой недостаток - при большом количестве удалений пустых мест может быть очень много, а это неэффективный расход памяти.

P.S. Если у вас появилось желание прям досконально разобраться во всей внутрянке ArrayList рекомендую глянуть исходники java.util.ArrayList, там можно найти много интересного.

Всем не хорошего, а замечательного кода!
  • 👍 31
  • ❤ 1
Post #122 3.64K
Массивы.

Начнем с самой базовой структуры данных - массивы, на ней кстати построен всеми известный ArrayList.

Массив - это набор значений одного типа, очень важно что именно одного, то есть массив не может содержать одновременно числа и строки, случай с Any и другими объектами объясняется тем что там хранятся ссылки на объекты, а не сами объекты как например числа, а все ссылки имеют одинаковый размер, то есть можно сказать это один тип.

Идем дальше, как мы знаем массивы позволяют получать значения по произвольному индексу, отсюда название структуры данных с произвольным доступом, давайте подумаем как можно сохранить в оперативной памяти набор значений из которого можно что то взять по произвольному индексу.

Ответ на картинке, мы просто берем кусок памяти, делим его на отдельные кусочки, размер которых равен размеру конкретного типа, например для чисел Int - это 32 бита, для ссылок на Any объекты может быть 32 или 64 бита, в итоге чтобы получить значение скажем из Int массива по индексу 5 надо всего лишь сместиться по памяти на 5 x 32 = 160 битов от начала массива.

В итоге получение значений массива по индексу это очень быстрая операция, так как адреса вычисляются через простое арифметическое умножение, вот и весь прикол массивов.

Всем не хорошего, а замечательного кода!
  • ❤‍🔥 32
  • 👍 25
  • 🥰 5
  • 😱 2
  • 🤗 2
  • 🔥 1
Post #121 3.42K
В последнее время у меня появилось желание сделать некоторую серию постов про алгоритмы и структуры данных в очень базовом и лайтовом формате, что скажите?

P.S. Есть еще одна крутая новость, недавно мы с другими мобильными блогерами собрали крутую папку авторских тг каналов, залетайте:
https://t.me/addlist/Y8vKlay8BuM2OTUy

Всем не хорошего, а замечательного кода!
  • 🔥 77
  • 👍 20
  • 😴 8
  • ❤ 5
  • 💯 1
Post #120 4K
Что такое modCount в ArrayList'е?

Если внимательно присмотреться к исходникам ArrayList'а, можно увидеть инкрементирование переменной modCount при каждом изменении списка:

class ArrayList<E> {

private var modCount = 0

fun add(element: E) {
modCount++
...
}

fun remove(element: E) {
modCount++
...
}

fun clear() {
modCount++
...
}
}


Такая логика нужна для сохранения консистентности данных в случаях когда используются итераторы:

class ArrayListIterator<E> {

...

fun next(): E {
/*
modCount берется из оригинального ArrayList'а

expectModCount инициализируется при создании итератора значением modCount из оригинального ArrayList'a
*/
if (modCount != expectModCount) {
throw ConcurrentModificationException()
}
...
}
}


При создании итератора списка значение modCount сохраняется в переменную итератора expectModCount, если во время итерирования коллекции вы измените список ArrayList, переменная modCount инкрементируется и перестанет равняться переменной итератора expectModCount, в итоге следующий шаг итератора выбросит исключение ConcurrentModificationException.

Таким образом при итерировании коллекции гарантируется что ваши данные случайно не изменятся обходными путями и количество неявных багов будет сведено к минимуму.

P.S. Если вам нужно менять ArrayList во время итерирования делайте это через ListIterator, специальный итератор который умеет перемещаться в обеих направлениях и изменять список.

Пишите в комментах что думаете и всем хорошего кода!
  • 👍 29
  • 😁 3
Post #115 3.23K
Первая машина.

Буквально год назад я не интересовался машинами от слова совсем, но в один из прекрасных октябрьских дней 2024 года я скачал игру Forza Horizon 4 и тут понеслось: сначала я просто гулял по городу и разглядывал марки и модели машин, затем начал интересоваться технической стороной, какие бывают двигатели, приводы, топливные системы и всякое такое, ну и все это вылилось в то что я получил права и купил свою первую машину, как раз ей я хотел бы посвятить этот пост.

Те кто шарит уже наверно по фоткам поняли что это легендарное произведение искусства ГАЗ 21 Волга, да она самая и я безмерно восхищен тем что взял ее, более того я пообещал самому себе что ни за какую цену не продам ее, будь это хоть 10 кусков зелени или даже 100, не имеет значения.

Ну а теперь парочку фактов о ней:

1) Такая же большая как и современные внедорожники как по габаритам так и по массе, только в отличии от них у нее нет усилителя руля, парковочных систем, камер и даже боковых зеркал, ну и слабоватые тормоза, поэтому приходится тормозить двигателем и прям владеть габаритами!

2) Механическая коробка передач на руле, это весьма нестандартный способ управления, в добавок данная коробка не имеет синхронизаторов для 1-ой и задней передач, другими словами если вы включили вторую передачу, то на первую будет очень сложно попасть на ходу, в большинстве случаев приходиться полностью останавливаться.

Для сравнения: сейчас большинство новых машин делают на автоматической коробке, а тут не просто механика, а еще нестандартная.

3) Карбюраторный двигатель, чтобы запустить его надо открыть воздушную заслонку (специальная кнопочка в салоне) и накачать топливо в карбюратор, а при прокручивании ключа зажигания еще подгазовывать если двигатель холодный.

Для сравнения: сейчас практически все автомобили ездят на инжекторах, это системы основанные на компьютере, поэтому ничего качать и нажимать не надо, токо повернуть ключик зажигания.

4) Ламповое радио (радио на лампах), это те самые радиоприемники из СССР, которые звучали так что слышно было на других континентах, к сожалению 65 лет назад радиочастоты были другие, поэтому очень сложно что то поймать(

5) Очень мягкая подвеска, форточки в дверях, вместо сидений кожаный диван (впереди могут сидеть 3 человека), который раскладывается в большую кровать, ну и не нужно пристегиваться так как данная машина не предусматривает ремни.

6) Ну и напоследок шикарный стиль по типу американских автомобилей 50-х.

Пишите как вам моя красотка?
  • ❤ 35
  • 🔥 20
  • 🤣 14
  • 🤯 12
  • 🥰 2
Older posts →

About this channel

How can I read @android_under_the_hood without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Android under the hood: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Android under the hood have?
Android under the hood (@android_under_the_hood) has 1.53K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Android under the hood know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →