TGViewer
Channel Public Channel
Мир аналитика данных

Мир аналитика данных

@analysts_world

Пишу о рабочих буднях аналитика. Тут много рабочего кода, прохождение собеседований и еще много всего полезного.
https://www.linkedin.com/in/valeriashuvaeva
Автор канала: @Valeria_Shuvaeva
Subscribers
4.56K
Photos
143
Videos
3
Links
114

Showing posts older than #151 · Back to latest

Older Posts 20 shown
Post #149 3.87K
💬 Консультируя людей, я часто слышу вопрос: "Какой курс выбрать для перехода в IT?"

Хочу поделиться своими рекомендациями так как многие люди тратят деньги и время на неподходящие курсы, которые не приносят желаемых результатов.

1️⃣ Избегайте длинных годовых курсов без соответствующего бэкграунда:

❌ Если у вас нет опыта в IT, выбирайте краткосрочные и целенаправленные курсы. Годовые программы могут быть пустой тратой времени и денег.

❌ Работодатели не всегда обращают внимание на ваши курсы, особенно если они не соответствуют вашему предыдущему опыту.

2️⃣Рассмотрите ваш текущий опыт и его применимость:

❌Если вы находитесь в декрете, долго не работали или работаете в областях, не связанных с IT (медицина, юриспруденция, наука, морская индустрия, консалтинг и т.д.), начните с основ.

❌Например, если вы не работали хотя бы с Excel, ваш путь в IT должен начинаться с базовых знаний.

➡️ Как проверить свою гипотезу? Создайте тестовое резюме.

❌Включите в него тот курс, который вы планируете пройти, и посмотрите на отклики работодателей.

❌Если интереса нет, то, вероятно, пройдя курс, вы не получите ожидаемого эффекта и ваше резюме останется незамеченным.

3️⃣С чего начать:

❗Изучите Excel и SQL:

❌Много бесплатных курсов доступно онлайн. Начните с основ и поймите, нравится ли вам это направление.

❌Попробуйте откликаться на вакансии, требующие знания Excel. Если будет упоминание SQL — это плюс.

❗Поиск вакансий начального уровня:

❌Ищите вакансии, где требуется аналитическая работа: сбор данных, работа с таблицами и т.д.

❌Это может быть аналитик в отделе продаж, помощник для маркетплейса, координатор онлайн-школы — любые должности, требующие знаний Excel.

❗Доступ к базам данных:

❌Работая в этих должностях, стремитесь получить доступ к базам данных и попрактиковаться с SQL-запросами.

Постепенное освоение навыков значительно повысит ваши шансы на успешное трудоустройство! А уже с приобретением опыта вы сможете продвигаться дальше и продолжать развивать свои способности.

Удачи! 🚀📈😊
  • 🔥 40
  • ❤ 12
  • 😍 2
  • ⚡ 1
  • 💯 1
Post #148 3.57K
🔈Мне написали из Центра научной коммуникации Университета ИТМО и попросили выложить пост с опросом. Дело полезное и нужное, так что выкладываю.

Центр научной коммуникации Университета ИТМО проводит анализ профессионального сообщества ML- и DS-специалистов в России. Мы хотим узнать больше о том, как устроена профессиональная коммуникация в вашей сфере, кого вы считаете лидерами рынка на данный момент.

Ваше участие поможет нам сформировать полную картину современного состояния индустрии. Мы гарантируем полную анонимность и конфиденциальность ваших ответов.

Опрос займет не более 10 минут вашего времени.

Ссылка на анкету: https://forms.gle/dHRsqQJteuty51Bp7

p.s. Я погуглила университет. Оказалось, что это национальный исследовательский университет, основанный в 1900 в Санкт-Петербурге. Это вам не игры. Тут все серьезно.
Таким помогать - одно удовольствие. 💪
  • ❤ 11
  • 👍 6
  • 😁 1
Post #146 3.68K
🎉 Сохраняем порядок строк при объединении датафреймов в Pandas! 🎉

Привет, друзья! Сегодня я расскажу вам, как правильно объединить два датафрейма и при этом сохранить порядок строк первого! 🧩⬇️

👉 Для этого мы используем df.index, чтобы порядок строк из первого датафрейма оставался неизменным, а из второго добавляем нужные данные. 💼📈
📄 Пример кода:

Набросаю пару таблиц, на которых будем экспериментировать.

import pandas as pd

# Первый df
df1 = pd.DataFrame({
'account_id': [1, 2, 1, 3, 4],
'value_df1': [10, 20, 30, 40, 50]
})

# Второй df
df2 = pd.DataFrame({
'account_id': [1, 2, 3, 5],
'value_df2': ['1 from df2',
'2 from df2',
'3 from df2',
'5 from df2']
})


Добавим индексный столбец к исходному датафрейму.

df1['original_index'] = df1.index


Объединяем датафреймы:
df_merged = pd.merge(df1, df2, on='account_id', how='outer')

Видим, что строки левой таблицы идут сначала не в нужном нам порядке.

Сортируем по исходному индексу:
df_merged = df_merged.sort_values(by='original_index').reset_index(drop=True)


Удаляем вспомогательный индексный столбец, если он больше не нужен
df_final = df_merged.drop(columns=['original_index'])


🔍 И получаем результат: df_final. Смотрим картинку с поэтапным процессом. Специально разбито все по частям, чтобы отследить результат.

С помощью этих шагов мы сохраняем порядок строк из первого датафрейма и добавляем нужные данные из второго. 🚀✨
  • 🔥 32
  • ❤ 6
  • 🍓 2
Post #145 5.39K
📊 Новая Задачка с Работы

Недавно столкнулась с интересной задачей. У каждого клиента client_id есть параметр - подсчет чего-либо. Назовем эту колонку count.
✅ Быстренько создадим датафремчик с примером:
import pandas as pd

data = {
"client_id": [111, 222, 111, 333, 333, 444, 444],
"info": ['AAA', 'AAA', 'BBB', 'CCC', 'DDD', 'DDD', 'EEE'],
"count": [10, 1, 9, 8, 6, 0, 1]
}

df = pd.DataFrame(data)


🎯Нужно для каждого клиента найти максимальное значение в колонке count с помощью метода idxmax.
Казалось бы, можно использовать просто max(), но есть нюансы.

✅Группировка и нахождение индексов с максимальным значением.
Группируем по client_id и находим строки с максимальным значением count для каждой группы (client_id).
idx = df.groupby('client_id')['count'].idxmax()


✅Фильтрация: Используем эти индексы для фильтрации исходного DataFrame, оставляя только строки с максимальными значениями count для каждого client_id.

df_filtered = df.loc[idx] #выбирает строки по индексам из idx.


Результат - df_filtered видим на картинке.

❓ А теперь поясню про вариант с max():
Да, задачу можно решить с помощью функции max() при группировке. Этот подход подходит для нахождения максимального значения count для каждого клиента, но не возвращает строку полностью! А мне нужно было видеть всю инфу по строке, так как там много колонок было.

df.groupby('client_id',as_index=False)['count'].max()


Эта строчка кода вернет только две колонки: client_id и count

Смоделируем бизнес ситуацию, где такое можно было бы использовать:

🛍 Вы работаете в розничной сети, которая имеет программу лояльности для своих клиентов 🛍. Клиенты могут иметь несколько аккаунтов (например, основной аккаунт и семейные аккаунты). В каждом аккаунте фиксируется активность клиента (покупки, участие в акциях и т.д.). Вам необходимо анализировать наиболее активные аккаунты для предоставления специальных предложений и акций.

Вот такой интересный случай из практики 🤪
  • ⚡ 34
  • 👍 17
Post #144 4.08K
✅ Всем привет!

Я участвую в классной инициативе с другими аналитическими каналами! 📊 Андрон из Simulative обратился ко мне с предложением добавить этот канал в специальную папку. Всего участвуют 15 каналов, где эксперты делятся своим опытом и знаниями. На большинство из них я уже была подписана, поэтому сразу согласилась.

Здесь представлены каналы про Data Science, «хардовые» советы для аналитиков 🖥, каналы о развитии софт-скиллов 🌟, а также каналы про визуализацию. 📈 То, что в подборке есть каналы Бабушкина и Михайлова, уже говорит о многом. Эти ребята действительно крутые! 💪
Ссылка на папку: https://t.me/addlist/dMeiok8FCdA3ZTMy

Мне для обзора выпал канал Юрия Борзило https://t.me/y_borzilo, который я давно знаю и очень рекомендую всем, кто интересуется аналитикой! Юра – действующий продуктовый аналитик, и у него много информации про А/Б тесты.

Вот подборка его постов про А/Б тесты за год: https://t.me/y_borzilo/477

Признавайтесь, у кого есть опыт A/Б тестов? В одном из постов Юра писал о двух крайностях:
1️⃣ Давайте ничего не будем АБ тестировать.
2️⃣Давайте АБ тестировать вообще все.

Как всегда, нужна золотая середина. Сам по себе этот инструмент не хороший и не плохой, но у него есть ряд ограничений, которые надо учитывать при применении.

Сейчас так много информации, что учиться и совершенствовать свои навыки стало проще, чем когда-либо. Правда, со временем всё так же сложно 😂
Telegram Борзило ⇨ Про аналитику, продукты, маркетинг ⇨ Автор курса по АБ тестам ⇨ Смело пиши - @borzilo_y ИНН 026702638983
  • 👍 18
  • 🔥 5
  • ❤ 2
  • 😁 1
  • 🆒 1
Post #142 4.38K
🤖 У нас теперь есть бот для анонимных сообщений!

Если у вас есть вопросы или что-то, чем вы хотите поделиться, но не хотите раскрывать свою личность, просто напишите боту. Я постараюсь честно ответить (если это не будет под NDA) или как-то прокомментирую.

🗝 Пишите сюда: t.me/anonaskbot?start=UwPGvL1G1RVzcgu

У меня много кода в блоге, но иногда хочется и порассуждать. 🤪
  • 👍 4
  • ❤ 1
Post #137 3.39K
👋 Друзья, я вся погружена в работу над курсом для SF, поэтому времени на посты почти не остаётся. Но вот этим не могу не поделиться! 🚀

Недавно я наткнулась на интересную задачу и решила показать решение, которое, надеюсь, будет полезно многим из вас.

Надо было сгруппировать данные в DataFrame по колонке account_id и объединить значения из колонки type через запятую.
У меня были разные типы оплат у аккаунтов, и нужно было показать, какие типы использует каждый аккаунт.
Вот как это сделать с помощью pandas:
import pandas as pd

# Создам DataFrame для примера
data = {
'account_id': [1, 1, 2, 2, 3, 3, 3],
'type': ['A', 'B', 'A', 'C', 'B', 'A', 'D']
}
df = pd.DataFrame(data)

# Сгруппируем данные по колонке 'account_id' и объединим значения колонки 'type' через запятую
df_grouped = df.groupby('account_id')['type'].apply(','.join).reset_index()
# Переименую колонку для красоты
df_grouped.rename(columns={'type': 'type_combined'}, inplace=True)


Давайте разберёмся, что здесь происходит.

📌 Группировка данных по account_id. Из каждой группы выбираем значения колонки type.
df.groupby('account_id')['type']


📌Применение функции apply с join. Мы объединяем все значения type в каждой группе в одну строку, разделяя их запятыми.
.apply(','.join)


📊 Таким образом, значения из колонки type сгруппированы по account_id и объединены через запятую в новой колонке type_combined. 🔍

Надеюсь, вам это пригодится! ✨
  • 👍 29
  • ❤ 5
Post #136 3.42K
🎉 Радостные новости! 🌟 Я стала автором курса по аналитике у SkillFactory! Это не только новый этап в моей карьере, но и захватывающий вызов, который я с радостью принимаю. Буду успевать все совмещать 🤪

В связи с этим новым начинанием, я приняла решение отменить текущий поток обучения. Мне очень жаль, что приходится его отменять. Хотелось бы всё успевать, но физически это оказывается непросто.
  • 👍 28
  • 🔥 19
  • ❤ 6
  • 🆒 4
Post #135 3.3K
🔍 Рабочая задача: Анализ данных с регулярными выражениями в Python

🙌 Недавно мне попалась интересная задача на работе, связанная с обработкой текстовых данных. Расскажу, как я это сделала, чтобы вы тоже могли попробовать!
Попросили вытащить из колонки параметров в базе одну цифру, которая следует за словом type. У данных тип object, слов разных технических там много.

Я воспользовалась регулярным выражением. Все таки регулярки - это мощь! 💪
import pandas as pd
import re
# Создам образец, чтобы можно было скопировать
data = {
"params": [
"example type:1 with text type:11",
"another type:2 sample",
"more text type:3 here",
"type:4 is also included",
"and a final type:5 example"
]
}
df = pd.DataFrame(data)


А теперь пишем функцию, которую можно будет в apply запихнуть.
def find_numbers(text):
pattern = 'type:\s*(\d+)' # Это шаблон для поиска
numbers = re.findall(pattern, text) # Ищем все совпадения
return numbers


В отдельной колонке будут записаны числа после type, даже если их несколько (смотрите на картинке )

df['type']= df['params'].apply(find_numbers)


🔑 Расшифрую
⏩ re.findall ищет все совпадения, что позволяет надежно извлекать числа, даже если их несколько в одной строке.

⏩pattern = 'type:\s*(\d+)'
\s* или \s обозначает любой пробельный символ (пробелы, табуляции, новые строки и т. д.), а * означает "ноль или более" таких символов. Это означает, что между двоеточием и значением может быть любое количество пробелов или даже их отсутствие.

(\d+) - \d означает любую цифру, а + говорит о "одном или более" вхождении. Скобки () используются для группировки выражения, чтобы можно было извлечь только интересующую нас часть (т.е. сами цифры, а не кавычки или пробелы вокруг них).
  • 👍 17
  • ⚡ 6
  • 😁 3
Post #134 3.07K
🚀 Анализ Поисковых Запросов в Яндекс.Метрике

Продолжаю изучение Яндекс.Метрики и делюсь выводами:

🔍 Кто посещает сайт?

География: Основная аудитория из России, но были случаи и из Аргентины!
(Отчеты - Аудитория - География.)
Пол: Преобладают женщины.
(Отчеты - Аудитория - Пол. )
Возраст: Большая часть — это люди в возрасте 25-34 года.
(Отчеты - Аудитория - Возраст. )

🔍 Откуда приходят посетители? Отчеты - Источники - Поисковые запросы

Этот отчет предоставляет информацию о том, какие конкретные запросы пользователи вводили в поисковые системы (например, Яндекс или Google), которые впоследствии привели их на ваш сайт. Изучение этих данных помогает адаптировать контент под популярные запросы и улучшить SEO. Например, слова "собеседование", "питон", "пандас" и "аналитика" часто приводили пользователей на мой сайт в Дзене.

📊 Зачем это нужно?

Инсайты и SEO: Понимание популярных запросов и оптимизация сайта под них помогает улучшить видимость в поисковиках и сделать контент релевантным для аудитории.
Улучшение сайта: Анализ запросов позволяет совершенствовать навигацию и структуру сайта, делая его более удобным для пользователей.

🚀 Пример использования данных:
Если вы обнаружили, что многие пользователи ищут "лучшие способы сохранения данных", можно создать соответствующий контент, который не только отвечает на их запросы, но и повышает лояльность аудитории.
Мне, походу, надо сосредоточиться на статьях с разбором тестовых 🙂

✅Открытый доступ к статистике:
Хочу предоставить Вам возможность самостоятельно ознакомиться с отчетами и статистикой. Я сделала доступ к моему счетчику открытым!

Используйте эту ссылку: https://metrika.yandex.ru/dashboard?id=96707090 😮
Пользуйтесь на здоровье!
  • 👍 9
  • 🔥 4
  • ❤ 3
  • 👎 1
Post #133
Мир аналитика данных pinned «☝️🔈 Важное объявление для тех кто хочет попасть на .. последний поток по SQL и Python! Заявка на мой курс тут. 🎓 Подошел к концу текущий поток моего обучающего курса по SQL и Python(Pandas). Я сама не верю, что провела уже два потока. Когда я писала этот…»
Post #132 3.13K
☝️🔈 Важное объявление для тех кто хочет попасть на .. последний поток по SQL и Python! Заявка на мой курс тут.

🎓 Подошел к концу текущий поток моего обучающего курса по SQL и Python(Pandas). Я сама не верю, что провела уже два потока. Когда я писала этот курс, то потратила огромное количество сил и энергии и когда вела его, то тоже старалась много отдать, быть на связи, помогать даже с резюме и отвечать на разные вопросы иногда даже просто "за жизнь".

Это крутое время, проведенное вместе! Тем не менее, как говорится, "все хорошее - когда-то заканчивается". И вот, я хочу объявить, что сейчас будет последний поток в обозримом будущем, так как летом я буду занята собственным обучением и проектами.

🚀 Так что стартует набор на крайний поток обучения!

📅 Дата потока открытая. Начнем, как только наберется достаточное количество участников.

👨‍💻👩‍💻 Если вы хотите присоединиться к потоку и расширить свои знания SQL и Python, не упустите эту возможность! Присоединяйтесь к нашей группе и начнем это захватывающее образовательное путешествие вместе!

🌟 Спасибо за ваш интерес и участие! Многие просили программу обучения. 🤪 Подробная программа, вот она. Там в конце еще отзывы есть.
Оставляйте заявку в гугл-форме на курс, ну или пишите напрямую @Valeria_Shuvaeva
  • 👍 8
  • ❤ 4
Post #130 3.13K
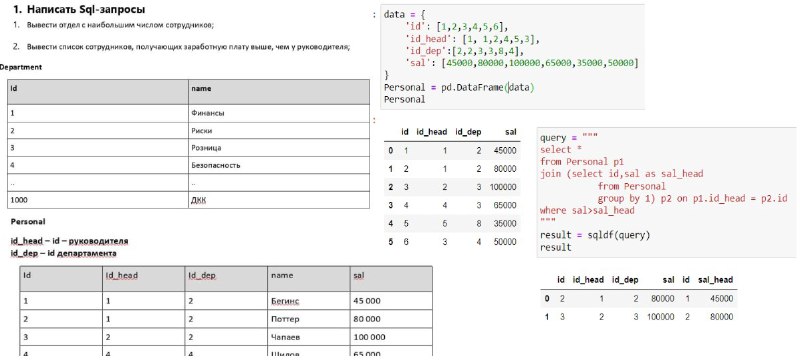
✅ Тестовое. Задачка по SQL. Просматривала я аналитические каналы и вижу интересное тестовое. У меня мозг на автомате начал накидывать варианты и уже прям не терпелось написать скрипт.
Думаю это будет полезным для всех.

Итак, есть две таблички: с отделами и данными по зарплате у сотрудников и их начальников.
Создадим быстренько датафреймы, на котором потренируемся прям в юпитер ноутбуке с помощью библиотеки pandasql. Про эту библиотеку пост тут.
data = {'id': [1,2,3,4,5,6],
'name': ['Финансы','Риски','Розница','Безопасность','ДКК','Аналитика']}
Departament = pd.DataFrame(data)


data = { 'id': [1,2,3,4,5,6],
'id_head': [1, 1,2,4,5,3],
'id_dep':[2,2,3,3,8,4],
'sal': [45000,80000,100000,65000,35000,50000] }
Personal = pd.DataFrame(data)


📌Задание 1. Вывести отдел с наибольшим числом сотрудников.
Самый простой способ:
select d.name as Department, 
count(p.id) as count_personal
from Personal p
join Departament d on d.id = p.id_dep
group by 1
order by 1 desc
limit 1


Но в случае если у нескольких отделов одинаковое количество сотрудников, то результат выдаст один отдел, а не два.
Поэтому рекомендую сделать второй вариант через подзапрос. Можете потренироваться - написать сами.

📌Задание 2. Вывести список сотрудников, получающих заработную плату выше, чем у руководителя. Вот тут уже интересненько.

Это можно реализовать соединив таблицу с этой же модифицированной таблицей. Сделаем табличку с помощью группировки, чтобы был уникальный сотрудник и его з/пл. И присоединим ее с помощью left join к основной по ключу p1.id_head = p2.id.
Тогда в одной строке будет и з/пл сотрудника и з/пл его руководителя. И потом оставляем тех, у кого sal>sal_head
select p1.id
from Personal p1
join (select id,sal as sal_head
from Personal
group by 1) p2 on p1.id_head = p2.id
where sal>sal_head


📎 Тут ноутбук с решением.
  • 👍 16
  • 🔥 8
  • 🆒 2
Post #129 2.75K
Ну что, пришло время посмотреть на результаты Яндекс-метрики в Дзене.🔍

Так как в основном, как я предполагаю, Вы смотрели статьи по моей просьбе, то это должно быть видно в каком-то отчете. Такой отчет есть. Он называется "Отчет по источникам" и находится: Отчеты-> Источники-> Источники, сводка. Тут видно по источникам откуда приходят люди.

Какие же существуют источники? Сначала рассмотрим тот, через который пришли Вы:

✔️ Прямые заходы. Это Вы и те, кто заходил по прямой ссылке.(рис.2) Смотрим картинки здесь. Там можно и весь пост прочитать тоже.

Смотрим базовые числовые метрики, которые присутствуют почти в каждом отчете. Именно с них всегда начинается анализ:

🎯Метрика "Визиты". Видно по графику, что 21го марта, когда я опубликовала пост был пик заходов, а всего было их 11 (визитов).

🎯Метрика "Посетители" - уникальных посетителей тут тоже 11, то есть заходил не один и тот же человек, а разные люди.

🎯Метрика "Отказы" показывает, что если человек провел на сайте меньше 15 секунд, то это будет считаться отказом. По этой метрике видно нравится контент аудитории или она заглядывает и сразу уходит.

🎯Метрика "Глубина просмотра" - количество страниц, просмотренных посетителем во время визита.

🎯Метрика "Время на сайте" - сколько всего времени человек провел на сайте. или средняя продолжительность визита в секундах.

✔️ Переходы по рекламе. Здесь нет такого, но если бы я запускала рекламную кампанию, то смотрела бы здесь - есть от нее толк или нет.

✔️Переходы из поисковых систем - люди могут переходить из органики. Органика — это природный нативный трафик, привлеченный из сайтов. Посетители приходят в такие источники “естественным” образом, в основном, из поиска. На мою страничку вышли из Яндекса (6 человек) и Гугла (1 человек). (рис.3)

✔️ Переходы по ссылкам на сайтах. У меня нет нигде ссылок на каких-то сторонних сайтах, поэтому тут виден только Дзен.

✔️ Переходы из рекомендательных систем. Дзен сам рекламирует свои статьи и мы видим, что метрика Визиты показывает сколько было визитов.

Если мы нажмем значок % рядом с метрикой Посетители, то увидим, что прямые заходы составляют 50% , что логично. Основные посетители - Вы и есть. (рис.4)
Можно посмотреть посетителей на типе графика "Круговая диаграмма". Выбираем наверху кружочек. (рис.5)
В отчете по идее должно быть 50% как показано выше (11/22), а тут 47,8% - это 11/(11+7+4+1)
Почему-то в "Итого и средние" показывается 22, а не 23. Кто знает, скажите почему. ❓

Тут можно смотреть не только визиты, а еще и выбрать цель. У меня это просто Посещение, а в настоящем сайте-магазине это может быть заполнение заявки на покупку чего-либо. И тогда мы видим слово перед которым трепещут все аналитики: конверсия. (рис.6)

Тут для нас конверсия - это доля целевых визитов в общем числе визитов. Цель тут была просто посещение страниц. Поэтому для прямых заходов получаем конверсию 0,909 = 10 целевых визитов/11 визитов(тут не видно, смотрим в прошлом отчете) 0,909*100 = 90,9%

Отчетов там много, так что
🔠🔠 🔠🔠 🔠🔠🔠🔠🔠🔠🔠🔠🔠
Telegraph ЯНДЕКС - МЕТРИКА Мир аналитика данных | Дзен (dzen.ru)
  • ❤‍🔥 11
  • ⚡ 3
  • 🏆 2
  • 🍓 1
Post #128 2.78K
Я давно вынашивала идею поиграться с Яндекс-метрикой. 📊 Это и полезно, и интересно.

Если создать свой сайт, то можно ее прикрутить к нему. Но сайт создавать хоть и не очень сложно, но времени потребуется все равно небольшой вагон много. И тут меня осенило! А можно ли к статьям в Дзене прикрутить счетчик метрики? Оказывается – ДА, МОЖНО!

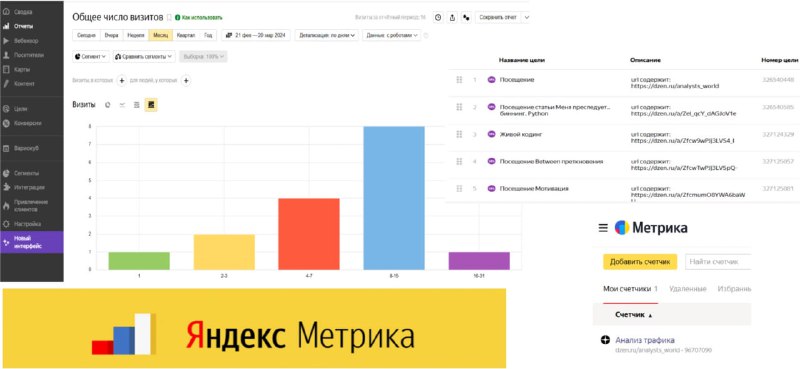
Я зашла на Дзен, создала там свой канал. И в нем написала несколько статей. Потом зашла на https://metrika.yandex.ru/ и добавила там счетчик. Задала ему имя Анализ трафика.

В поле с адресом сайта, который мы будем анализировать, вбила адрес канала с Дзена: dzen.ru/analysts_world и нажала сохранить.
Потом я добавила цели. Они позволяют отслеживать важные события на сайте: клики на кнопки, просмотры определенных страниц, скачивание файлов, отправку форм и многие другие.
Я выбрала только посещение страниц и в условие добавила опять ссылку на канал. Однако, мне этого показалось мало. Вдруг посетители зайдут сразу на статью, минуя канал, и я создала еще несколько целей – и там указала посещение именно статей. Можете увидеть на скрине.

Вот теперь счетчик готов! 🕯 У него есть номер ( мой с номером 96707090) Теперь осталось прикрутить его к Дзену! Несите отвертку!
В настройках канала есть раздел Веб-аналитика. И там можно вбить номер вашего счетчика в поле Яндекс.Метрика.
Все! Теперь можно отслеживать посещения страниц. 📈 Буду вам показывать какие отчеты там есть и что интересного можно узнать. Полазайте там по страницам, чтобы было что исследовать. 🎮
➡️ https://dzen.ru/analysts_world

Если у вас есть опыт, какие-то идеи как создать какой-то отчет, то пишите сюда или мне в директ - будем экспериментировать и делиться знаниями.
  • ❤‍🔥 20
  • 👍 10
  • ❤ 9
  • ✍ 5
  • 🔥 3
Post #127 3.06K
Первый раз столкнулась с шифрованием.

Попросили сделать номера телефонов хешированными. Ну, я полезла смотреть как это. Короче, вот вам нарытая инфа:

Что такое вообще это ваше хеширование. ❓ Это преобразование информации с помощью особых математических формул. В результате возникает хеш — отображение данных в виде короткой строки, в идеале — уникальной для каждого набора информации. Размер строки может быть одинаковым для информации разного объема.

Причем хеш-функций существует очень много, они различаются методами вычислений, назначением, надежностью и другими параметрами.
Основная цель – проверка информации и хранение конфиденциальных данных. ❗️

Создадим небольшой датафрейм с номерами телефонов для тестирования
data = {'phone': [9055548974, 9876543210, 5551234567, 7778889999]}
df = pd.DataFrame(data)


1️⃣ способ - с использованием библиотеки hashlib:
Сначала определяется функция hash_phone_number, которая принимает строку с номером телефона, кодирует его в байты и затем вычисляет SHA-256 хэш с помощью hashlib.sha256().

import hashlib
def hash_phone_number(phone_number):
return hashlib.sha256(phone_number.encode()).hexdigest()

df['code1'] = df['phone'].astype(str).apply(hash_phone_number)


2️⃣ способ – с использованием уже готовой функции hash()

df['code2'] = df['phone'].astype(str).apply(lambda x: hash(x))


В результате получаем два варианта уникального кода номеров телефонов. Можно и пароли так хэшировать.

❗️❗️❗️P.S. Все кто оставлял заявку в гугл-форме на следующий поток, пишите в поле свой ТГ ник не просто как отображается имя в телеге, а таким образом: пример моего ника - @Valeria_Shuvaeva, чтобы я Вас могла найти. Это можно найти в Settings. Если я кому-то не пишу, то значит просто не смогла Вас найти 😭
Ссылка тут - 🔗 заявка
  • ❤ 17
  • 👍 7
Post #125 3.4K
✏️Это пост навеян статьей с Хабра . Там человек опросил более тысячи человек из IT сферы про разное: и как вкатывались в IT, и пол тех, кто уже там работает. Оказалось женщин всего 14%. Девочки, а ну-ка поднажмем, увеличим свою долю! 💪

Еще интересен тренд как увеличился % тех кто учился сам: с 42% десять лет назад до 63% 🔼
и рост выходцев с платных курсов с 3% до 30%. 🔼 Тут и я тоже, правда я в опросе этом не участвовала. Хотя у меня и высшее инженерное образование тоже есть. Но оно по факту никого при собесе не интересовало вообще. 😜

Нужны курсы или нет решает каждый сам. Я не жалею,что отучилась, но есть и те, кто не находит работу после них. Мое мнение - что прежде всего должна быть голова на плечах и большое упорство. Если вы никогда не щупали данные в компании (хоть какие-то цифры), то нет смысла покупать годовые курсы и надеяться, что они вам дадут знания.

Вернее - только знания они и дадут, но вот опыта - нет. Потому я всегда рекомендую менять работу постепенно. Найдите что-то связанное хотя бы с Excel, допустим аналитиком по продажам. Там ваш питон уже будет как плюс. Можно анализировать маркетплейс магазинчики - их сейчас много, можно пробовать частичную занятость. Сделайте не сто откликов, а пятьсот!

Вы думаете, что сейчас сложно, но в следующем году возможно будет еще сложнее. Не ждите "легких времен" . Единственно, что обязательно - вам должно нравиться кодить и от этого вы должны кайфовать. ❤️
Без любви к делу, как бы банально это ни звучало, вам это всё надоест через какое-то время. А учиться нам нужно постоянно.

Вот такой вот пост на ночь глядя.

И давайте что-ли тоже запустим свой опрос. ➡️
  • ❤ 28
  • 👍 5
Post #124 2.77K
От меня не убежишь! 😂

Мне в очередной раз нужно было таблицу из плоской сделать сводной. Ведь конечные пользователи любят смотреть именно сводные таблицы, а не обычные в плоском виде, потому что они удобнее для быстрых выводов.
У меня была выгружена табличка с нишами, месяцем и суммой выручки: name, month, amount

df = pd.DataFrame({'name': ['ниша_1', 'ниша_2','ниша_2','ниша_1',None,'ниша_3','ниша_1'],
'month': ['2024-01', '2024-02', '2023-12', '2024-02', '2024-01', '2024-02','2024-01'],
'amount':[ 100, 150, 200, 250, 500, 100,300]})


А я помню, что ниши проставлены не везде и если мы делаем сводную из того, что у нас есть – часть сумм потеряется.
У меня в примере есть в нишах None (там где сумма 500), как будто данных не было.

И из-за этого в сводной получается, что общая сумма таблицы 1100, а не 1600, как должно быть. Кстати, не забываем, что margins=True позволяет увидеть итоговые суммы по столбцам и строкам.

Так вот, сначала нужно заполнить пустоту каким-то названием или нулем хотя бы.
Не забываем приравнять df['name'].fillna('нет ниши') к столбцу df['name'] иначе заполнение не сохранится.
df['name'] = df['name'].fillna('нет ниши')


А теперь можно и сводную строить.
• В параметр index передадим ту колонку, данные которой будут представлены строками сводной таблицы.
• В параметр values мы передаем ту колонку, по которой нам нужно строить сводные данные, применяя агрегирующую функцию сумма.
• В параметр columns передаем колонку, значения которой будут в столбцах.
• В параметр aggfunc передаем агрегирующую функцию (sum. count и пр..)

Другими словами:
В индексы загоняю месяц (month), а в колонки - ниши (columns=['name']). В значения (values) - чем будет заполнена таблица - суммы выручки amount .

Обернем все в скобочки, чтобы перенести код для удобства на новую строку. Можно конечно и обратным слэшем \ воспользоваться, но со () мне больше нравится
(df.pivot_table(index = ['month'], 
columns=['name'],
values = 'amount',
aggfunc = 'sum',margins=True)
.fillna(0)
.reset_index()
)

Вот теперь все по красоте! ✔️🆒

P.S. В эти выходные последнее занятие по питону (заканчивается мой первый поток). ✅
Я сделала в гугл-форме короткую заявку на следующий мартовский поток или если вы хотите позже марта заниматься, то там тоже можно это отметить. Кстати, эти гугл-формы реально очень прикольные и их легко создавать. Я там еще и картинку вставила красивую.
Там можно выбрать нужен ли вам блок только по SQL (4 занятия), блок по Питону(6 занятий) или все вместе.
Ссылка тут - заявка
  • 👏 13
  • 👍 5
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →