Пишу о рабочих буднях аналитика. Тут много рабочего кода, прохождение собеседований и еще много всего полезного.
https://www.linkedin.com/in/valeriashuvaeva
Автор канала: @Valeria_Shuvaeva
Post #123
2.1K

- ✍ 1
 МИ
@analysts_world
Showing posts older than #124 · Back to latest


У нас есть какой-то датафрейм, создадим его из словаря
df = pd.DataFrame({'deal_id': [11111, 11112,11113,11114,11115,11116,11117,11118,11119,11120],
                    'amount': [10000,20050,30500,45000,50001,62000,70000,81000,92000,100500]})
interval_range = pd.interval_range(start=0, freq=10000, end=500000)
df['type'] =  pd.cut(df['amount'], bins=interval_range)


Мы делали то, что отличалось от других компаний, которые я видел. Я думаю, что инвесторы из кремниевой долины не поддержали бы нас на том уровне, который нам был нужен.
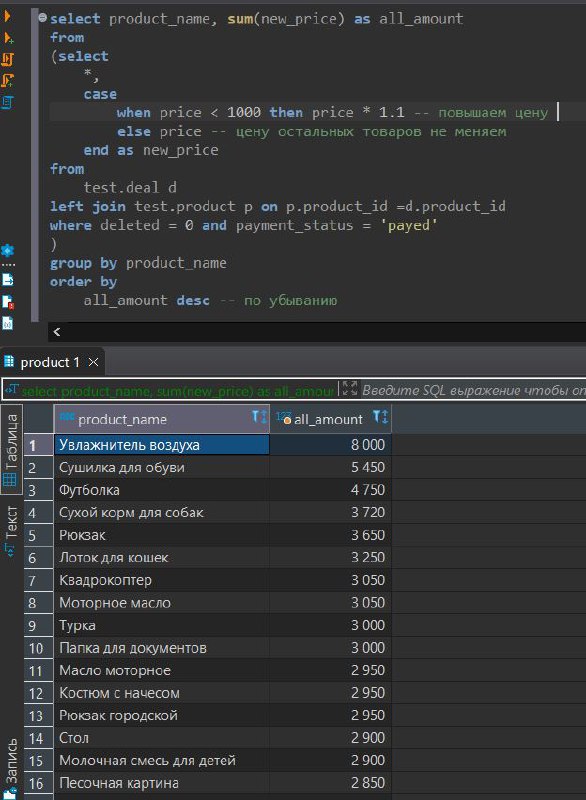
Select sum(case
    when currency = 'RUB' then amount
    when currency = 'RUR' then amount
    else (amount * rate) end) as 'all_sum'

df = pd.DataFrame({'Name': ['client_1', 'client_2', 'client_3', 'client_4','client_5'],
'Revenue': [500, 1000, 800, 3000, 2500]})df.loc[df.Revenue <1000, 'Group'] = '<1000'
df.loc[(df.Revenue >=1000)&(df.Revenue <2000), 'Group'] = '1000-2000'
df.loc[df.Revenue >=2000, 'Group'] = '>=2000'
df['Group2']=pd.cut(df['Revenue'],bins=[0,999,2000,np.inf],labels=['<1000','1000-2000', '>=2000'])


df_members['Номер участника'] = range(1,74)
pd.DataFrame(np.random.randint(1,74,size=(1,3)), columns=['Победитель 1','Победитель 2','Победитель 3'])
df_members[(df_members['Номер участника'] == df['Победитель 1'][0])
          |(df_members['Номер участника'] == df['Победитель 2'][0])
          |(df_members['Номер участника'] == df['Победитель 3'][0])]


lag (pass_date,1) over (partition by tab_id order by pass_date)
pass_date - lag (pass_date,1) over (partition by tab_id order by pass_date) as time_diff
pass_direction +lag(pass_direction,1) over (partition by tab_id order by pass_date) as sum_enter
sum(time_diff) filter (where (sum_enter = 1) and pass_direction =0)
select
  working_date,
  tab_id,
  sum(time_diff) filter (where (sum_enter = 1) and pass_direction = 0)
from
  (
  select
    date(pass_date) as working_date,
    pass_date,
    tab_id,
    pass_direction,
    -- разница между текущим временем и временем предыдущего действия
    pass_date - lag (pass_date,  1) over (partition by tab_id order by pass_date) as time_diff,
    -- суммируем показатели текущего и предыдущего действия (0+1 - то, что нужно), а если 1+1=2 - такое нам не надо
    pass_direction + lag(pass_direction, 1) over (partition by tab_id order by pass_date) as sum_enter
  from
    test.newtable
  order by
    pass_date
) t1
group by 1, 2

orders = (
    df
    .groupby('order_number')['click2delivery']
    .agg(mean_time='mean')
    .reset_index()
)
df = df.merge(orders, how='inner', on='order_number')
arr = [0, 1]
while len(arr) < 10_000:
    arr.append(sum(arr[-2:]) * 0.5)
df['seq'] = arr