
🙌 Недавно мне попалась интересная задача на работе, связанная с обработкой текстовых данных. Расскажу, как я это сделала, чтобы вы тоже могли попробовать!
Попросили вытащить из колонки параметров в базе одну цифру, которая следует за словом type. У данных тип object, слов разных технических там много.
Я воспользовалась регулярным выражением. Все таки регулярки - это мощь! 💪
import pandas as pd
import re
# Создам образец, чтобы можно было скопировать
data = {
    "params": [
        "example type:1 with text type:11",
        "another type:2 sample",
        "more text type:3 here",
        "type:4 is also included",
        "and a final type:5 example"
    ]
}
df = pd.DataFrame(data)
А теперь пишем функцию, которую можно будет в apply запихнуть.
def find_numbers(text):
    pattern = 'type:\s*(\d+)'  # Это шаблон для поиска
    numbers = re.findall(pattern, text)  # Ищем все совпадения
    return numbers
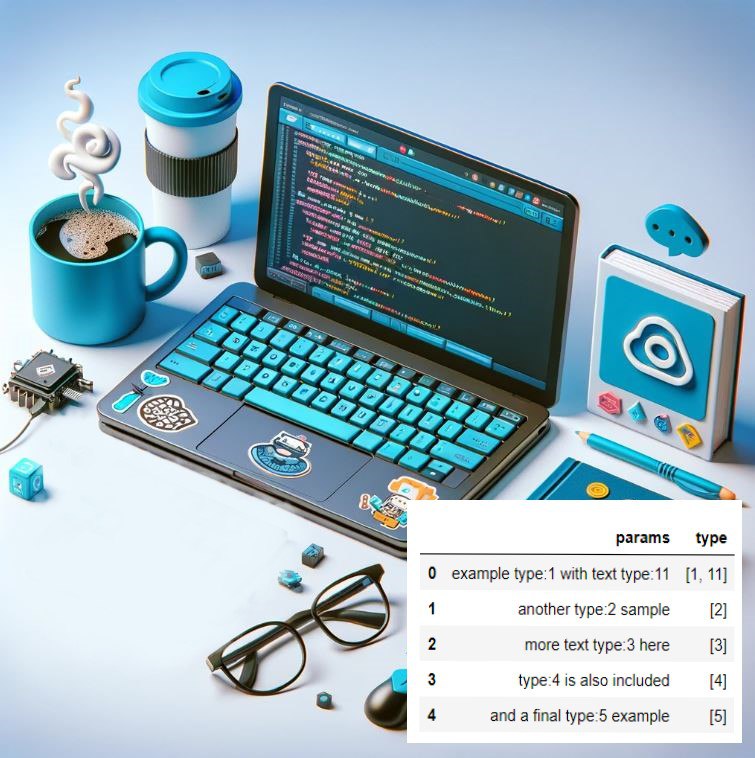
В отдельной колонке будут записаны числа после type, даже если их несколько (смотрите на картинке )
df['type']= df['params'].apply(find_numbers)
🔑 Расшифрую
⏩ re.findall ищет все совпадения, что позволяет надежно извлекать числа, даже если их несколько в одной строке.
⏩pattern = 'type:\s*(\d+)'
\s* или \s обозначает любой пробельный символ (пробелы, табуляции, новые строки и т. д.), а * означает "ноль или более" таких символов. Это означает, что между двоеточием и значением может быть любое количество пробелов или даже их отсутствие.
(\d+) - \d означает любую цифру, а + говорит о "одном или более" вхождении. Скобки () используются для группировки выражения, чтобы можно было извлечь только интересующую нас часть (т.е. сами цифры, а не кавычки или пробелы вокруг них).