TGViewer
Channel Public Channel
🤓Бартов: про работу с ИТ- и медтекстами и про всякое

🤓Бартов: про работу с ИТ- и медтекстами и про всякое

@alliancepro

Евгений Бартов, главред бюро переводов «Альянс ПРО» (ИТ, ИБ | медицина)
Перевожу, редактирую, копирайчу, автоматизирую работу с текстами.

В переводах с 1998 г.
Для вопросов, запросов и предложений — @bartov_e
Subscribers
2.43K
Photos
2K
Videos
60
Links
1.1K
Recent Posts 18 shown
Post #3879 238
У меня первый язык - немецкий. Поэтому я именно так сначала английский и учил.
  • 😁 11
  • 💯 7
Post #3877 417
Кстати, когда мы обсуждали заказ на перевод книги по теории информации, клиент предложил мне просто скриншотить формулы, чтобы он их потом просто вставил в книгу (MS Word).
- А как же локализация формул?
- Евгений, не пугайте меня. Их разве надо локализовать?
- Разумеется. Поэтому скриншотами не обойдемся.


Попалась на глаза хорошая иллюстрация.
Возможно, кому-то будет полезно учитывать этот момент в обсуждении своих проектов.

(https://teletype.in/@bartov/H-mSGIlFVGQ)
  • ❤ 9
  • 👍 3
Post #3876 366
Post #3875 380
🤓Бартов: про работу с ИТ- и медтекстами и про всякое Приступили к статье про ИИ, общий посыл которой в том, что работа с ИИ, даже при всей его бесплатности и дешевизне, на сложных проектах выходит далеко не бесплатной (есть масса людей, которые убеждены в обратном), иногда даже не дешевле (!) и не быстрее (!!)…
Как и обещал, написали для клиента статью о том, почему дешевый ИИ на самом деле весьма дорогая игрушка для бизнеса.

https://habr.com/ru/articles/1090778/

Когда я говорил про экстраполяцию, я - как уже пояснял ранее - имею в виду игнорирование ИИшкой глоссариев, базы переводов, редполитик. И если в личном применении с этими неудобствами можно как-то смириться, то в бизнесовом применении кто-то это дерьмо должен разгребать — либо исполнитель (редактор, бюро, переводчик, оператор ИИ-агента), либо клиент (менеджер, редактор и т.д.). Часто перекладывают на читателя, но читатель нынче избалованный и бесконтрольная генерация (нейрослоп) у него вызывает отторжение.
Post #3874 426
Про локализацию кода в стайлгайдах ИТ-компаний написано скупо. И то, что написано, мягко говоря, не учитывает массу edge cases.

Темы локализации промптов там нет вообще. А я на эти грабли наступил — когда переводил книгу Томажа Братанича «Основы GraphRAG. Улучшенный RAG на базе графов знаний».
Подробно про ту проблематику я сейчас расписывать не буду. Косвенно я её упомянул в телеграм-группе «Дебагеры Read IT Club» . Вот цитата:
Под листингами я понимаю следующие вещи:
1. Фрагменты кода / результаты его выполнения. 2. Логи/выводы команд. 3. Промпты/инференсы/выводы (в т.ч. системные и для взаимодействия с MCP). 4. Сообщения об ошибках.

Может, ещё что-то забыл — пожалуйста, дополните. Но, думаю, направление мыслей понятно.

С одной стороны, нельзя оставлять читателя без перевода — ему может быть непонятно.
С другой стороны, переводить даже значения строковых переменных опасно. Вдруг автору захочется посчитать в них слова, буквы или байты, отсортировать их или использовать строковые значения в качестве заголовков полей в БД (типа orders). Плюс нельзя упускать из виду такой момент: если вы в первой главе что-то перевели по определённому паттерну, то и до конца книги придётся переводить так же. Или не переводить вообще.

С промптами тоже всё неоднозначно. То, что прекрасно работает на английском в одной модели, может работать совсем не так — или совсем никак — на русском в этой же модели. И уж тем более в другой: мало ли на каких тренировочных сетах они выращивались.

С выводами выполнения команд тоже непросто. Вроде как там можно перевести, но надо, видимо, какое-то предупреждение для читателя выводить: этот перевод понарошку, в реальности он всё равно увидит на экране английские слова. Потому что этот шелл, справка или утилита на русский никогда не переводились — и вряд ли кому захочется оплачивать такой перевод.

•••
Жарких дискуссий мой вопрос не вызвал. Но сейчас я уже заканчиваю работу над переводом книги Go In Action, и мне этот вопрос надо было как-то решать.


Получившееся решение см. на https://teletype.in/@bartov/9nZNs_UyiBl
  • ❤ 3
  • 👏 3
Post #3873 358
Можно зафиксировать небольшой личный рекорд: ~570 страниц за сентябрь.
  • 🎉 21
Post #3871 380
Переведенная мною книга уже появилась на пиратских развалах (обнаружил в свежем пополнении для своей библиотеки).

Кстати, одна из наиболее приятных в переводе книг — почерпнул много полезных нюансов по пониманию темы СУБД.
В частности, про интерпретацию булевых значений (писал на эту тему заметку - https://teletype.in/@bartov/afhzofrI7SJ8j_PL)
  • 🔥 9
  • 👍 3
Post #3870 343
Всё, капец.
Пора на пенсию.
Я только сейчас узнал, что у spacecraft мн. число совпадает с единственным (т.е. many spacecraft).
Но при этом, craft во мн. числе будет crafts (ремесла).
  • ❤ 22
Post #3869 360
Подготовили на Хабр еще одну статью про ИИ, уже для другого клиента, которая косвенно подтверждает тот подход, про который я писал выше - не prompt-driven результат, а spec-driven. Сначала спецификация, потом код.

https://habr.com/ru/companies/cinimex/articles/1088534/

К этому подходу клиент шел почти 3 года — сначала также как у многих в глазах горел огонь от магии ИИ (я тоже грешен), теперь чисто прагматичный подход — ИИ в конвейер, конвейер обвязать ограничителями, и тогда ИИ работает в нужном русле/фреймворке.

Напомню, я на курсе про конвейер перевода (курс, если что, по прежнему есть в записи), продвигал ту же идею - ИИ в клетку, клетку обвязываем базой знаний, глоссариями, базой переводов, и традосом (или любой другой кошкой). После этого только можно ехать. Иначе, переводчик-редактор обречен укрощать (редактировать) фантазии ИИ.
  • 💯 7
Post #3868 326
Ну, вы поняли 😉
  • 🎉 15
Post #3867 360
Этот пост для тех, кто пытается писать свои скрипты для автоматизации работы. Делюсь граблями и, возможно, приемом для снижения числа грабель.

Как я недавно выяснил, я писал свои скрипты неправильно. Обычно я действовал так:
1. Пишу запрос, типа: "Напиши мне Python-скрипт, который делает то-то и то-то. А еще вот это, это и это".
2. Дипсик мне чего-нибудь выкатывает, я пробегаю глазами по коду, если похоже на то, что я хотел, вставляю в VS Code, запускаю, поехали.
3. Если вылазят какие-то ошибки (а они обязательно вылазят), я скидываю лог ошибки, Дипсик думает, выдвигает версию, и пишет что-то в духе - ну вот теперь-то 200% заработает.
4. Снова запускаю, что-то начинает работать, что-то перестает, и дальше начинается тяни-толкай - дипсик правит одни две ошибки, но во время правок сносит логику других функций и появляются другие две ошибки.

В эту игру можно играть долго и каждый раз Дипсик авторитетно заявляет: "Ну вот сейчас я ВАЩЕ ВСЁ-ВСЁ-ВСЁ учел и стопудово заработает". Ты снова запускаешь код, и он опять минут через 1-5-15-40 выбрасывает ошибку.

Когда мой заказчик начал мне описывать, как фанаты ИИ часами гоняются за линией горизонта за шансом ухватить версию работающего кода, глядя на обещания ИИ — я узнал себя. В том же разговоре клиент и сказал, что реализовать тот или иной алгоритм программно - нет никаких проблем, с этим справится junior-разработчик.

Проблема написать работающий код в другом — нужно вокруг программной реализации алгоритма и «идеального сценария его использования» (happy path) написать кучу сценариев, когда что-то идет не по плану или выбивается из идеального сценария — а это уже 95% оставшегося кода.

При таком раскладе, получается, что сначала ты должен с ИИ проговорить основную логику, потом подолгу обсуждать всякие запасные варианты развития событий, и только тогда уже давать команду на выкатывание кода.

Как это выглядит? Пишу промпт в духе:
1. Хочу Python-скрипт, который делает то-то и то-то (далее пошаговый идеальный алгоритм).
2. Проанализируй предложенную реализацию алгоритма, выяви слабые и спорные места, и предложи к нему оптимизации.
3. Никогда не выводи код, пока не прояснишь все уточняющие вопросы. Код выводи только после моей команды "Выводи полный код".


И вот там уже начинается нудный допрос со стороны ИИ (примеры из обсуждения скрипта для дедупликации книг в библиотеке):
- Хэширование текста без полного извлечения — принципиально ли это? Предлагаю такую-то реализацию. Согласен?
- Что значит «уникальный файл»?
- Где живет индекс? Как скрипт узнаёт, что файл «новый»?
- Что если имя файла уже содержит [Число_страниц]_? Убирать старый префикс и ставить новый? Или оставлять как есть?
- По твоему правилу выживает PDF (он в LIB\), а EPUB удаляется. Это правильно? Или всё-таки EPUB должен выжить, потому что он более редактируемый?
- Дубликаты внутри LIB\ тоже идут в _duplicates, а не в _trash?


И вопросы подобные этим идут бесконечным (как кажется) потоком. Ты только ответишь на 20 вопросов, он находит в твоих ответах слабые места, и генерирует еще 20 уточняющих.. И таких сессий вопросов-ответов может быть 20-30 штук.
Главное, каждый раз, когда ты отправляешь пачку ответов, не давать себе слабину и снова, и снова запрашивать - если есть еще уточняющие вопросы, задавай.

В итоге, когда Дипсик выдает-таки заветную фразу "Вопросов больше нет, я готов вывести код", он реально выкатывает код, который работает почти сразу (у меня один косяк только в коде возник, где Дипсик библиотеку импортировал чуть позже в коде, чем положено), но это легко исправилось.

Эксперимент с таким допросом делал 2 раза (апдейтил скрипт для извлечения глоссария + этот, для дедупликации) — результатом пока доволен. Код ИИ выкатывает за 2-3 минуты (и это, как вы понимаете, самая финальная операция), а вот само обсуждение параметров, ограничений, уточнений - 2-3 и более часов даже на мелкий скрипт.

(Оригинал публикации: https://teletype.in/@bartov/KWfbFa56Vx-)
Teletype Вайб-кодинг с отладкой Этот пост — для тех, кто пишет свои скрипты для автоматизации. Делюсь граблями и, возможно, приёмом, который помогает наступать на них реже.
  • 👍 8
  • 🔥 6
Post #3866 333
Приступили к статье про ИИ, общий посыл которой в том, что работа с ИИ, даже при всей его бесплатности и дешевизне, на сложных проектах выходит далеко не бесплатной (есть масса людей, которые убеждены в обратном), иногда даже не дешевле (!) и не быстрее (!!) работы по классической схеме.

И хотя наш заказчик в этой статье рассказывает про разработку софта через ИИ, как и в прошлый раз, его выводы и подсчеты прекрасно экстраполируются на нашу переводческую колокольню.

Скоро опубликуем.
  • 👍 21
  • ❤ 3
Post #3864 502
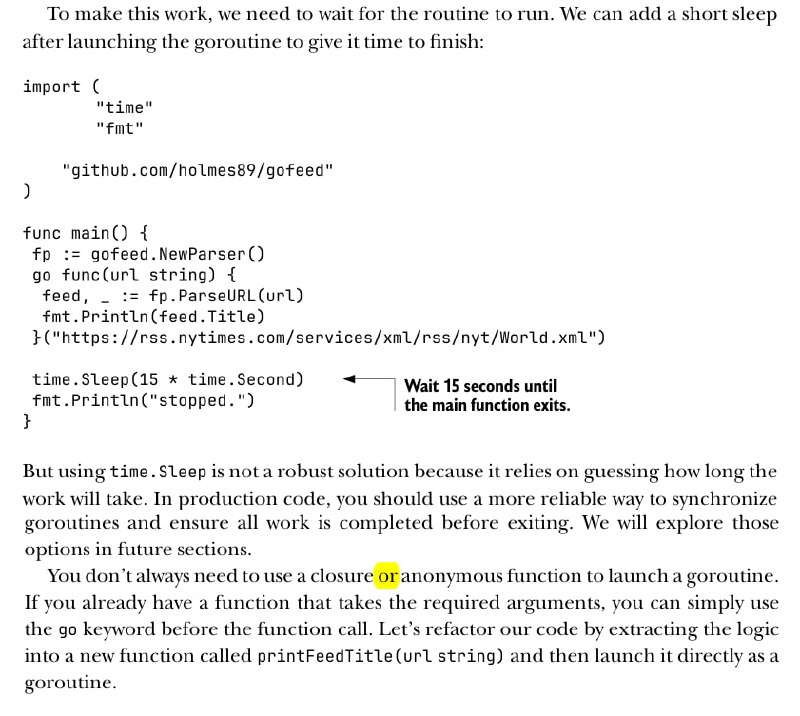
Ладно, с переводом "it" справились хорошо.
А как переводится "or"? 😜
  • 😁 4
  • 🤯 1
Post #3863 452
А теперь загадка уровня Happy English - как перевести "it"? 🤦🏻‍♂️
  • 😁 6
Post #3861 453
Обычно издательство, предлагая книжку в работу, шлет ее не сразу, а скидывает ссылку на Амазон - типа там посмотрите. Если интерес есть, потом - через час-два-день - пришлем уже текст.

В силу любопытства я в таких случаях обычно не жду, а иду либо в свою библиотеку, либо в пиратские библиотеки, и качаю текст там.

Позавчера предложили вот эту книгу, я полез как обычно на разные сайты и ее там не нашел. Очень странно, пришлось дождаться, когда пришлет издательство.
Прислали - дата очень удивила, прямо свежак-свежак.

Если нормально въеду в смысл, что-нибудь еще интересное автоматизирую и расскажу как (там ООЧЕНЬ много кода на Питоне).
MCP - это сервисы, которые предоставляют ИИ-ассистентам контекст. Как раз то, чего ассистентам не хватает, чтобы не галлюцинировать. Что-то типа базы знаний, но база знаний - статична, а MCP - предоставляет данные в динамике (например, текущая биржевая сводка). Или - это как раз мой замысел — учитывать свежие сегменты переводов автоматически (я пока это делаю вручную).
  • 👍 9
Post #3860 367
🤓Бартов: про работу с ИТ- и медтекстами и про всякое Недавно я цитировал Линуса Торвальдса применительно к нашим переводческим реалиям. Фраза мне эта попалась на глаза не потому, что я фанат Линуса, а потому что мы в это время с коллегой писали статью о любопытном эксперименте в российском ИТ — один большой…
Кстати, тема прямо очень болит у всех - наша статья вышла в ТОП-3 на Хабре.
Комменты - огонь.
  • ❤ 12
Post #3859 350
🤓Бартов: про работу с ИТ- и медтекстами и про всякое Недавно я цитировал Линуса Торвальдса применительно к нашим переводческим реалиям. Фраза мне эта попалась на глаза не потому, что я фанат Линуса, а потому что мы в это время с коллегой писали статью о любопытном эксперименте в российском ИТ — один большой…
Любопытное выражение услышал от клиента, когда обсуждали эту статью (https://habr.com/ru/articles/1085382/).
Сказано оно было в контексте того, что люди бездумно ставят задачи ИИ и даже не проверяют результаты:

«Когнитивная капитуляция»


Думаю, многим знаком этот симптом (мне то уж точно, я еще год назад про него писал, когда даже 2+2 сложить влом и ты просишь помощи ИИ). Какие наиболее острые проявления этой капитуляции вам попадались?

Про 2+2 я уже сказал. Еще?
  • ❤ 6
  • 👍 5
Post #3858 396
А вот давайте поговорим о насущном.

Представьте, у вас суперсрочный проект, нормально платят, работы на 2 дня, но это дедлайн впритык - если пахать по полной.

Однако прямо сейчас по полной вы не можете - засыпаете на клавиатуре. Какие варианты отогнать приступ сонливости?

Напишу свои варианты, вы в комментах напишите свои:
- семечки;
- холодный душ;
- тройной чай без сахара (хотя тут спорно, больше на плацебо похоже, т.к. действует не всегда);
- кратковременная физическая нагрузка (чтобы поднять ЧСС хотя бы до 150).

Еще варианты?
  • 🔥 10
Older posts →

About this channel

How can I read @alliancepro without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 🤓Бартов: про работу с ИТ- и медтекстами и про всякое: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 🤓Бартов: про работу с ИТ- и медтекстами и про всякое have?
🤓Бартов: про работу с ИТ- и медтекстами и про всякое (@alliancepro) has 2.43K subscribers on Telegram, refreshed roughly every 30 minutes.
Does 🤓Бартов: про работу с ИТ- и медтекстами и про всякое know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →