Агентская память done right [PART 4 FINAL]Hebbs — элегантный слой памяти для агентов. Наткнулся на него абсолютно случайно, рыская по GitHub. У проекта на момент написания 20 с небольшим звезд. Но после всего, что я прочитал и изучил на тему памяти, реализовал бы я её именно так.
базовая единица — эпизод ⭐️
Один и тот же эпизод живёт сразу в нескольких представлениях:
• как обычный текстовый memory item
• как вектор в HNSW embedding index
• как узел в графе связей
• как событие во времени
• как часть более поздних инсайтов и ревизий
То есть эпизод один, а способов вспомнить его — несколько.
Помимо этого: продуманная модель данных, минимум абстракций, MCP с 9 понятными инструментами, один ~25Mb бинарник, векторные модельки в ONNX, поддержка основных LLM API, клиентский API на Python, Typescript, Rust или C/C++ (через FFI).
Но главное — реализованы
все ключевые паттерны, которые мы разобрали в
PART 2 и
PART 3.
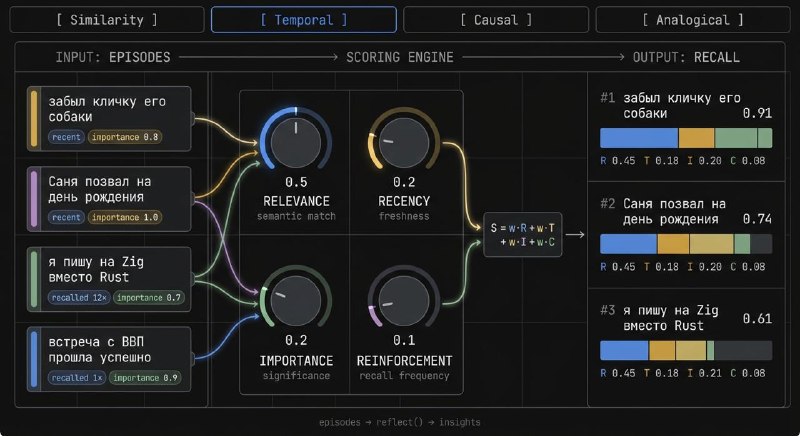
4 способа вспомнить 🤨
/// hebbs-core/src/recall.rs
pub enum RecallStrategy {
  Similarity,
  Temporal,
  Causal,
  Analogical,
}
Хочешь хронологию по проекту —
Temporal. Причинную цепочку от конкретного бага —
Causal. Нечто похожее, но из другого домена —
Analogical. Тупо семантический поиск —
Similarity. Конечно же, можно все и сразу и параллельно.
К слову, связи в графе здесь предопределены:
CausedBy,
FollowedBy,
RelatedTo,
RevisedFrom,
Contradicts,
InsightFrom — LLM не сможет бесконтрольно плодить новые, как это часто бывает в подобных системах.
скоринг знанийНезависимо от стратегии, чтобы попасть в поисковую выдачу агента, все эпизоды проходят фильтр по следующему скору:
S = w_r×R + w_t×T + w_i×I + w_c×CR
= relevance — семантическая близость к запросу:
(1 − hnsw_distance)T
= recency — свежесть:
(1 − age / 30 days)I = importance — значимость, задаётся агентом при вызове remember()
C
= reinforcement — частота вспоминания:
log₂(1 + access_count) / log₂(1 + 101)w — вес при каждой компоненте, соответственно
Дефолтные веса
0.5 : 0.2 : 0.2 : 0.1 ; можно задать вручную, можно юзать пресеты.
Свежий эпизод, стандартная важность, ни разу не вспоминали:
0.5×1.0 + 0.2×1.0 + 0.2×0.5 + 0.1×0.0 = 0.80через месяц без обращений
→ T = 0, C = 0 → 0.10, почти забыт. Но если его регулярно вспоминали — C растёт логарифмически и тянет скор обратно вверх.
С позиции LLM агента всё тоже предельно просто: выбери 1 или несколько из 4 способов поиска, если надо, подкрути 4 ручки, чтобы настроить какие сигналы для тебя важнее в этом запросе.
reflect = daydreamingРежим переоценки знаний происходит так:
(1) Cluster → группировка похожих эпизодов (embedding + temporal proximity)
(2) Propose → LLM генерирует кандидат-инсайты из кластера
(3) Validate → второй LLM-pass проверяет точность и полезность
(
4) Consolidate → валидные инсайты →
Insight сущности + InsightFrom связи
Каждый инсайт хранит confidence и lineage к исходным эпизодам. Обновили эпизод через
revise() или удалили через f
orget() — зависимые инсайты автоматически помечаются как stale и перевалидируются в фоне. Можно включать автоматически: по количеству новых эпизодов, по расписанию, по накоплению записей высоким importance.
Вот основная разница между «хранить данные» и «накапливать опыт».
ИтогоДля долгоживущего автономного LLM агента, особенно в режиме embedded типа умной колонки, Hebbs попадает в sweet spot: forgetting, reinforcement, reflection, lineage, conflict detection — при этом я понимаю, как работает каждый компонент и как его подкрутить.
Для бытовых задач и совместного наполнения некоторой базы знаний, думаю, достаточно инструментов типа
QMD или
LightRAG.
Из минусов отметил бы для себя малопопулярную RocksDB в качестве БД и отсутствие нативной поддержки мультимодальности. Но это скорее придирки.
Быстрые ссылки •
Hebbs — GitHub •
Hebbs Docs •
Recall Strategies •
Reflection / Background Learning •
API Overview