
Long Horizon Execution в LLM
...или как агенты тупеют во время разговора
Статья: https://arxiv.org/abs/2509.09677
Итак, проверяют как LLM работают на длинных горизонтах — выполнение задачи, состояние которой развивается и копится в контексте на протяжении большого количества turn («ходов» user/assistant). Замеряют на синтетической задачке, где LLM-ка должна трекать состояние цепочки арифметических операций. На мой вкус вполне репрезентативный тест, если даже на нём проявляется эффект.
TL/DR
При решении задачи модели работают тем хуже, чем длиннее контекст диалога они обрабатывают и/или, если в этом контексте возникали ошибки.
Тезисы
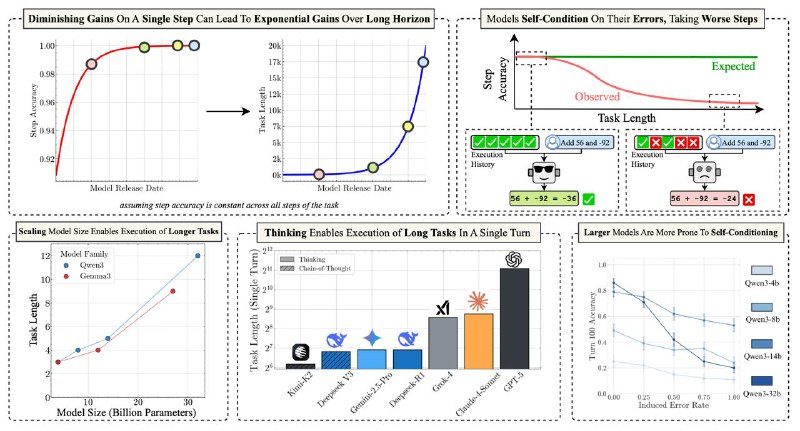
✦ Точность выполнения задач на одном turn (single instruction) зависит от размера модели, но быстро насыщается — модельки начиная с 32B обычно максимизируют эту метрику и дальше от размера идёт diminishing returns
✦ Но размер начинает играть ключевое значение при len(turns) > 1: чем больше моделька, тем бóльшую точность выполнения задачи она поддерживает, и тем медленее это качество решений деградирует
✦ Self-Conditioning: На «длинных» задачах модели деградируют, если в контексте возникают их собственные ошибки — когда, смотря на свои ошибки в прошлом, модель буквально тупеет и начинает их воспроизводить (или теряет мотивацию, я хз)
✦ Размер модели не играет роли в self-conditioning, даже напротив — более крупные модельки быстрее адаптируются под свои ошибки
✦ Thinking mode (обученный reasoning, не CoT) избавляет от self-conditioning и ошибки в прошлом перестают влиять на выполнение задач в будущем — авторы предполагают, что это следствие RL алаймента, где модель становится не просто автодополнятором текста, а task-oriented агентом, которому наоборот — чаще надо игнорировать свои прошлые неудачи
✦ CoT нужен, если в рамках одного turn нужно выполнить более одного действия (считай tool call) — тут хотя бы простое текстовое планирование требуется, иначе даже большие модельки не справляются с более чем одним действием за turn
Мои выводы
☁︎ Context Engineering критически важен! Для слабых моделек лучше убирать из контекста ошибочные вызовы и просто перезапускать их, быть может, отдельной моделькой добавляя не сами действия, а комментарии/подсказки — на что модельке-исполнителю обратить внимание в следующей попытке (очевидно, корректор должен быть сильнее или располагать бóльшим контекстом)
☁︎ Для случаев, когда не хочется заводить отдельную модель-корректора и городить мультиагентность, хотя бы включите Thinking Mode
☁︎ Есть предел шагов, которые модель может выполнить с адекватным качеством, далее оно существенно и быстро деградирует. Значит надо как-то находить точку этой деградации на своей задаче и иметь стратегию fallback/restart
Как это учитывать в агентах
Любопытно, что некоторое время назад очень похожие идеи я встретил в parlant. Это агентский фреймворк с достаточно свежим взглядом на агентов, где привычный Flow/Finite State Machine можно задавать неявно с помощью регламентов и руководств на естественном языке, как бы вы передавали их обычному работнику-человеку. Я бы сказал это такой if/else на LLM стероидах.
Так вот одна из задач, которую фреймворк перед собой ставит — сужать контекстное окно решаемой задачи для агентов, ограничивая его небольшим набором инструкций и сообщений. Свой подход они называют Attentive Reasoning Queries (ARQs). Таким образом обещается высокая точность выполнения задач. Разработчики в упомянутом выше блогпосте также ссылались на любопытную Curse of Instructions на ту же тему, но судя по Open Review, далеко статья не пошла.
Интересно, что другой популярный практико-ориентированный совет для production LLM систем — максимальное переиспользовать и кешировать контекст. Как эти две идеи дружить друг с другом хз, will see.
#Review #Paper #Agents
Графики из статьи в комментариях
Post #325
701
- 🔥 4
- 👍 1
- 🥴 1