TGViewer
Channel Public Channel
AI песочница инженера

AI песочница инженера

@ai_prompt_eng

AI песочница инженера — практический канал об ИИ и данных в строительстве. Проверяем ИИ-сценарии для проектирования, ПТО, смет и управления проектами, разбираем риски и готовим инженерные артефакты для реального внедрения.

Обратная связь: @shelter51
Subscribers
2.38K
Photos
80
Videos
3
Links
135
Recent Posts 20 shown
Post #398 630
C3.pdf56.4 KB
Из сорока подсветок на листе какая меняет проект?

После новой выгрузки ИИ выделил сорок отличий. Инженер открывает первое: подпись стала шире. Второе: выноска сдвинулась. Третье: размер проёма изменился с 900 до 1 000 мм. Если проверять всё подряд как изменение решения, важная правка потеряется в оформлении.

Начните с двух контрольных пар. В первой сравните две выгрузки одной ревизии с известным изменением оформления. Во второй — версии с одной заранее известной содержательной правкой. Так вы увидите, что инструмент принимает за изменение и способен ли найти нужное различие.

ИИ здесь нужен для разбора текста и контекста: связать изменённую подпись с объектом, собрать повторяющиеся отметки, предложить, где поменялось значение. Инженер открывает обе версии и подтверждает каждую группу, из которой следует дальнейшее действие.

Разделите результат на три очереди. «Оформление» — значение и связь с объектом подтверждённо прежние. «Содержание» — установлено, что поменялось. «Не удалось сопоставить» — пока неизвестно, один ли объект сравнивается. Третью очередь нельзя автоматически записывать в добавления или удаления.

Например, новый идентификатор элемента после пересоздания не доказывает появления новой стены. Совпавшее положение тоже не доказывает, что стена прежняя. Нужны согласующиеся признаки и контекст; если их недостаточно, инженер оставляет конкретный вопрос на уточнение.

В приложении — три записи отчёта, по которым можно сразу открыть нужное место и проверить вывод. Такой разбор сокращает повторное чтение одинаковых подсветок и сохраняет нерешённые соответствия. Он устанавливает различия между версиями; допустимость новой ширины проёма требует отдельной технической проверки.

Что сильнее засоряет ваши сравнения ревизий: оформление, повторные отметки или потеря соответствия объектов?

Ранее по теме в канале: Пост от 27.08.2026
#ИИ_Изменения

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
  • 👍 1
  • 🤡 1
Post #397 682
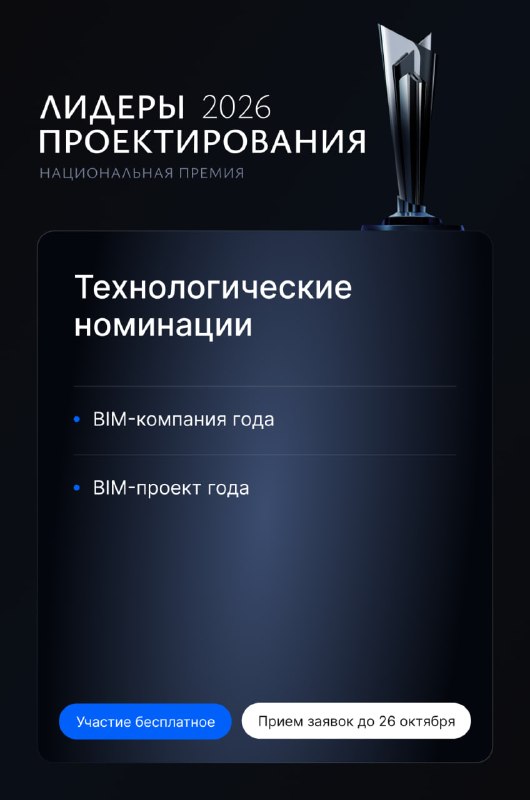
Проектируете в BIM? Подайте заявку на премию «Лидеры проектирования 2026»

Для BIM-команд в премии «Лидеры проектирования 2026» есть две технологические номинации.

🔹 BIM-проект года
Для проектов с глубокой BIM-проработкой: от охвата разделов и глубины проработки модели до координации, проверки коллизий и автоматизированного выпуска документации.
Учитываются работа с данными, BEP и СОД, использование модели для выпуска документации и смет, инженерных анализов, цифровых двойников, AI и других BIM-сценариев. Учитывается и эффект от применения BIM: влияние на сроки и бюджет проекта.

🔹 BIM-компания года
Для компаний с системно выстроенными BIM-процессами: корпоративными стандартами и регламентами, BIM-специалистами, СОД, обучением сотрудников, собственными библиотеками, плагинами и инструментами автоматизации.
Учитываются уровень BIM-зрелости, количество проектов в BIM, применение AI, VR/AR и цифровых двойников, эффект BIM-сценариев для заказчиков и экономика внедрения, включая ROI.

Уровень BIM в заявке подтверждают скриншоты моделей и процессов, примеры документации, регламенты и показатели эффективности.

Премия — это возможность представить свои BIM-компетенции отрасли и получить профессиональное признание за работу, которую команда выстраивала годами.

🏆Победители станут известны 13 ноября на торжественной церемонии в Москве.
Участие бесплатное. Приём заявок до 26 октября.

ПОДАТЬ ЗАЯВКУ
https://leaders-project.ru/?utm_source=info_partner&utm_medium=post
  • 👍 1
Post #396 664
Репост из «Заметок ГИПа Ковалева» — хороший разбор того, почему управление рисками должно быть процессом, а не таблицей, которую заполнили в начале проекта и забыли:
👉 https://t.me/zametkigipa/1146

У нас в Песочнице к этой же теме постепенно подошли с другой стороны — через проверяемость данных и последствий решений.

Например:
замену оборудования сначала нужно доказать, а уже потом согласовывать
«нет данных» нельзя превращать в зелёную галочку
По сути, это тот же риск-менеджмент на уровне инженерного решения:
что изменилось → что может пострадать → что проверить → кто должен решить.

А вот здесь ИИ действительно может быть полезен: не «управлять рисками за ГИПа», а помочь не потерять связи и поднять вопросы до того, как они станут проблемами на объекте.

Коллега из «Заметок ГИПа Ковалева» спасибо за тему — рекомендую канал тем, кто работает с проектами не только как проектировщик, но и как руководитель процесса.

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
Telegram Заметки ГИПа Ковалева Без управления рисками проект превращается в тушение пожаров В компаниях, где системной работы с рисками нет, многое держится на личном опыте людей. ГИП уже сталкивался с похожим объектом и знает, где могут возникнуть сложности. Руководитель отдела помнит…
  • 👍 4
  • 🔥 1
Post #395 686
Вопрос с А-ФЕСТ: производитель не даёт характеристики. Как проверить подбор?

Из зала спросили: а если производитель не предоставляет рабочую точку и другие данные — что делать?

Начну с примера. Нам нужен насос на 18 м³/ч при напоре 22 м, как в разборе канала. Это требование проекта. А какой расход получится после подключения, зависит и от насоса, и от сети.

Поэтому мне нужно не просто «эта модель подходит», а данные, по которым можно проверить подбор.

Что запрашиваю
Кривую насоса — график, показывающий, какой напор он развивает при разных расходах. Вместо графика подойдёт таблица характеристик или расчётный лист с достаточными данными.

Важно, чтобы они относились к выбранному исполнению: тем же оборотам, рабочему колесу и жидкости. Нужны также допустимые режимы, данные по мощности, КПД и условиям на всасывании.

Если подбор сделан в программе поставщика, прошу распечатку с исходными данными, а не только названием модели.

В нашем учебном примере при 18 м³/ч насос даёт около 23,4 м. Требуется 22 м. Разница — 1,4 м, но это ещё не гарантированный запас: нужно учесть допуски и проверить, как насос будет работать в сети и регулироваться.

Если данные не предоставляют
Прошу письменное подтверждение нужных параметров и условий, при которых они обеспечиваются.

Письмо об одном режиме подтверждает только указанные в нём сведения, а не заменяет все характеристики.

Если критичных данных всё равно нет, ставлю «нет данных». Это не «не соответствует», но и не основание согласовать оборудование.
Запрос, дату и ответ сохраняю. Причины отказа за производителя не придумываю.

Формулировка для запроса КП
Просим подтвердить подбор насоса на 18 м³/ч при напоре 22 м. Приложить кривую, таблицу характеристик или расчётный лист с исходными данными. Указать исполнение, допустимые режимы и гарантируемые параметры с допусками. Недостающие сведения перечислить отдельно.


ИИ здесь можно поручить собрать таблицу: что требуется → что подтверждено → источник → чего не хватает. Додумывать отсутствующие характеристики нельзя.

Результат проверяет инженер.

Каких данных чаще всего не хватает вам в ответах поставщиков?
Напишите пример без рабочих файлов и названий объектов.

#АФЕСТ #проектирование #ИИ_для_инженера #AIпесочница

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
  • 👍 2
  • ❤ 1
Post #394 2K
Как понять, что ИИ действительно можно внедрять в проектирование

Завтра НОПРИЗ проводит конференцию по применению искусственного интеллекта в инженерных изысканиях и архитектурно-строительном проектировании.

Сам по себе факт уже показательный: отрасль постепенно переходит от вопроса «можно ли использовать ИИ?» к более практичному — «где именно его имеет смысл встраивать в производственный процесс?»
И здесь есть одна проблема.

Почти любой AI-кейс можно эффектно показать на одном документе, одном проекте или одной удачной проверке.

Но для проектной организации этого недостаточно.
Чтобы понять, можно ли использовать решение в реальной работе, я бы проверял его по шести критериям.

1. Можно точно назвать операцию, которую выполняет ИИ
«ИИ проверяет проект» — слишком широкая формулировка.
Гораздо полезнее:
— сопоставляет ВОР со спецификацией;
— ищет расхождения между ПЗ и графической частью;
— проверяет наличие исходных данных для расчёта;
— сравнивает параметры оборудования в IFC и спецификации;
— классифицирует замечания экспертизы;
— проверяет конкретный набор требований СП.
То есть должна существовать понятная схема:
входные данные → операция → результат
Например:
IFC + спецификация XLSX → сверка оборудования → таблица расхождений
Если такую схему нельзя сформулировать, автоматизировать пока, скорее всего, нечего.

2. Понятно, какие данные считаются исходными
Для инженерной задачи это особенно важно.
Нейросеть может хорошо рассуждать и при этом анализировать:
— старую редакцию СП;
— предыдущую версию ТУ;
— неактуальный комплект РД;
— модель одной ревизии и спецификацию другой;
— документ, который вообще не относится к рассматриваемому решению.
Поэтому рабочий сценарий начинается не с промпта.
Сначала нужно определить источники:
IFC rev.07
Спецификация rev.07
ТУ №...
Задание rev.05
СП ... в редакции на дату ...
ИИ должен работать не с абстрактным «контекстом проекта», а с контролируемым набором исходных данных.

3. Результат можно быстро проверить
Для инженерной проверки недостаточно получить текст:
«Обнаружено несоответствие требованиям».

Нужна трассировка вывода.
Например:
элемент IFC → GUID
параметр → 3,2 л/с
спецификация → строка 48 → 4,1 л/с
результат → расхождение
Или для проверки нормы:
лист → объект → принятое решение → пункт нормативного документа → требование
Специалист должен понимать, откуда появился вывод, не повторяя весь поиск заново.
Если доказательство найти сложно, ИИ не столько сокращает проверку, сколько добавляет ещё один слой работы.

4. Известно, где система ошибается
Обычно при пилоте первым делом показывают успешные примеры.
Но для внедрения полезнее знать другое:
что система пропускает и что она считает ошибкой ошибочно.
Допустим, на контрольной выборке было 100 известных расхождений.
Нужно смотреть отдельно:
— сколько найдено;
— сколько пропущено;
— сколько добавлено ложных;
— какие типы ошибок повторяются.
Причём «точность 95%» сама по себе мало что значит.
Пять лишних замечаний и один пропуск критического требования — совершенно разные риски.
Для проектирования важна не только средняя точность, но и тип ошибки.

5. Определена граница между проверкой и инженерным решением
Представим простой случай.
ИИ сопоставил расчёт и схему:
в расчёте — 3,2 л/с
на схеме — 4,1 л/с
Система правильно обнаружила расхождение.
Но из этого ещё нельзя автоматически сделать вывод:
«Необходимо изменить диаметр трубопровода».

Причина может быть другой:
— схема актуальнее расчёта;
— изменилась нагрузка;
— предусмотрен резерв;
— ошибка действительно есть в принятом диаметре;
— изменилось другое связанное решение.
Поэтому полезная граница выглядит так:
ИИ нашёл → показал данные → специалист принял решение.
И эта граница должна быть определена заранее.

6. Можно измерить производственный эффект
Самая слабая метрика:
«Нейросеть дала ответ за 20 секунд».

Инженеру всё равно, сколько модель генерировала текст.
Гораздо интереснее:
раньше первичная сверка двух комплектов занимала 3 часа;
после автоматизации:
— 15 минут работает система;
— 30 минут специалист проверяет найденные расхождения.
Вот это уже можно считать.
Причём измерять желательно не только время.
Например:
время операции
число найденных расхождений
число пропусков
число ложных замечаний
время проверки результата человеком
Тогда становится понятно, действительно ли решение помогает производству.

А теперь самое практичное.
Допустим, мы хотим использовать ИИ для проверки оборудования в BIM-модели.
Не начинаем с вопроса:
«Какую LLM взять?»
Сначала описываем задачу:
Операция: сверка оборудования
Источник 1: IFC rev.07
Источник 2: спецификация XLSX rev.07
Проверяем: марку, количество, основные параметры
Результат: таблица расхождений
Доказательство: GUID + строка спецификации
Человек принимает решение: при каждом несовпадении
Метрика: время проверки + число пропущенных расхождений

После этого уже имеет смысл решать, чем выполнять задачу:
LLM, RAG, агентом, обычным скриптом или комбинацией инструментов.
И иногда выясняется, что LLM вообще не нужна.
Это тоже хороший результат.

Поэтому я бы сформулировал главное правило внедрения ИИ в проектирование так:
начинать нужно не с модели и не с промпта.

Сначала выбрать одну инженерную операцию и описать:
что приходит на вход → что именно проверяем → какой результат нужен → как его проверить → где принимает решение человек → как измеряем эффект.

Если эти шесть вещей определены, дальше уже можно осмысленно выбирать технологию и проводить пилот.
Именно поэтому нынешнее внимание отрасли к ИИ интересно не само по себе. Гораздо важнее то, что постепенно накапливается практика: какие инженерные задачи действительно удаётся переводить в устойчивые рабочие процессы, как контролировать качество результата и где проходит граница ответственности специалиста.

Чем больше таких кейсов будет разобрано на реальных проектах с понятными исходными данными, ограничениями и измеримым эффектом, тем быстрее разговор об ИИ в проектировании станет разговором не о возможностях технологии, а о нормальной инженерной практике её применения.

Что из описанного у вас уже стало процессом, а что пока держится на одном энтузиасте с нейросетью?
Пишите в комментариях номера пунктов который вызывают сложности, если будет много откликов сформирую отдельный разбор по ним ✋

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
  • 👍 8
Post #393 882
Разбор поверки №7.
В третьем вопросе верных ответов 15 из 34


Ответили 34, 32 и 34 человека. Начну с третьего вопроса: верный вариант выбрали 15 человек, а «дописать "добавь ссылки" и брать» — 18. В комментариях сразу спросили, чем плох четвёртый вариант и почему вопрос вообще спорный.

Почему «добавь ссылки» не спасает. Модель уже написала ответ. Когда её просят дописать к нему источники, она подбирает ссылки под готовый текст, а не идёт искать заново. Номера листов выходят правдоподобные: документ есть, лист есть, а проверки, что цитата действительно на этом листе, в такой схеме нет.

Вопрос и правда на грани, замечание в комментариях справедливое. Если ваша сборка на повторный запрос честно гоняет поиск и возвращает найденное, четвёртый вариант рабочий. Но тогда ссылки стояли бы уже в первом ответе. Раз их там нет, значит поиск их не вернул, и дописывание эту дыру не закрывает.

Спрашивать надо заново и сразу с условием: отвечай только тем, что нашёл в базе, с документом, редакцией и листом, не нашёл — так и напиши. Дальше ссылку проверяет машина, а не глаз: документ и лист существуют, цитата на листе находится. Не разрешилась — строка в работу не идёт, даже если ответ выглядит верным. Ровно это делает второй проход из вчерашнего выпуска №3: он проверяет, существуют ли оба указанных места, а формулировку не трогает.

Первый вопрос, про 20 млрд на карте 8 ГБ: верно ответили 17 из 34. Из ошибавшихся девять выбрали «модель сама сжалась под доступную память», шестеро — что она поместилась целиком, двое — что больше параметров означает точнее. Сжатие делается заранее, когда собирают файл модели: вы скачиваете уже четырёхбитную версию. Под вашу карту на лету ничего не ужимается, что не поместилось в видеопамять, считает процессор. Отсюда 32 секунды загрузки против 5 у семёрки.

Добавлю то, что в 200 знаков пояснения не влезло. Четыре прогона одного вопроса на двадцатке дали четыре разных ответа, а семёрка во всех прогонах отвечала одинаково, хотя находила вдвое меньше, 2 против 4. Связать разброс с нехваткой видеопамяти я не могу: счёт на процессоре обычно даёт тот же ответ, только медленнее. Настройки случайности в тех прогонах я не фиксировал, поэтому причина не установлена. На практику это не влияет: на 8 ГБ берите 7–8 млрд.

Второй вопрос, про В25: 27 из 32. Тут я перестарался с подсказкой, в самом варианте написано «то есть гибридный». Суть всё равно повторю: по смыслу В20, В25 и В30 почти не различаются, как М250 и М300 в выпуске №2. Обозначения, отметки, позиции и номера пунктов ищутся точным совпадением, смысл поверх.

На понедельник. Три вопроса со страницы 8 выпуска №2 задайте своей базе: сведение двух документов с известным ответом, точное обозначение, устаревшая редакция. Провалила хотя бы один, пользоваться ей я бы не стал, пока не настроите.

И тем, у кого вышло 0 из 3, про это в комментариях тоже написали, и что вопросы получились сложные. Собирал я их из мест, где спотыкается сама техника, а не из учебника. Разумное предположение тут как раз и подводит: на проектной документации оно не работает.

#поверка #ЛокальныйИИ #ИИ_для_инженера #AIпесочница

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
  • 🔥 4
  • ❤ 1
Post #389 796
Поверка №7.
Локальный RAG: три вопроса по выпускам №1 и №2


Вчера вышел третий выпуск, а вопросы пока по первым двум: пора проверить, что из них осталось в голове. Три вопроса ниже, и все три про одно место: где модель на своей машине отвечает уверенно, а верить ей рано.

Отвечайте по памяти, выпуски не открывайте. У каждого вопроса есть пояснение, оно откроется после ответа. Вечером в 19:00 соберу ответы и разберу, где ошибались чаще и почему.

Поехали ⬇️
#поверка #ЛокальныйИИ #ИИ_для_инженера #AIпесочница
Post #388
AI песочница инженера pinned «Кто что реально сделал с нейросетями. Пять вопросов, две минуты Коллеги на этой неделе попросили: покажите, кто что реально сделал, кроме оплаты подписки и чата в браузере. И ещё: кто здесь подписан, применяет ли материалы канала, сколько тратит и на что.…»
Post #382 828
Кто что реально сделал с нейросетями.
Пять вопросов, две минуты


Коллеги на этой неделе попросили: покажите, кто что реально сделал, кроме оплаты подписки и чата в браузере. И ещё: кто здесь подписан, применяет ли материалы канала, сколько тратит и на что. Обещал на этой неделе, делаю. Пять опросов ниже, анонимно. В первом, втором и четвёртом один ответ, в третьем и пятом можно несколько. Итоги в воскресенье 20.09, с раскладкой.

#опрос #ИИ_для_инженера #AIпесочница
  • 👍 2
Post #381 852
Состязательная_сверка_выпуск_3.pdf165.4 KB
Полевое руководство, выпуск №3.
235 замечаний к разделу, до меня дошли 83: один запрос, который отсеивает выдумки модели


Остальные 152 отсеял один дополнительный запрос, его и показываю. Документ и железо те же, что в выпуске №2: текстовая часть того же раздела, локальная модель на 8 ГБ видеопамяти.

В августе я разбирал, почему модель выдаёт шестьдесят замечаний вместо пятнадцати, и всё там было про то, как сузить поиск ещё до запуска. Запуск прошёл, список на 235 строк лежит передо мной. Что с ним делать?

Делаю так. Кладу в диалог текст документа и список находок и поручаю модели опровергнуть каждую. Замечание, которое пережило попытку опровержения, беру в работу.
«Перепроверь» тут не работает: роль не сменилась, модель по-прежнему ищет подтверждения и по-прежнему их находит. Роль «опровергни» отнимает у выдумки защиту: два места, которых в документе нет, дословно не процитируешь. Диалог при этом обязательно новый, в старом она станет защищать то, что сама написала.
Запрос копируйте целиком, в диалог он идёт вместе с текстом документа и списком находок:
Ниже приложен текст и список замечаний к нему, составленный другим проверяющим.

Твоя задача — ОПРОВЕРГНУТЬ каждое замечание. Ты не согласовываешь их и не улучшаешь.
По каждому замечанию проверь:
1. Существуют ли оба указанных места в тексте? Приведи цитаты дословно.
2. Действительно ли они противоречат друг другу, или речь о разных предметах?
3. Есть ли в тексте объяснение, снимающее противоречие?
Вывод по каждому замечанию — один из трёх:
ОПРОВЕРГНУТО — указано, чего в тексте нет, либо противоречия не существует;
ПОДТВЕРЖДЕНО — оба места на месте, противоречие реально;
СПОРНО — требуется решение специалиста, объясни почему.
При сомнении выбирай ОПРОВЕРГНУТО.

Самая важная строка последняя. Без неё модель тянет к «подтверждено», соглашаться ей проще. Перекос в сторону опровержения я делаю сознательно, это размен: пропустить одно настоящее замечание мне дешевле, чем разбирать шестьдесят ложных.

Читаю результат в обратном порядке. Сначала «спорно»: модель не смогла ни опровергнуть, ни подтвердить, и обычно именно здесь лежат неочевидные находки. Потом «подтверждено», их проверяю руками по документу. «Опровергнуто» не читаю. Через раз пролистываю списком, чтобы убедиться, что механика не рубит лишнего.

Теперь цифры. Первый проход покрыл все 197 страниц текстовой части раздела за 17 прогонов и выдал 235 замечаний. В выпуске №2 фигурирует 61 страница: это восемь прогонов, дошедших до конца, по ним я мерил время. Замечания считал по всем семнадцати.
Опровергнуто 152, это 64,7%.
Подтверждено 48.
Спорно 35.

Обошлось это в среднем в 2,7 обращения к модели на каждое замечание, сверх того обращения, которым оно было порождено. Сколько из дошедших 83 оказались по-настоящему полезными, я не считал, замерил только отсев.

Пропущенное первым проходом второй не найдёт, он работает только с готовым списком. Точную цитату от неверного истолкования тоже не отличает. Часть настоящих замечаний уходит в отсев вместе с выдумками, про этот размен я сказал выше. Отброшенное при этом остаётся вашим решением, ответственность модель не забирает. И ещё условие: второму проходу нужно, чтобы первый требовал на каждую находку два конкретных места в тексте, иначе опровергать нечего. Полный запрос для первого прохода — в файле к этому выпуску и в пособии по ПОС, на странице про фильтры.

Оба блока запроса, порядок чтения и замеры — одним файлом, следующим сообщением. Попробуйте на своём документе и напишите, сколько отсеялось у вас. Соберу по разным типам документов и опубликую.

#ЛокальныйИИ #проверка #ИИ_для_инженера #AIпесочница

AI песочница инженера в Дзене 📱|в МАХ 📲|в VK 📱|в VC|
  • 👍 4
Post #379 895
Кратко о результатах участия в отраслевом фестивале монтажников и проектировщиков инженерных систем А-ФЕСТ

Во вторник принял участие с докладом на тему "Единая модель данных" на А-ФЕСТ

Что хотел бы отметить — несмотря на сокращенное время для доклада темы, в целом, концептуально удалось донести его ключевые мысли и идеи до аудитории. Если кратко, то грамотное построение структуры обмена данными между участниками мероприятий инвестиционного характера напрямую влияет на их результативность.

Особо подчеркну ее важность ввиду возникающих неблагоприятных последствий из-за некорректно принимаемых решений.

После выступления командой спикеров приняли участие в игре "Что? Где? Когда?" которую вел магистр игры Александр Друзь. Удалось занять 5-е место (из 14), несмотря на тот факт, что команда очно собралась впервые)

Кто не успел задать вопросы по докладу - пишите их в комментариях.

#АФЕСТ #проектирование #ИИ_для_инженера #AIпесочница
  • 👍 7
  • 🔥 4
Older posts →

About this channel

How can I read @ai_prompt_eng without a Telegram account?
TGViewer shows the public web preview Telegram publishes for AI песочница инженера: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does AI песочница инженера have?
AI песочница инженера (@ai_prompt_eng) has 2.38K subscribers on Telegram, refreshed roughly every 30 minutes.
Does AI песочница инженера know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →