TGViewer
Channel Public Channel
AI Для Задротов

AI Для Задротов

@ai_for_geeks

Весёлый канал от @arturpanteleev про AI в разработке

- AI Engineering
- Prompt и Context Engineering;
- Agentic Engineering и Multi-Agent Systems;
- Loop Engineering и Harness Building;
- Vibe Coding и Coding Agents;
- Workflow Orchestration
Subscribers
462
Photos
32
Videos
1
Links
32
Recent Posts 20 shown
Post #51 340
FRONTIER VS ДЕШËВЫЕ МОДЕЛИ

Когда я начал погружаться в вайбкодинг, возник вопрос: нужно ли рвать жопу, чтобы всегда и всё делать на самой крутой модели? На первый взгляд ответ очевиден: frontier-модель лучше рассуждает и иногда одним prompt заменяет половину orchestration. Значит, можно выкинуть лишний harness, отдать ей задачу и пойти пить кофе. Меня смущает, что наш основной технологический процесс (а software engineering им является) внезапно становится набором надежд на хорошее настроение модели. Если хотите, позже расскажу как работают LLM, но пока договоримся, что мы понимаем, что она выдает вероятностные, а не правильные ответы

Если этапы workflow можно определить формально, они должны жить в коде. Когда обязателен review, какие поля нужно заполнить, какой budget нельзя превышать и что проверить перед deployment - это инварианты системы, а не вопрос вкуса LLM. Просить модель каждый раз придумывать ваш бизнес-процесс примерно как позволить стажёру перед каждым релизом импровизировать регламент выкладки.

Модели стоит оставлять эвристики: практические способы искать решение, когда данных мало или вариантов слишком много. Например, предположить причину бага, выбрать, какой файл изучить первым, или заметить подозрительное место в коде. Это обоснованные догадки, которые помогают двигаться дальше, но не гарантируют правильного результата. "Без пройденных тестов не мержим" - инвариант, который обеспечивает код. "Похоже, сломалось из-за кеша, проверим его первым" - эвристика, которую предлагает модель. Так LLM остаётся заменяемым компонентом: сегодня GPT, завтра Claude или Qwen, а правила процесса не приходится перепридумывать под характер каждой из них.

Но тезис "всегда берём самую дешёвую" тоже слишком красивый. Иногда frontier-модель решает задачу сразу, а вокруг слабой приходится строить такой компенсирующий космолёт, что экономия на токенах теряется на фоне времени и усилий команды. Поэтому критерий не цена одного вызова и не место в benchmark. Нужна самая дешёвая модель, которая стабильно проходит требования системы, с учётом всех затрат на получение результата.

Правда, если требований к системе, продукту или агенту нет, то и понять, какая модель им соответствует, невозможно) Подозреваю, что у многих из нас нет работающих evals или другого способа оценивать всю систему целиком. Есть несколько удачных запусков и ощущение "ну эта вроде умнее". Но это ещё не критерий качества.

Кто-то скажет: да у меня и системы-то никакой нет. Но если вы используете Codex, Claude Code или OpenCode для программистских задач, система уже есть: модель, агентское ПО, ваши инструкции и проверка результата. Даже если вы не строите циклы и пайплайны, а просто болтаете в микрофон, потом ревьюите код руками, это тоже агнетская система разработки ПО. Пусть и хуевая, собранная из агента и кожаного ревьюера.

Так вот, вернёмся к стабильности. Без собственных evals легко принять пару удачных ответов за улучшение, а потом ловить странную херню в production. Модели будут меняться каждый месяц, но ваши инварианты, тесты и измеримый набор задач должны жить дольше. Иначе это не AI engineering, а дегустация чат-ботов по настроению.

Так что не гонитесь за дорогими моделями! А то будете как админы телеграмм каналов, которые отрабатывают каждый пук корпораций. Стройте процессы, нарабатывате инженерный капитал и ежеденевно улучшайте его. Переключить модель на "подороже" успееет всегда.

AI Для Задротов
  • 👍 8
  • 🔥 2
Post #49 355
КАК Я КРУТИЛ AGENT LOOP РУКАМИ ВМЕСТО ТОГО, ЧТОБЫ ЕГО ЗАПРОГРАММИРОВАТЬ

Вчера я понял, что над задачами по формированию продуктового backlog работаю с AI самым тупым способом: выполняю руками функции оркестратора. Я попросил одну модель составить backlog из нашего диалога в файл, потом отдал второй его разъебать и кинуть результат в соседний файл, третьей - разъебать разъёб второй, а затем вернул первой разбор третьей. Модели работали командой, но цикл между ними крутил я через консоль и файлики между которыми я переключался, такой особенно уставший кожаный компонент посередине. Почему я не догадался применить подход с циклами, который давно использую при программировании, история умалчивает.

По сути, я руками собрал review/revise loop. Один агент создаёт результат, другой делает review, следующий исправляет замечания, после чего всё снова отправляется на проверку. Цикл продолжается, пока результат не принят, не закончился budget или не придёт человек. Обычный while, который я зачем-то исполнял сам.

Тут важно различать внутренний и внешний agent loop. Внутри coding agent уже крутится свой цикл: модель чёто решает, вызывает tool, получает результат и выбирает следующий шаг. А я строил внешний цикл, где отдельные запуски моделей были исполнителями, файлы хранили state, а я определял переходы. То есть внутри каждого агента работал маленький оркестратор, а снаружи сидел я и работал большим.

Самый простой вариант такого внешнего цикла - Ralph Loop. Скрипт запускает агента со свежим контекстом, тот читает задачу и состояние из файлов, делает следующий шаг, сохраняет результат и умирает. Новая итерация опять начинается с чистой головы, поэтому история не раздувается бесконечно, а context rot меньше влияет на работу. По сути, Ralph - это внешний while вокруг агента, и в этом вся его прелесть.

Если одного while становится мало, потому что появляются ветвления, review, retry и human approval, цикл естественно вырастает в граф. Каждый шаг становится вершиной графа, переход - ребро, а задача, артефакты и замечания лежат в общем state. LangGraph помогает описывать такие схемы, но сами концепции до боли знакомы любому разработчику хоть сколько-то распределённых систем. Просто теперь один из узлов не вызывает сервис, а просит LLM подумать(а де факто тотже вход/выход).

Еще интересно как оценивать все эти результаты - руками, тестами, нейронкой судьей, консилиумом нейронок и кожаных...Но это другая исторя

Короче, важно не количество кругов на диаграмме. Важно, кто хранит state, выбирает следующий шаг, проверяет результат и останавливает карусель. Именно из такой ручной хуйни у меня вырос Dev Task Workflow, а затем и AI Team(про него будет отдельная серия постов). Ну и как видите, не забываю устраивать детокс и работать циклом самому)

AI Для Задротов. Подписаться
  • 👍 6
Post #48 349
Знаете, я не лучший образец для подражания, далеко не самый топовый IT блогер, если меня вообще так можно назвать. Да и коммуникация с подписчиками иногда хромает, прямо скажем. А сколько я сомнтительной хрени рекламировал на @ebanoePHP в своё время...

Но я хотя бы не держу вас за умственно отсталых, которые не в состоянии почитать новости без меня. Пока другие блохеры кормят вас "сладким хлебом" как в Зелёном Слонике, я пыхчу(поняли да, отсылку "ПЫХ" типо, что я пхпшником был, не все поймут) над качественным контентом. Цените меня пока я жив и относительно здоров! А лучше звездочек накидайте или бустов!

AI Для Задротов. Подписаться
  • 👍 7
  • 😁 5
  • 🔥 3
Post #47 372
ЧАСТЬ 2: КАК ВООБЩЕ ОБУЧАЕТСЯ LLM - ВЕСА, PRE-TRAINING, POST-TRAINNING, GRADIENT

Начало тут

После разговора про дистилляцию у меня возник логичный вопрос: а как вообще обучается языковая модель? Интернет состоит не только из документации, научных статей и рецептов бабушки. Например, мы гуглим - как сделать чай? В интернете с одинаковой уверенностью могут написать "вскипяти воду", "насри в кастрюлю" и "укради чай у соседа". Почему после обучения модель обычно предлагает первый вариант, а не устраивает нам специальную кулинарную операцию?

На первом этапе модель учат решать до смешного простую задачу - угадывать следующий кусочек текста. Ей показывают начало предложения, она выдаёт вероятности продолжений, после чего ответ сравнивают с реальным текстом из обучающих данных. Если модель сильно ошиблась, получается большое значение ошибки, которое называют loss. Затем алгоритм немного изменяет веса, чтобы в следующий раз правильный вариант стал вероятнее.

Модель при этом не решает, какой автор в интернете умный, а какой долбоёб(потому что все такие). Нормальные инструкции по приготовлению чая просто встречаются намного чаще и в более согласованном контексте, чем советы насрать в чайник. Поэтому обычное продолжение получает большую вероятность, а случайная херня остаётся где-то на периферии распределения. Конечно, если сами данные систематически забиты мусором, магического детектора истины у модели не появится и мусор она тоже выучит.

Веса можно представить как миллиарды крошечных ручек настройки. Одна ручка не хранит отдельно факт "Москва является столицей России", потому что знания распределены по огромному количеству параметров. Модель делает предсказание, считает ошибку, а gradient descent определяет, в какую сторону немного сдвинуть эти ручки. Один шаг почти ничего не меняет, но после миллиардов повторений в весах оседает чудовищное количество связей между словами, фактами и контекстами.

Поэтому фраза "столица России" почти всегда продолжается Москвой, а Санкт-Петербург появляется рядом с уточнениями вроде "культурная" или "северная". Модель не достаёт значение из одной строки таблицы, а воспроизводит выученное распределение вероятностей. Для фактического вопроса один вариант может доминировать, а в вопросе "какой язык программирования лучший" вероятности размазаны между несколькими ответами. Конкретный результат там уже сильнее зависит от контекста, настроек генерации и последующего обучения.

После pretraining модель много знает, но остаётся просто очень мощной продолжалкой текста. На этапе post-training ей показывают, как выполнять инструкции, соблюдать формат, признавать неопределённость и не отвечать человеку как случайный форумный псих. Значительная часть привычного поведения ChatGPT появляется именно здесь, хотя базовые знания модель получила раньше. И вот это поведение тоже можно передавать через дистилляцию, потому что оно статистически проявляется в ответах учителя.

Студент получает вопрос, пытается ответить, сравнивает результат с ответом сильной модели и через тот же gradient descent меняет свои веса. Если примеров достаточно, он перенимает не только факты, но и способы декомпозиции, проверки гипотез и общения с пользователем. Никакой магии и переливания цифровой души тут нет, просто очень много качественных тренировочных пар. Но после этого уже понятнее, почему чужие ответы могут оказаться ценнее, чем очередная выгрузка сырого интернета.

Вот так то! Не сказать, чтобы это прям было полезно в ежедневной работе, но мне всё же интересно, как на низком уровне устроена эта магия, которая за нас будет теперь программировать всю жизнь.


AI Для Задротов. Подписаться.
  • 👍 4
  • 🔥 3
Post #46 300
Ого, 10 лайков 😊 Ща вторую часть выложу
Post #45 306
AI Для Задротов КАК ОБУЧАЮТЧСЯ LLM. ЧАСТЬ 1: МАСК, OPENAI И ДИСТИЛЯЦИЯ В конце прошлой недели, весь AI-интернет обсуждал, кто в этот раз пидор, Маск, OpenAI или все сразу. у нас появилась новая серия корпоративной Санта-Барбары. Напомню, SpaceX купила Cursor, после чего…
Вам вообще интересны такие длинные посты с разбором фундаменталки или нет? Если интересны, поставьте лайк, скину вторую часть, а если нет дизлайк, и я вернусь к однострочным шуткам в духе "эх ебаный эйай оставил меня без работы, буду проституткой"
  • 👍 32
Post #44 307
КАК ОБУЧАЮТЧСЯ LLM. ЧАСТЬ 1: МАСК, OPENAI И ДИСТИЛЯЦИЯ

В конце прошлой недели, весь AI-интернет обсуждал, кто в этот раз пидор, Маск, OpenAI или все сразу. у нас появилась новая серия корпоративной Санта-Барбары. Напомню, SpaceX купила Cursor, после чего OpenAI сообщила, что собирается перестать поставлять ему свои модели. Официально причина в том, что OpenAI больше не уверена(лол так можно??) в соблюдении своих условий компаниями Маска. Но в комментариях к этой истории постоянно всплывает другое слово - distillation.

И вот тут я понял, что слово вроде знакомое, но понимал я его где-то на уровне "одна нейронка постоянно что-то спрашивает у другой". Почему OpenAI вообще должно волновать, что конкурент задаёт её модели много вопросов? Я тоже каждый день мучаю ChatGPT, но Grok у меня в кладовке пока не завёлся. Опять, пришлось разбираться самому!

Дистилляция - это когда есть большая и умная модель-учитель, а рядом модель-студент, обычно меньше, дешевле и тупее. Учителю дают много задач, сохраняют ответы, а затем обучают студента воспроизводить похожий результат. Веса учителя никто не копирует и в его мозги отвёрткой не залезает. Студент видит только вопросы и ответы, но даже этого хватает, чтобы перенять довольно много полезного.

Представьте прожжёного сеньора, рядом с которым полгода сидит джун и смотрит ему в рот, как тот разбирает задачи. Сеньор не просто сообщает правильный ответ, а показывает, как раскладывать проблему, какие предположения проверять и когда задавать уточняющие вопросы. Через некоторое время джун начинает рассуждать подозрительно похожим образом, хотя исходники мозга сеньора ему никто не выдавал. С моделями примерно та же херня, только вместо полугода у нас миллионы примеров.

Причём студенту необязательно становиться универсальным ChatGPT на минималках. Допустим, нам нужна модель, которая умеет только готовить блюда из яиц, но делает это охуенно: учитывает продукты, диету, время и доступную посуду. Можно спрашивать большую модель только про эту область, собрать ответы и обучить на них маленький EggGPT. Знать историю Китая и писать рэп-баттлы между базами данных ему вообще не обязательно.

Почему тогда крупные компании боятся дистилляции, если для неё всё равно нужны вычисления, данные и инженеры? Потому что сильная модель уже проделала гигантскую работу: переварила интернет, нашла закономерности и научилась нормально решать задачи. Конкуренту остаётся не повторять весь путь, а собрать концентрированную обучающую выборку из готовых ответов. Это всё ещё дорого и сложно, но потенциально сильно дешевле, чем выращивать сопоставимое качество с нуля.

Сама дистилляция абсолютно нормальна, и компании постоянно используют её для собственных моделей. Скандал начинается, когда учителем без особого согласия становится коммерческая модель конкурента, а запросы отправляются промышленными объёмами именно ради обучения. Технически механизм тот же, но внезапно становится важно, кто оплатил создание учителя и разрешал ли он превращать свои ответы в чужой датасет. Поэтому боятся не человека, который спросил рецепт омлета, а фабрики, которая круглосуточно вытягивает знания и поведение модели.

Я хз как к этому относится. С одной стороны, это не воровство, по сути модель открыта и конкуренты даже платят за вызовы... Но с другой всё равно как-то хреново получается) А вы что думаете?

AI Для Задротов. Подписаться.
  • 👍 10
  • 🔥 2
Post #43 408
Кто какую модель для Speech-to-Text использует?

Недавно я писал пост про Handy и рассказывал, что практически перестал печатать — теперь почти всё наговариваю. Но недавно возник вопрос: а можно ли сделать распознавание ещё лучше, просто выбрав другую модель?

До этого я по дефолту использовал Nemotron Streaming 3.5. Модель неплохая, но мне стало интересно найти лучший вариант. Спустя какое-то время мы с GPT отобрали четыре модели для сравнения: GigaAM v3, Nemotron Streaming 3.5, Parakeet V3 и Whisper Large V3 Turbo.

Тестировал так: читал текст(скину его в комменты) и сравнивал результаты

GigaAM v3 💩💩💩

Из плюсов — самая маленькая модель, около 250 МБ. На этом плюсы заканчиваются, потому что у меня она показала себя как полное говно.

Несмотря на то что модель специализирована под русский язык, даже с русской речью она справилась хуёво. А когда в речь попадали английские слова, что у любого программиста происходит постоянно, начинался полный ужас. В итоговый рейтинг даже не ставим. В целом, ничего хорошего от Сбербанка я и не ожидал, надеюсь карту можно закрыть уже в любом отделении а не "где открывали туда и приходите".

Nemotron Streaming 3.5 👍

Этой моделью я пользовался по дефолту. Ошибок было достаточно, но при диктовке больших текстов это не так страшно: из контекста обычно понятно, где именно модель накосячила. В целом качество хорошее.

Главный плюс — настоящий streaming. Ты говоришь и сразу видишь live transcription: не нужно заканчивать запись, ждать обработки и только потом получать текст. Очень приятный UX.

Parakeet V3 👍

Многие считают её лучшей моделью из всех доступных в Handy, но мне она как-то не зашла. Parakeet показала себя лучше, чем Nemotron, и тем более лучше, чем GigaAM, однако на моём голосе, манере речи и наборе терминов всё равно проиграла Whisper.

Плюс в моей конфигурации нужно закончить запись и немного подождать, пока появится транскрипция. После streaming-модели это уже ощущается как небольшой шаг назад.

Whisper Large V3 Turbo 💪💪💪

А вот это мой победитель. Модель очень хорошо распознаёт и русские, и английские слова, нормально переваривает смешанную речь, code-switching и технические термины.

Да, после записи приходится немного ждать, так же как и с Parakeet. Но итоговое качество для меня оказалось важнее streaming, поэтому пока остаюсь на Whisper Large V3 Turbo.

Мой субъективный рейтинг:

Whisper Large V3 Turbo > Parakeet V3 > Nemotron Streaming 3.5 >>> GigaAM v3.

Ещё в Handy можно собрать словарь Custom Words и добавить туда имена, названия продуктов и технические термины, которые модель постоянно воспринимает херово. Также можно подключить AI post-processing, чтобы дополнительная модель исправляла ошибки, пунктуацию и форматирование.

Теоретически можно заморочиться и с fine-tuning под собственную речь и domain vocabulary, но до такого уровня задротства я пока не дошёл.

Такие дела. Надеюсь, кому-то было полезно.

А чем пользуетесь вы? Какие приложения и Speech-to-Text-модели пробовали? Как вообще взаимодействуете с компом в 26 году?

AI Для Задротов. Подписаться.
  • 👍 7
Post #42 411
Как дела, бандиты?

Я тут осознал, что AI полностью изменил мою жизнь.

Смотрите. Одновременно делаю два ремонта. Несколько разных агентов пытаются собирать дизайн-проекты для разных помещений, а я тока подхожу раз в несколько часов, надиктовываю правки и ухожу.

Учу английский: разговорная практика через GPT Voice, а игры на слова и грамматику собрал сам - буквально по одному промпту на каждую.

Занимаюсь спортом, корректирую тренировки по боксу и в тренажёрке, считаю КБЖУ и калорийность пищи. Разумеется, всё через AI.

На работе пишу полностью автоматизированную AI-систему, которая будет отвечать на клиентские обращения в поддержку без участия человека. Ещё она будет проводить ретроспективы, проактивно искать места, где клиенты могут наебнуться, и предотвращать это заранее.

Параллельно стараюсь находить время на развитие своего оркестратора.

Из pet-проектов у меня набор скиллов для разработчика и полноценный роботизированный workflow для software development-команды: от постановки задачи до готового результата.

Также очень много работаю над Life Brain. Это моя личная база данных, где я фиксирую жизненные ценности и накопленные знания, а на их основе формирую долгосрочные и краткосрочные планы и задачи на день.

Технически это структурированные Markdown-файлы, к которым я написал MCP-сервер. К нему обращается мой виртуальный помощник и может, например:

— добавить планы на день;
— напомнить, чего мне важно достичь к концу 2026 года;
— посчитать, сколько денег не хватает на очередную инвестицию;
— связать текущие задачи с долгосрочными целями.

Ещё у меня крутится дохуя «умных кронов» — так я называю scheduled tasks в CoWork и GPT Work. Они мониторят цены на авиабилеты, аренду вилл, скидки на технику и всё остальное, что мне лень проверять руками. Каждый день запускаются по несколько раз и сообщают об успехах.

Думаю, про то, как я собираю в дайджесты информацию об IT, новостях и локальных событиях, можно даже не рассказывать.

И только блог я бережно пишу руками. Хотя времени на него в итоге почти не остаётся :(

Интересная хуйня получается: производительность вроде выросла в сто раз, а чувство, что ты вечно ничего не успеваешь и постоянно тормозишь, только усилилось.

Про написание ебучего рэпа про каждую жизненную ситуацию в Sunno и мультики в MiniMax я уже молчу...

Не уверен, что у меня вообще остался головной мозг, потому что всё, что можно делегировать нейронкам, я уже им делегировал.

А как у вас с этим? Насколько плотно вы подсели на иглу искусственного интеллекта? Какие сферы жизни уже покрыли им полностью, а какие тщательно от него бережёте?

Поделитесь, приятно знать что не вы одни ёбнулись!

AI Для Задротов. Подписаться
  • 👍 6
  • 😁 3
Post #40 490
Парни(девочки), извините, что нихуя не пишу. На канал просто вообще не находится времени.

Хотя рассказать есть про что:

- как я настраивал AI-агентов на своих VPS через OpenRouter и подключался к ним с Android через Termius по SSH
• как разворачивал Ollama на локалке и пытался юзать ее для решения реальных задач
• как на работе влез в проект на TypeScript(который я до этого ни разу не видел) и в итоге ебанул рефакторинг с pull request'ом на 600+ изменённых файлов
• как замутил себе полноценный second brain на md файлах, dev версии openGPT и кастомном mcp сервере

Короче, происходит куча всего пиздец интересного, чем реально хочется поделиться. Но времени - нихуя.Зато я внезапно нашёл, у кого времени овердохуя. У чуваков, которые в 2026 году продолжают сраться в комментариях ЗА PHP!!!

https://habr.com/ru/articles/1071378/

Ебаный в рот! Сейчас 2026 год, не 2006. Как, можно до сих пор всерьёз спорить о том, хороший PHP язык или плохой? Сравнивать его с другими языками, доказывать кому-то что-то, писать простыни, ебашить по двадцать ответов незнакомому человеку из интернета. Делать нехуй.

Я PHP, например, очень благодарен. Если бы не он, я вообще хуй знает, где бы сейчас был. Вряд ли достиг бы того, чего достиг в финансовом плане. Вряд ли уехал бы из родного города. Вряд ли вообще сложился бы как специалист так, как сложился. PHP для меня был охуенным трамплином в профессию.

И вообще, для своих задач и для своего времени это был классный инструмент. Мне даже реально нравилось смотреть, как язык год за годом эволюционирует, как в него постепенно завозят вещи, которые раньше казались чем-то из другого мира. Вам может не нравится итоговый результат, но колоссальный прогресс за годы отрицать не возможно. Но мне насрать если какому-то Васе из Новоурюпинска он не нравится!


И сам раньше участвовал в этих священных войнах. Могдоказывать, почему один язык лучше другого. Но СЕЙЧАС я вообще не понимаю — нахуя? Я уже код, который коммичу в прод, не читаю практически. Могу даже не знать на каком языке вайбкожу проет. А люди всё ещё находят время сидеть и сраться из-за PHP. Причём не пять минут!

Там под сотню комментов!

Люди реально открывают ноутбук, наливают себе чай, садятся поудобнее и думают:

«Так. Сейчас я объясню этому долбоёбу, почему PHP - нормальный язык».

Или:

«Сейчас я наконец-то докажу всему интернету, что PHP — говно».

Блядь, откуда у вас столько свободного времени? У меня две версии:

- Либо это боты
- Либо пациенты психлечебницы, которым зачем-то раздали интернет.

Какие у вас варианты? Что вообще должно произойти в жизни человека, чтобы в 2026 году он увидел спор про PHP и подумал:

«О, вот сюда я сейчас, блядь, зайду и объясню, как обстоит ситуация на самом деле».

Только не вздумайте читать эту хуйню. Максимум попросите LLMку сделать кратчайшую выжимку по популярным комментам.Но ничего интересного вы там не увидите.

Тот случай, когда я всё понимаю, но этого не понимаю

AI Для Задротов. Подписаться
  • 😁 14
  • 👍 2
Post #39 548
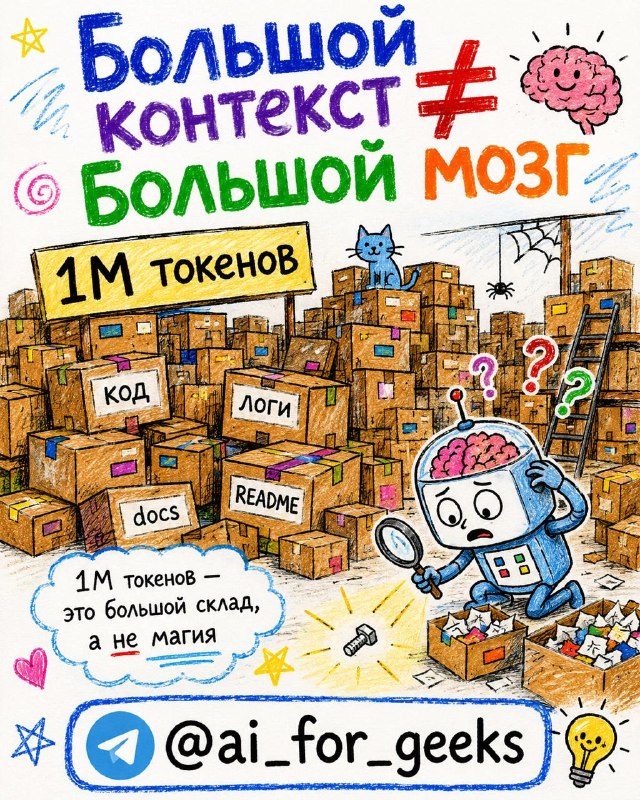
🚨 В Codex завезли контекстное окно до 1 МИЛЛИОНА токенов.

И, судя по реакции, у части вайбкодеров случился коллективный оргазм:

🤯 МИЛЛИОН ТОКЕНОВ!!! ТЕПЕРЬ МОЖНО ЗАПИХНУТЬ В МОДЕЛЬ ВЕСЬ РЕПОЗИТОРИЙ!!!

Можно. Но давайте разберёмся 👇

🪣 1. Контекстное окно

Т.е сколько инфы модель технически может получить за один вызов.

Код, документацию, историю диалога, логи, результаты работы инструментов, README вашего гея тимлида из 2019-го, который с тех пор никто не открывал.

Если окно 1M токенов, значит всё это потенциально можно засунуть внутрь одновременно. По сути, это просто ёмкость контейнера Больше всякого говна теперь влезет! 🎉

Но отсюда вообще не следует, что модель одинаково хорошо воспользуется каждым из этих миллиона токенов.

🧠 2. Эффективный контекст

Это не официальный параметр Codex. Я называю так ту часть информации, которую модель в конкретной задаче реально способна:

🔹 найти
🔹 связать с задачей
🔹 правильно интерпретировать
🔹 использовать в нужный момент

И тут нет магического числа:

context window = 1 000 000
effective context = 427 322

Какой «эффективный контекст» у Codex?

Да я ни ебу 😄 Не спрашивайте у меня. Никто вам не ответи.

Потому что всё зависит от задачи, структуры контекста, количества мусора, противоречий и даже от того, где находится нужная информация.

Файл может физически лежать в контексте, но модель может:

❌ не понять, что он важен
❌ зацепиться за устаревший код
❌ пропустить связь между файлами
❌ смешать старые и новые инструкции
❌ утонуть в нерелевантных деталях

👀 «Модель это видит» ≠ «модель этим нормально воспользуется».

🥀 3. Context rot

context rot

Context rot не значит, что после условных 300К токенов контекст внезапно протухает и модель превращается в овощ. Это скорее название эффекта, когда по мере раздувания контекста модели становится сложнее стабильно использовать нужную информацию.

Нужный кусок всё ещё внутри окна. Он никуда не исчез. Но вокруг него уже лежат:

🗑 старые сообщения
🗑 ненужные логи
🗑 устаревшие решения
🗑 противоречащие друг другу инструкции
🗑 результаты двадцати предыдущих шагов агента

И сигнал начинает тонуть в шуме.

Грубо говоря: контекст не закончился, а качество работы с ним уже начало портиться.

Вот это особенно важно понимать. Проблема длинного контекста не только в том, влезет информация или нет.

Проблема ещё и в отношении: 📡 signal / noise

Если нужных вам 5К токенов закопаны внутри 700К токенов мусора, сам факт наличия окна на миллион не делает ситуацию автоматически прекрасной.

И именно поэтому огромное контекстное окно не убивает context engineering.

Скорее наоборот.

Чем больше информации ты МОЖЕШЬ дать модели, тем важнее понимать, что именно ей НУЖНО дать.

Не надо так: "🤖💬 НА, БЛЯТЬ, ВОТ ТЕБЕ 800К ТОКЕНОВ МОЕГО МОНОРЕПО. РАЗБЕРИСЬ"

Хороший AI-агент:

🔎 находит нужные файлы
📚 подтягивает релевантную документацию
🗑 не тащит в контекст всё подряд
🗜 сжимает старую историю
📌 сохраняет важные ограничения задачи
🔄 обновляет контекст по мере работы
🧹 выбрасывает то, что больше не нужно

Кстати, параллельно с огромными контекстными окнами разработчики продолжают пилить compaction, retrieval, tool search и другие способы управления контекстом.

Ведь проблема никогда не была только в том, сколько токенов помещается, важно,
какие токены там находятся, сколько среди них шума и насколько хорошо модель умеет воспользоваться нужными В МОМЕНТЕ.

Так что если после новости про 1M вы решили, что context engineering больше не нужен и теперь можно просто хуярить модели весь репозиторий целиком, то..

📦 Большой контекст это большой склад.

🥀 А большой склад ещё и проще засрать.

🧠 Большой контекст ≠ эффективный мозг.

Думайте, и не ведитесь на маркетинговую шелуху ❤️

AI Для Задротов. Подписаться
  • 👍 6
  • 🔥 1
  • 🤔 1
Post #38 545
Редко рекомендую какие-либо видео, но вот этот подкаст из подлодки мне прям зашёл.

https://www.youtube.com/watch?v=JU13uM2b7WM

Гость программы - опытный дядька(можно сказать дедок) с огромнейшим опытом в IT, настоящий олд. В контексте все нашей модной AI движухи интересен именно как контрибьютов в bmad, хоть я им и не пользуюсь, но знаю что многим нравится.

Так вот разговор идёт про SDD причем разговор интересный, с упором на практическую часть именно, как чел пришёл к этому как он юзает, его команда и как вы его сорее всего тоже юзали, даже если не подозревали. Спойлер: если вы сначала ебашить ТЗ через plain mode а потом запускается новая сессия с пробросом этого ТЗ это уже может считаться SDD на минималках.


Не совсеми тейкам из видео я согласен, например, чел читает код, хотя мы знаем, что код читать уже не нужно, как учил дядюшка Боб. Более того он утверждает, что больше половины рабочего дня тарить на ревью(лол). Также он советуют всегда юзать самые дорогие модели с максимальным эфортом с чем я ещё больше не согласен. Но все равно позиция здравая, мысли интересные. Помогло мне словить пару инсайтов и немного упорядочить какие-то свои соображения. Короче, рекомендую

P.S. Один из ведущих, мне показалось, чего-то хапнул перед интервью и вообще тяжко выкупает что тут происходит) Укадайте какой.

P.P.S. Пацаны, вы кидайте реакции(хотя бы бесплатные, но лучше звёзды). Позитивные или негативные(хоть какашки с клоунами), а то я хз что вам нравится, а что нет.

AI Для Задротов. Подписаться.
YouTube Spec-Driven Development на практике | SDD, BMAD, OpenSpec, вайб кодинг | Podlodka Podcast #486 В разработке с агентами нам больше всего не хватает контроля за результатом и уверенности в нем. Один из способов их получить – использовать подход Spec-Driven Development, в котором перед тем, как отправить агента писать код, мы готовим ему понятное описание…
  • 👍 16
  • 🔥 5
  • 🤡 2
Post #36 582
ЦЕНЫ ВЫРОСЛИ В 12 РАЗ!

Все айти чаты сейчас бурлят гавном по поводу того, что DeepSeek повысила цены на тарифы практически в десять раз(от 6 до 12, если быть точнее), за счёт повышения базовой стоимости, внедрения пиковых часов(лол, AI блэкаут) и прочих финтов. Неприятно, но вполне закономерно, а главное это никак не влияет на меня и мою работу.

В тысяча первый раз повторяю: вы должны строить свой РАБОЧИЙ ПРОЦЕСС НЕЗАВИСИМО ОТ КОНКРЕТНОГО ПРОВАЙДЕРА И КОНКРЕТНОЙ МОДЕЛИ. Любая завязка на одного поставщика - вендорлок, зависимость и потенциальная уязвимость вашего бизнеса(или бизнеса вашего хозяина). По факту завязывать всю работу на какую-то конкретную модель конкретного провайдера, это гарантировано подставить свой хуй под выстрел из дробовика в будущем.

Да, возможно, для вас эта новость прошла незаметно, дипсиком поьзуются меньше, чем двумя другими провайдерами. Но помяните мое слово, когда такую же шляпу исполнит Anthropic или OpenAI(не суть под каким предлогом) - пиздеца увидите гораздо больше.

Поэтому мы обязательно строим нормальные процессы:
- Внедряем абстрактный слой поверх API, чтобы смена провайдера делалась правкой одной переменной окружения, а не переписыванием половины кода.
- Используем роутинг запросов: дешёвые быстрые модели для простых задач, дорогие и умные - только когда действительно надо.
- Настраиваем автоматический fallback - если одна модель легла или начала дико тормозить, запрос уходит на другую без ручного вмешательства.
- Детерминируем максимум шагов: промпты, схемы ответов, скрипты валидации, парсинг - всё должно быть зафиксировано и версионировано, чтобы при переезде на другую модель вы получали тот же результат, а не сюрпризы.
- Регулярно прогоняем бенчмарки на своих задачах, а не верим воздуханам из твиттера.
- Держим в запасе минимум двух-трёх провайдеров и локальные модели для критичных сценариев, где внешнее API недоступно.

Мир постоянно меняется и не всегда в лучшую сторону - политические санкции, экстренные поднятия ценя, аварии в сервреных - вы должны быть готовы ко всему этому, и решать такие проблемы одним переключением тумблера, а в идеале вообще иметь интеллекутальную систему фоллбека. Давайте не забывать, что мы инженеры, а не вайбкодинг monkey всё таки.

AI For Geeks. Подписаться
  • 👍 9
  • 🔥 5
Post #34
Channel photo updated
Post #33 675
Не знаю, корректно ли публиковать такое, но вайбкодеры часто забывают убрать ключи из проектов. Я думаю они просто не знаю даже что такое ключи)


С фильтрацией и аналогами под другие модельки сами справитесь)

Интересный момент заключается в том, что если вы вобьете в GitHub-поиск OPENAI_API_KEY, CLAUDE_API_KEY или любую комбинацию для хранения ключа от других нейронок, то https://github.com/search?q=OPENAI_API_KEY

Я лично ими пользоваться не буду и информацию предоставляю лишь для того, чтобы вы не обосрались) Но тем не менее можно и сэкономить, если для вас это приемлимо. Можно вообще автоматизировать этот процесс и написать сканер, который будет постоянно сканировать гитхаб на наличие новых ключей, и добавлять в ваш пул и вайбкодить бесплтано)

AI Для Задротов. Подписаться
  • 😁 6
Post #32 702
AI ROADMAP ДЛЯ РАЗРАБОТЧИКА

https://ai-for-geeks.github.io/roadmap/

Последнюю неделю постов практически не было.

Я действительно поймал себя на какой-то растерянности и потерянности касательно того, куда мне вообще развиваться. Да, я вроде неплохо двигаюсь, осваиваю разные паттерны агентской разработки и вижу, что уже ушёл чуть дальше, чем средний сеньор. Но меня всё равно мучило ощущение, что я не понимаю, куда двигаться дальше.

Поэтому практически всю неделю я читал, изучал и смотрел разные best practices, чтобы понять, чего мне не хватает и как вообще развиваться инженеру, который разрабатывает программные продукты в 2026 году со всей этой AI-истерией.

И в итоге я пришёл к тому, что решил создать roadmap развития AI-разработчика.

Собственно, представляю его вам. Можете почитать, обсудить со мной, обосрать, а можете сделать пулл-реквест в GitHub с дополнениями и улучшениям

Планирую перманентно его дополнять и улучшать. И очень надеюсь, что в какой-то момент он станет действительно полезным не только для меня, но и для сообщества.

Но уже сейчас, хотя бы я наконец примерно понимаю, где нахожусь, что уже умею и какие навыки мне ещё стоит осваивать.

Но если к этому подключится комьюнити, думаю, мы действительно сможем сделать что-то крутое.

Давайте обсуждать и развивать его вместе. Индустрия развивается бешенными темпами, а мы сейчас в той точке, что приходится нихуево так грести, чтобы не оказаться за бортом.

https://ai-for-geeks.github.io/roadmap/

AI Для Задротов. Подписаться.
  • 👍 7
  • 🔥 4
Post #31 628
1C БИТРИКС НА GoLang???

Я тут немного упоролся и, в свете всех этих дискуссий о том, как с помощью вайбкодинга переписывают известные проекты на другие языки, подумал: а что, если переписать 1С-Битрикс на Go?

Вот просто взять, всем чатом скинуться токенами и заебашить все это за неделю. При этом сохранить совместимый API.

Смотрите, что мы получаем. Мы просто ускоряем работу в сотни раз, блять, и можем продавать это как свое решение. Действуют ли тут законы об авторском праве? Я не знаю. Это же будет продукт написанный с нуля, получается мы ничего не воруем.

Можно будет продавать это под слоганом типа: «Ускорим ваш Битрикс в миллион раз». Это же просто охуенно.

В чате есть юристы? Я не знаю, какие минусы есть у этой идеи. Вот серьезно, где эта бизнес-модель может дать сбой?

Мне кажется, я придумал, как нам всем стать долларовыми миллиардерами.

На самом деле я стебусь, но по факту же мы можем это сделать) Если не для коммерческого использования то рофла ради

AI Для Задротов. Подписаться
  • 😁 16
  • 🤡 4
Older posts →

About this channel

How can I read @ai_for_geeks without a Telegram account?
TGViewer shows the public web preview Telegram publishes for AI Для Задротов: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does AI Для Задротов have?
AI Для Задротов (@ai_for_geeks) has 462 subscribers on Telegram, refreshed roughly every 30 minutes.
Does AI Для Задротов know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →