TGViewer
Channel Public Channel
Agents Lab

Agents Lab

@agents_lab

Обсуждаем AI агентов

Наш чатик https://t.me/openclaw_lab_community
Subscribers
1.01K
Photos
113
Videos
53
Links
268

Showing posts older than #136 · Back to latest

Older Posts 20 shown
Post #135 1.32K
supermemory 28к ⭐ - память и контекст для AI-агентов, теперь полностью локально

Запуск:
npx supermemory local
supermemory-server

На машине поднимается весь стек: graph engine, локальные embeddings, извлечение фактов, user profiles и Memory API. Модель выбираете сами: OpenAI, Anthropic, Gemini, Groq или офлайн через Ollama.

Хорошо ложится с Claude Code, Cursor, Codex, Hermes, LangChain, Vercel AI SDK. Агент может помнить проект, предпочтения, прошлые решения и доставать нужный контекст между сессиями.

Чат | CloseRouter
  • 👍 4
  • 🔥 3
  • ❤ 2
Post #134 944
Claude Fable 5 вернут в течении суток 🎉

Ужесточили гарды, классификатор для модели. Еще чаще будет фолбекать на Opus 4.8 на запрещенных темах.

Доступна по подписке до 7 июля и только до 50% лимитов можно потратить.


Hermes Agent работает с web до 60 раз быстрее и в 49 раз дешевле 🔱

Web_extract перестал прогонять каждую большую страницу через LLM-саммаризатор.

🔵Если страница до 15000 символов - возвращают целиком
🔵Если больше - берут head+tail окно примерно 75/25
🔵Полный текст сохраняют в cache/web/<slug>-<hash>.md
🔵В ответ добавляют footer с путем к файлу и подсказкой для read_file
🔵Inline base64-картинки заменяют на [IMAGE: alt], чтобы не забивать контекст

Главный инсайт из PR:
Мы платили LLM round-trip за сжатие markdown, который backend уже вернул чистым.

Ускорили не сам скрапинг, а post-processing после него. Убрали генерацию, чанкинг, синтез и ожидание auxiliary-модели. Сохранили доступ к полному тексту через файл, поэтому качество восстановления ответа осталось тем же.

Чат | CloseRouter
  • 👍 6
  • 👎 1
Post #133 931
Вышла Claude Sonnet 5 💬

Лучше предшественника, слабее опуса. Обновление рабочей лошадки.

Чат | CloseRouter
  • 👍 2
  • 👎 1
Post #132 872
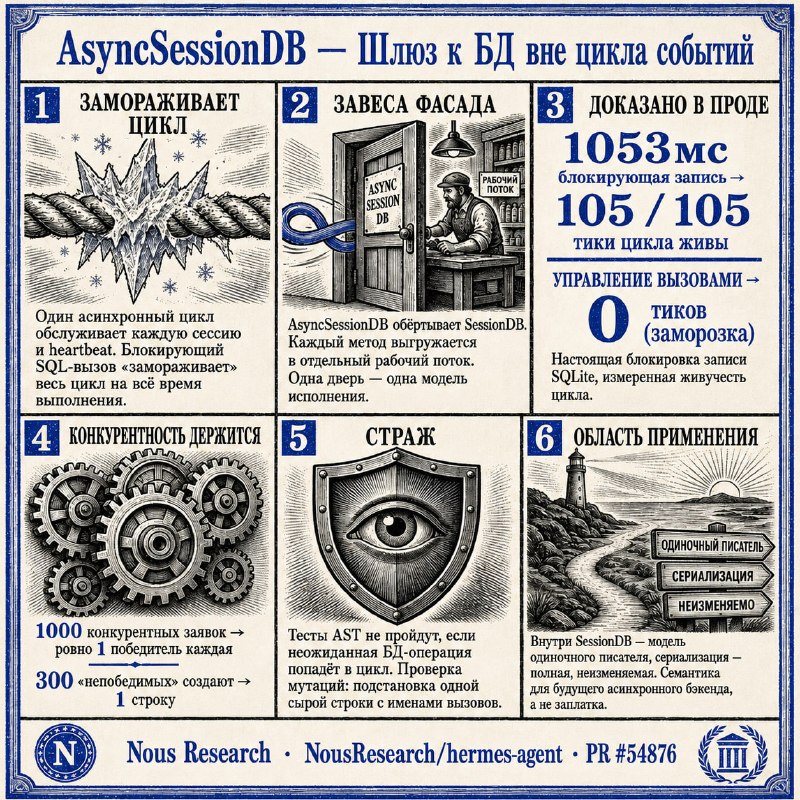
Hermes Agent получил апдейт для больших multi-agent запусков🔱

Главное - AsyncSessionDB: обращения к SQLite в gateway вынесли с event loop в рабочий поток.

Для нас это означает меньше зависаний, когда параллельно живут сессии, сигналы активности и Kanban-задачи.

Второй апдейт - /usage. Теперь в чате видно, куда уходит контекст: системный промпт, инструменты, правила, skills, MCP, subagents, memory и сам диалог.

чат
  • 🔥 6
Post #131 3.15K
Karpathy недавно дал хорошую рамку для агентной разработки: агентов уже мало просто запустить. Их нужно проектировать через спецификации, evals, ревью, безопасность, наблюдаемость и понятный путь до production.

В 📎статье показано, как Google Agents CLI пытается собрать это в один процесс: установка skills для coding agent, сборка RAG-агента, локальные проверки, eval suite, развертывание в Agent Runtime и публикация в Gemini Enterprise.

Если делаете внутренних ассистентов, RAG или агентов на ADK, это хороший пример того, как довести прототип до сервиса для команды.

чат
Telegraph Agentic Engineering с нормальными инструментами: Google Agents CLI на практике Karpathy назвал Agentic Engineering дисциплиной для работы с агентами в боевых системах. В ней разработчик отвечает за спецификацию, eval loops, ревью изменений, безопасность и качество результата. Проблема в том, что реальный цикл разработки агента обычно…
  • 👍 1
Post #130 1.03K
Deepsec 4к ⭐ - сканер уязвимостей (агент) от Vercel Labs

Он сначала быстро проходит репозиторий правилами на регулярных выражениях и отмечает подозрительные места. Потом агент для кода читает файлы, контекст проекта из INFO.md и решает, есть ли реальная уязвимость.

🔵 автоматически использует как фолбек claude/codex подписку, либо настраиваете Vercel AI API
🔵 работает по стадиям: scan → process → revalidate → enrich → export
🔵 хранит состояние в .deepsec/data, поэтому упавший запуск можно повторить, уже обработанные файлы он пропустит
🔵 для PR есть process --diff: проверяет только измененные файлы и готовит комментарий в Markdown
🔵 свои правила поиска можно писать под фреймворк, авторизацию, RPC или внутренний SDK

Старт:
npx deepsec init
cd .deepsec && pnpm install
pnpm deepsec scan
pnpm deepsec process
pnpm deepsec revalidate

Честно предупреждают про стоимость: полный прогон большой кодовой базы может стоить тысячи долларов. Нормальный вход - начать с --limit 50, заполнить короткий INFO.md, прогнать HIGH через revalidate, а потом добавить правила под свои реальные точки входа.

чат
  • 👍 3
Post #129 755
Компания из одного человека обычно ломается не из-за нехватки идей. Чаще - из-за памяти и повторяемости.

Когда решения, клиентский контекст, заметки и черновики живут в разных местах, владелец быстро становится главным хранилищем, исполнителем и напоминалкой для самого себя.

В статье разобран рабочий контур для соло-предпринимателя: Obsidian как память, Claude Code как обработчик знаний, Claude Cowork как исполнитель для файлов, Hermes Agent как фоновый оператор в Telegram с навыками и расписаниями.

📎 Компания из одного человека: рабочая система на Obsidian, Claude и Hermes

чат
Telegraph Компания из одного человека: рабочая система на Obsidian, Claude и Hermes Компанию из одного человека редко ломает нехватка идей. Чаще она ломается на памяти, производстве и повторяемости. В голове лежат решения, в заметках - куски исследований, в чатах - обещания клиентам, в файлах - черновики, которые никто больше не видит целиком.…
  • 👍 5
Post #128 1.04K
Два свежих репозитория про то, как LLM становятся лучше

slime (7к⭐) - фреймворк для дообучения моделей на реальных задачах. Если агент пишет код, вызывает инструменты или решает задачу в несколько шагов, slime помогает собирать такие попытки, оценивать результат и улучшать модель.

DeepSpec (1к⭐) - проект DeepSeek для ускорения ответов. Идея простая: маленькая модель быстро набрасывает продолжение, большая модель проверяет сразу несколько токенов, и генерация идет быстрее.

Отдельно разобрал, как работает обучение агентов на попытках и ошибках через ART (10.2к⭐), GRPO и RULER:
📎 Как дообучать LLM

чат
  • 👍 2
  • ❤ 1
Post #127 881
MoA в Hermes Agent - новый режим, где несколько моделей работают как один агент 🔱

Внутри есть модели-советники и главная модель.

Модели-советники читают задачу и дают приватные заметки: как подойти к решению, где могут быть ошибки, что стоит проверить. Пользователь их не видит, инструменты они не вызывают.

Главная модель получает эти заметки, собирает финальный ответ и уже сама работает как обычный Hermes: вызывает tools, продолжает /goal, пишет результат в чат.

На HermesBench связка Claude Opus 4.8 + GPT-5.5 дала результат выше, чем каждая модель отдельно: примерно +8% к Opus 4.8 и +11% к GPT-5.5.

Цена тоже растет: один шаг агента превращается в несколько вызовов моделей. Поэтому MoA больше подходит для сложных задач: архитектура, ревью, планирование, длинные исследования.

Начинается игра: кто лучше замиксует модели 💃

чат
  • 👍 5
  • ❤ 4
  • 🔥 1
Post #126 1.17K
Репозиторий loop-engineering - набор шаблонов для AI-агентов, которые работают по циклу

Агент запускается по расписанию, читает память проекта, делает задачу, проверяет результат отдельным агентом и записывает, что произошло.

В репозитории собраны шаблоны для таких сценариев: ежедневная проверка проекта, сопровождение изменений в коде, реакция на упавшие тесты, обновление зависимостей, журнал запусков и лимиты расходов.

И есть статья, которая разбирает эту идею на более рискованном примере - автоматической торговой системе. Там цикл выглядит так: собрать рыночные данные, найти торговый сигнал, проверить его на исторических данных, исполнить сделку и следить за риском.

📎 Loop engineering: как собрать самоулучшающуюся торговую систему

чат
  • ⚡ 1
  • ❤‍🔥 1
  • 👍 1
  • 🔥 1
Post #125 3.2K
Как AI-агенты учатся после каждого запуска 😘

Обычно все смотрят на модель и веса. Но в продуктах быстрее работают другие слои: harness, проверки, память, навыки и действия пользователей.

Самая сильная часть - агент может учиться на правках человека. Менеджер одобрил возврат, который агент завернул, причина попала в процедурную память, следующий похожий кейс обрабатывается умнее.

Разбор Karpathy AutoResearch, SEAL, AlphaEvolve, Hermes, OpenClaw, Anthropic Skills и AG-UI в одной статье:

📎 Как AI-агенты учатся на практике

чат
  • 👍 3
Post #124 712
OpenRouter MCP - живой каталог моделей для агентов

Подключаете его к Claude Code, Codex CLI, OpenCode или Cursor - и агент может сам спросить: какая модель сейчас лучше для кода, JSON extraction, длинных документов, дизайна, reranking, speech-to-text или дешевого прогона.

Что внутри:

🔵 models-list, model-get, model-endpoints - живой каталог моделей, цены, контекст, модальности, провайдеры, latency, throughput и data policy

🔵 benchmarks и rankings-daily - оценки из Artificial Analysis, Design Arena и тренды по использованию

🔵 chat-send - можно отправить тестовый запрос в несколько моделей и сравнить ответ, стоимость и провайдера

🔵 generation-get - показывает точную цену, токены и endpoint конкретного прогона

🔵 docs-search, credits-get, providers-list - поиск по документации, баланс и настройки маршрутизации

Подключение простое:
claude mcp add --transport http openrouter https://mcp.openrouter.ai/mcp
claude mcp login openrouter

или для Codex:
codex mcp add openrouter --url https://mcp.openrouter.ai/mcp
codex mcp login openrouter


Авторизация идет через OAuth. OpenRouter создает отдельный ключ только для MCP, по умолчанию на 7 дней и с лимитом $10. Почти все инструменты только читают данные. Платным становится chat-send, потому что он реально вызывает модели.

чат
  • ❤ 3
Post #123 764
Кому нужен светофор для Claude Code?

чат
  • 🔥 8
  • 😁 6
  • ❤ 3
  • ❤‍🔥 1
Post #122 908
Hermes Agent получил команду /learn, которая превращает документы, репозитории и рабочие процессы в навыки.

Hermes сам собирает контекст, пишет файл SKILL.md по стандарту и сохраняет его для будущих задач.

Документация /learn

Чтобы команда появилась, обновитесь через /update и выполните /restart. У меня он почему-то решил не перезагружаться в этот раз 👍

чат
  • 👍 7
Post #121 1.07K
Вышла новая японская модель Sakana Fugu (arxiv), навела шуму знатно, в X - 25 млн просмотров

Самая интересная часть - оркестрация 🔄

Снаружи это один API: вызываешь fugu или fugu-ultra, как обычную модель. Внутри Fugu решает, кого из агентного пула подключить, кому отдать подзадачу, где нужна проверка, а где достаточно одного сильного worker-а.

Полный пул моделей Sakana не раскрывает. В отчете фигурируют GPT-5.5, Claude Opus 4.8 и Gemini 3.1 Pro, но точные версии, правила маршрутизации и внутренние промпты закрыты.

У обычного Fugu логика ближе к умному роутингу: выбрать подходящую модель под шаг задачи.
У Fugu Ultra - полноценный workflow: несколько агентов, роли, промежуточные ответы, проверка, синтез.

Типичный паттерн из отчета: GPT строит решение, Opus приходит на этап дебага и находит уязвимости, после чего результат дорабатывается. В других задачах Fugu может устраивать дебаты, вызывать специалиста по теме или даже рекурсивно подключать Fugu как еще одного участника команды.

Установщик для Codex:
curl -fsSL https://sakana.ai/fugu/install | bash
потом:
codex-fugu

Цены на api:
fugu - вы платите только по стандартной ставке для конкретной базовой модели.
fugu-ultra - 5$ Input, 30$ Output, 0.5$ Cache.
Если контекст больше 272К, то 10$ Input, 45$ Output, 1$ Cache.

И есть подписка 20/100/200$. До конца июля получаете второй месяц бесплатно.

Теперь можно иметь свою фронтир модель, не имея модели 💃

чат
  • ❤ 2
  • 👍 2
Post #120 2.97K
Looper (188 ⭐️) - скилл, который помогает спроектировать loop до запуска.

Если плохо описать /goal или /loop, агент быстро сожжет токены и будет уверенно крутиться вокруг плохой задачи. Looper добавляет шаг - сначала собирает нормальный цикл, потом отдает его Claude Code или другому агенту.

Вы запускаете /looper, а он интервьюирует вас по ключевым частям:
🔵 цель и контекст
🔵 что считается готовым результатом
🔵 проверки: команда, модель-судья или человек
🔵 отдельный reviewer/судья, например Claude проверяет работу Codex
🔵 лимиты по итерациям, времени, токенам и “нет прогресса”
🔵 файлы состояния: state.json, run-log.md, loop.yaml, RUN_IN_SESSION.md

Loop становится видимым артефактом. Его можно прочитать, поправить, переиспользовать, закоммитить и только потом запускать.

чат
  • 🔥 3
Post #119 1.02K
Если пользуетесь Codex CLI - проверьте ~/.codex

В Codex нашли неприятный баг с локальными логами: CLI слишком подробно писал TRACE/WebSocket/telemetry события в SQLite:
~/.codex/logs_2.sqlite
~/.codex/logs_2.sqlite-wal
~/.codex/logs_2.sqlite-shm


В issue #28224 один сетап экстраполировали до ~640 TB записей в год на SSD. Размер файла при этом может не выглядеть страшно: WAL крутится и перезаписывается, а износ диска всё равно происходит.

Если файлы уже разрослись, закройте Codex и удалите их:
rm -f ~/.codex/logs_2.sqlite*


Фикс уже вошёл в обновление 0.142.0

чат
  • 😱 2
Post #118 1.02K
🔱Hermes Agent раскрывается постепенно. Сначала это просто запросы в Telegram или терминале: найти, сравнить, поправить файл, запустить команду. Дальше появляется память, SOUL.md, skills, MCP, sub-agents, cron jobs, профили и отдельные рабочие агенты под разные задачи.

📎15 уровней Hermes Agent. Тут хорошо видно, на каком этапе вы сейчас и какой следующий шаг даст больше всего пользы.

Самый интересный момент начинается после cron jobs. Если агент каждый день приносит результат, он должен учиться на обратной связи.

Для этого есть 📎Hermes Sensei Loop: агент собирает замечания, проверяет новый prompt на holdout-наборе и продвигает изменения только если качество реально выросло.

Сначала доведите Hermes до уровня, где он стабильно делает работу без ручного вмешательства. Потом добавляйте лупы, чтобы они улучшали workflow, а не просто запускал старые задачи по расписанию.

чат
  • 👍 8
  • 🔥 3
Post #117 1.19K
Продолжаем изучать тему лупов ✍️

🔵AI loops: что это такое и где они реально работают

База: что такое loop, зачем нужны проверка, состояние и лимиты, где это помогает, а где просто сжигает токены.

Подойдет тем, кто пока использует ИИ через одиночные запросы и хочет понять следующий уровень.

🔵Loop engineering: как заставить агента кодить ночью и не сжечь бюджет

Практика для разработки: STATUS.md, skills, worktrees, MCP, субагенты, бюджетные стопы и утренний отчет вместо стены логов.

Подойдет разработчикам и тимлидам, которые хотят запускать кодинг агентов в репозитории безопаснее.

🔵Один loop, 259 PR в месяц: практическая схема loop engineering

Схема полноценного loop: 6 частей, первые задачи, ограничители, типичные сбои и дешевые альтернативы.

Начинайте с маленького повторяемого процесса, где есть автоматическая проверка, лимит шагов и понятный результат.

чат
  • 👍 3
Post #116 1.22K
Graphify (70к ⭐) - карта проекта для AI-агентов

Агентам постоянно приходится заново читать файлы, искать по репозиторию и тратить контекст на куски кода. Graphify решает это через граф знаний: один раз строит карту проекта, а потом агент спрашивает ее вместо бесконечного grep и чтения файлов.

После запуска /graphify . появляются три артефакта:
- graph.html интерактивная карта в браузере
- GRAPH_REPORT.md понятный отчет с главными узлами, связями и вопросами
- graph.json граф, который агент может спрашивать через CLI или MCP

Что интересно внутри:
🔵 код парсится локально через tree-sitter: классы, функции, импорты, вызовы, SQL-схемы и связи
🔵 docs, PDF, изображения, видео и Google Workspace можно добавлять в тот же граф
🔵 есть MCP-сервер с инструментами query_graph, get_node, shortest_path, list_prs, get_pr_impact
🔵 поддерживаются Claude Code, Codex, OpenCode, Cursor, Kilo Code, Hermes, OpenClaw, Gemini CLI, Devin CLI и другие агенты
🔵 можно поставить hooks, чтобы после коммитов граф обновлялся сам

Установка:
uv tool install graphifyy
graphify install
/graphify .

Для команд это особенно кдобно: graphify-out/ можно коммитить в репозиторий, и новые агентные сессии сразу получают готовую память проекта. Агент видит, где авторизация, где база, какие модули связаны, какие PR задевают те же части системы и где может быть конфликт.

Бонусом статья - 📎 Второй мозг в Claude на Obsidian: практический гайд

ЧАТ
  • ❤ 3
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →