TGViewer
Channel Public Channel
Жёлтый AI

Жёлтый AI

@zheltyi_ai

Подпольный филиал https://t.me/kod_zheltyi
AI/ML-related news by T-Bank AI teams

Чат: https://t.me/zheltyi_aimeetup
Subscribers
9.34K
Photos
292
Videos
20
Links
258
Recent Posts 12 shown
Post #492 1.62K
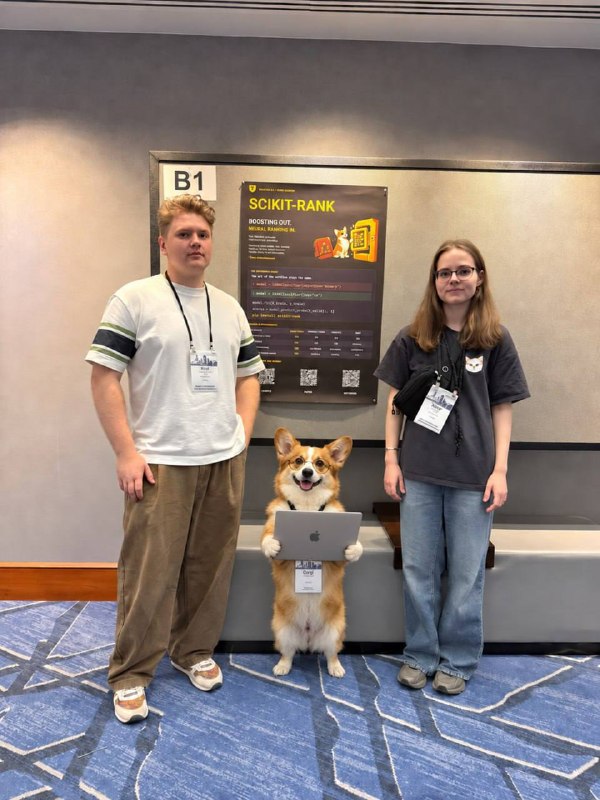
Съездили в Миннеаполис на ACM RecSys 2026 и представили сразу три работы про рекомендательные системы: Scikit-Rank, ScaL³AE и Perseus

Сейчас нейросетевое ранжирование все чаще используют там, где раньше полагались на бустинги, но все делают это очень разными способами. Нам захотелось собрать лучшие практики в одной библиотеке, которую можно легко встроить в существующие пайплайны за счет совместимости со scikit-learn. Так появился Scikit-Rank: он позволяет буквально заменой пары строк попробовать нейроранжирование и поэкспериментировать с лоссами, бэкбонами и энкодерами — все это настраивается через конфиг и даже работает в multi-GPU-режиме.

ScaL³AE разработали, взяв за основу L³AE — линейный автоэнкодер, который объединяет историю взаимодействий пользователей с семантикой объектов из LLM. Это эффективно для айтемов, по которым мало данных, но плохо масштабируется на большие каталоги. В ScaL³AE мы заменили эти вычисления компактными и разреженными представлениями, сохранив near-closed-form решение. В результате получили модель, которая без проблем скейлится на промышленные каталоги и является сильным бейзлайном даже за пределами своего класса.

А про фреймворк Perseus, который собирает разные действия пользователя в одну последовательность и позволяет обучать модели на общей истории, мы уже рассказывали.

Больше о впечатлениях о конференции и трендах в recsys можно прочитать здесь.

• Коды Perseus, Scikit-Rank и ScaL³AE уже есть в открытом доступе
  • ❤ 19
  • ⚡ 10
  • 😁 7
  • 👍 3
  • 🔥 2
  • 🥴 1
Post #491 2.12K
🧩 Обсудили AI-агентов

Наш спикер Даниил Гаврилов стал гостем нового выпуска шоу «ПродАктовая корзина», посвященного развитию AI-агентов.

Вместе с комиком Севой Левкачевым и коллегами из других бигтехов они обсудили самые громкие технологические новости, обменялись мнениями и поспорили на острые темы.

• Смотреть на YouTube
  • ❤ 24
  • 👍 16
  • 🥴 15
  • 🔥 10
  • ⚡ 8
  • 🤩 3
Post #490 3.77K
✍️Туториал по Perseus

Летом уже рассказывали тут про фреймворк Perseus. Сейчас же подготовили подробный туториал про то, как использовать фреймворк для решения различных задач, связанных с персонализацией. В туториале рассматриваются кандидатогенерация, ранжирование, классификация и регрессия — как конфигурировать модель с помощью YAML-файлов, добавлять события и признаки из различных доменов, настраивать архитектуру и запускать обучение и инференс под каждую из задач.

• Статью можно почитать тут, фреймворк найти здесь
  • 👍 18
  • ❤ 16
  • ⚡ 8
  • 🔥 1
Post #489 5.13K
19 сентября наши спикеры выступят на Practical ML Conf 😎

— В 14:50 Даниил Гаврилов поучаствует в дискуссии о том, как исследования превращаются в продукты, почему иногда продукт появляется раньше статьи и какие результаты компании предпочитают вообще не публиковать.

— В 15:30 Даниил Цимерман обсудит, где AI-агенты уже приносят измеримую пользу, а где пока остаются красивыми демками.

— В 17:50 в зале «Код» Александр Мисевич расскажет, как мы строим инфраструктуру для массового инференса LLM внутри корпоративного контура. Будет про единый пайплайн подготовки, бенчмаркинга, оптимизации и деплоя моделей — и про то, как за последние полгода нам удалось снизить стоимость инференса в несколько раз.

Подробности и регистрация — на сайте.
  • 🔥 19
  • 👍 18
  • 🤣 9
  • ❤ 5
  • ⚡ 5
  • ❤‍🔥 1
  • 🤩 1
  • 👌 1
Post #488 6.68K
⚡️Делимся двумя релизами, о которых рассказывали на Turbo ML Conf

T-Search — открытый агент-ретривер для сложного многошагового поиска. Это специализированная модель на основе Qwen3-35B-A3B. Она не генерирует ответ, а за несколько шагов находит нужные фрагменты в документах. Попробовать модель в деле можно на Hugging Face, а почитать, как мы обучали агента многошаговому поиску — в статье на Хабре.

Perseus — открытый фреймворк для универсальной персонализации на основе гетерогенных событий. Он объединяет все действия пользователя из разных сервисов в единую последовательность и позволяет масштабировать ML-персонализацию на новые продукты — даже если у пользователя там еще нет никакой истории. В разных задачах сразу получили +3–17% к бизнес-метрикам. Почитать,  как можно использовать фреймворк, предлагаем на Хабре, а сам фреймворк — на GitHub.
  • 🔥 34
  • 👍 15
  • ⚡ 13
  • ❤‍🔥 2
  • ❤ 1
Post #486 6.26K
✨ Пока ждем Turbo ML Conf предлагаем поиграть в мини-игру @LossMonkeyBot

Всем же приятно смотреть как лосс падает? Пока fable делает вашу работу, можно вкатиться в макакинг 🦍

3 человека, которые попадут в начало лидерборда, заберут лего-банкоматы Т-Банк.

Победителей объявим в комментариях 17 июля - за день до конференции!
  • 🔥 14
  • 🥴 11
  • ❤ 5
  • ⚡ 2
  • 👌 1
Post #485 6.22K
Владивосток, мы знаем, чем вы займетесь 27 июня 👀

Встречаемся на T-Meetup: R&D! Нас ждут доклады, полезные знакомства и общение с топами индустрии.

В программе 3 доклада:

→ «Почему существуют задачи, которые нельзя решить обычной разработкой?» — Станислав Моисеев
Поговорим, где проходит граница между разработкой и R&D, почему некоторые технологические вызовы невозможно решить стандартными инженерными подходами и зачем компании инвестируют в проекты с высокой неопределенностью.


→ «Code Knowledge Graphs как память для LLM» — Михаил Бадерик

Разберем, что такое графы знаний и как они помогают превратить кодовую базу в структурированную память для ИИ-ассистентов. Обещаем много практики!


→ «Эволюционные агенты на практике: open-source и реальные задачи» — Матиенко Данил
Узнаем, как устроены AlphaEvolve и его open-source-аналоги, сравним подходы и покажем реальные кейсы. Расскажем, как мы оптимизировали выезды торговых представителей в Т-Географии.


Приходите, чтобы задать вопросы топ-менеджеру и разработчикам R&D-центра, обменяться опытом и пообщаться с коллегами в неформальной обстановке.

🗓️27 июня, 17:30 по местному времени
📍Владивосток, Корабельная набережная, 10

Не забудьте зарегистрироваться — количество мест ограничено!
  • 👍 12
  • 🔥 9
  • 🏆 4
Post #484 5.54K
Получили ранний доступ к секретной модели Mistral: Le Gros Chaton — 30 трлн параметров, 256 тысяч экспертов. Подняли инференс на всём кластере, неделя прогрева — пока что сгенерировали только 10 токенов. Но это лучшие 10 токенов в нашей жизни.

Правда, они пока только на французском. Так что начинаем обучение «Большой ко-Т».
  • 🥰 48
  • 🤣 36
  • 🥴 14
  • 🤯 4
  • 👍 1
  • 👌 1
  • 🏆 1
Post #483 7.46K
⚡️ Открываем регистрацию на Turbo ML Conf 2026!

Соберемся, чтобы обсудить глубокие исследования, прикладной ML и инженерные системы.

В программе три трека.

✨ Fundamental Advances & Exploratory R&D
Поговорим об архитектуре и обучении современных моделей, их интерпретируемости, безопасном поведении и способности к рассуждению и самокоррекции.


✨ Applied ML at Scale & Business Impact
Рассмотрим внедрение ML в продукты: интеграцию классических и GenAI-моделей, обеспечение их предсказуемости, влияние AI на пользовательский опыт и бизнес-метрики.


✨ ML Infrastructure, Platforms & Engineering Core
Разберем технологическое ядро ML-систем: архитектуры, пайплайны данных и масштабного обучения, методы дообучения, низкоуровневую оптимизацию инференса и инфраструктуру.


А еще вас ждут секретные доклады, о которых расскажем в день конференции, и демозоны, где можно будет познакомиться с платформами и продуктами на базе ML-технологий и пообщаться с командами, которые их создают.

📚18 июля
↗️️ Москва, ДК «Серп и молот»

Регистрируйтесь и приглашайте коллег — количество мест ограничено!
  • 🔥 16
  • ❤ 15
  • ⚡ 5
  • 😁 2
Post #478 6.3K
Съездили в 🔤🔤🔤🔤🔤🔤 на AAMAS 2026, где у нас был oral с работой Enhancing Vision-Language Model Training with Reinforcement Learning in Synthetic Worlds for Real-World Success.

В статье мы обучаем VLM-агентов через RL в дешевых синтетических средах: MiniWorld, Gym-Cards, ALFWorld и WebShop. Основная идея — если хотим, чтобы модель не просто красиво описывала картинку, а умела смотреть на состояние мира и делать последовательность действий, то ей нужно дать возможность потренироваться в интерактивных окружениях.

Для этого предложили VL-DAC: простой RL-метод, где PPO применяется к action-токенам, а value учится один раз на шаг среды. В итоге убираем хрупкие коэффициенты между thought/action токенами, replay buffers и прочие места, где обычно хочется немного поплакать во время обучения VLM через RL.

После обучения в одном дешевом симуляторе модель переносит навыки на реальные бенчмарки: +50% relative на BALROG, +5% на самой сложной части VSI-Bench и +2% на VisualWebBench, при этом не ломая обычное понимание изображений.

• Статью можно прочитать тут, а код найти здесь 😉
  • ❤ 27
  • 🔥 22
  • ⚡ 12
  • 😁 3
  • 🥴 3
  • 🤣 3
Post #477 6.36K
⚡️ Turbo ML Conf возвращается!

Бронируем ваше 18 июля, чтобы обсудить тренды, кейсы и технологии в ML.

В этом году помимо докладов у нас будут представлены демозоны с разными ML-решениями. Вы сможете представить продукт или платформу вашей компании, основанную на ML-технологиях.

Если вам есть что показать — оставляйте заявку на сайте. Мы особенно заинтересованы в опыте использования CV, RecSys и NLP. Всем участникам предоставим место с экраном для команды до трех человек.

А какие будут треки с докладами?
↗️ Fundamental Advances & Exploratory R&D
Про архитектуру и обучение современных моделей, их интерпретируемость, безопасное поведение и способность к рассуждению и самокоррекции.

↗️ Applied ML at Scale & Business Impact
Про внедрение ML в продукты: интеграцию классических и GenAI-моделей, обеспечение их предсказуемости, влияние AI на пользовательский опыт и бизнес-метрики.

↗️ ML Infrastructure, Platforms & Engineering Core
Про технологическое ядро ML-систем: архитектуры, пайплайны данных и масштабного обучения, методы дообучения, низкоуровневую оптимизацию инференса и инфраструктуру.

Следите за апдейтами конференции в этом канале и на сайте.
  • 👍 14
  • ⚡ 12
  • ❤ 5
  • ❤‍🔥 4
  • 🐳 1
Older posts →

About this channel

How can I read @zheltyi_ai without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Жёлтый AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Жёлтый AI have?
Жёлтый AI (@zheltyi_ai) has 9.34K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Жёлтый AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →