TGViewer
Zen of Python Zen of Python @zen_of_python · 18.9K subscribers
Post #4969 1.26K
Как выбрать быстрый способ читать Excel из Python без сюрпризов с типами

Когда в Python нужно разобрать большой XLSX, привычный Pandas оказывается лишь одной из шести опций. Сравнивать их только по секундомеру мало: ещё важны сохранность типов и корректность значений.

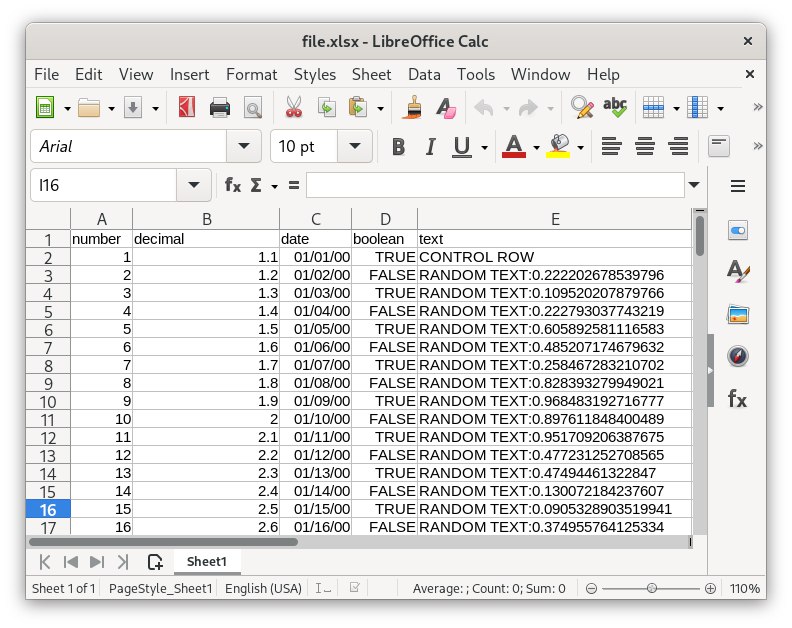
Питоничность здесь начинается с контракта: каждая реализация возвращает Iterator[dict[str, object]], поэтому потребитель может обрабатывать строки по одной. Для теста взяли файл на 25 МБ с 500 тысячами строк, а время измеряли полным проходом без обработки данных.

В сравнении Haki Benita остались итоговые замеры для Pandas, Tablib, Openpyxl, LibreOffice, DuckDB и Calamine, а также разбор типов и корректности. Полезный ориентир перед тем, как ставить очередную зависимость ради одной таблицы.
More from @zen_of_python
  1. Sep 20, 2026Как collections.deque хранит элементы блоками У deque два конца, поэтому легко представить…
  2. Sep 20, 2026Что ускоряет django-msgspec в Django и где он расходится с json django-msgspec заменяет ко…
  3. Sep 20, 2026Почему миллион чисел в Python занимает 35 МБ Список из миллиона целых, которые помещаются…
  4. Sep 19, 2026Как перевести Python-сервер MCP с FastMCP на SDK 2.x Свежая установка зависимостей сломала…
  5. Sep 19, 2026Как кэшировать методы чужого Python-клиента Если библиотечный клиент нельзя менять, его ме…
  6. Sep 19, 2026Где заканчивается ускорение NumPy и что выбрать дальше Векторизация выполняет цикл низкоур…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →