RecSys Summer School, день первый.На этой неделе перед основной конференцией ACM RecSys проходит летняя RecSys школа в Вене, большую часть которой составляют лекции различных профессоров / ресерчеров.
Для меня это возможность научиться чему-то новому, набрать побольше материала для собственного курса по рексису, понетворкаться, а также потусить целую неделю в Вене :)
Что интересного было в первый день:
1. Dietmar Jannach, один из самых цитируемых ученых в RecSys, выступил с вводной лекцией про рекомендательные системы: про их ценность, алгоритмы, оценку качества. С такой лекцией он выступает уже не первый раз, презентации прошлых лет есть в
открытом доступе.Приводил много разных фактов про пользу рексистем. Например, (1) 35% выручки Амазона атрибуцируется рексистемам, (2) а в Нетфликсе говорят, что с помощью персонализации и рексистем “экономят” больше миллиарда долларов в год.
Интересно было послушать и про историческое развитие области:
* в 1992 году в статье
Using collaborative filtering to weave an information tapestry впервые был упомянут термин “Collaborative Filtering”
* в 1994 появился первый кейс индустриальной рексистемы (GroupLens, рекомендация новостей), статья
GroupLens: an open architecture for collaborative filtering of netnews* в 2003 Амазон опубликовал статью про
Item-to-Item Collaborative Filtering* потом состоялся небезызвестный Netflix prize (2006 — 2009), в рамках которого Нетфликс выложил самый большой на тот момент рекомендательный датасет с пользовательскими рейтингами фильмов. Про это есть хороший рассказ от CPO Нетфликса на рексисе в 2014 году (
тык)
* позже от задачи предсказания рейтингов перешли к learning-to-rank парадигме, стали использовать implicit feedback (время просмотра, клики и тд). Активно использовали матричную факторизацию
* сейчас царит deep learning, про использование которого в рексистемах ваш покорный слуга аж четыре лекции в ШАДе в прошлом учебном году читал, и в этом планирует прочитать еще больше :)
Ссылался на большое количество хороших статей (ссылки можно найти в презентации). Жаловался, что ресерчеры тюнят гиперпараметры только для своих моделей, а для бейзлайнов не тюнят. Что нечестно фиксировать одинаковую небольшую размерность выходных эмбеддингов для обычной матричной факторизации (с обучаемыми векторами пользователей и айтемов) и нейросетей, так как у матричной факторизации становится сильно меньше параметров при уменьшении размерности эмбеддингов.
Упоминал beyond accuracy метрики (статья
Beyond accuracy: evaluating recommender systems by coverage and serendipity).
Fun fact: в какой-то момент Dietmar занимался рексистемой для премиальных кубинских сигар =)
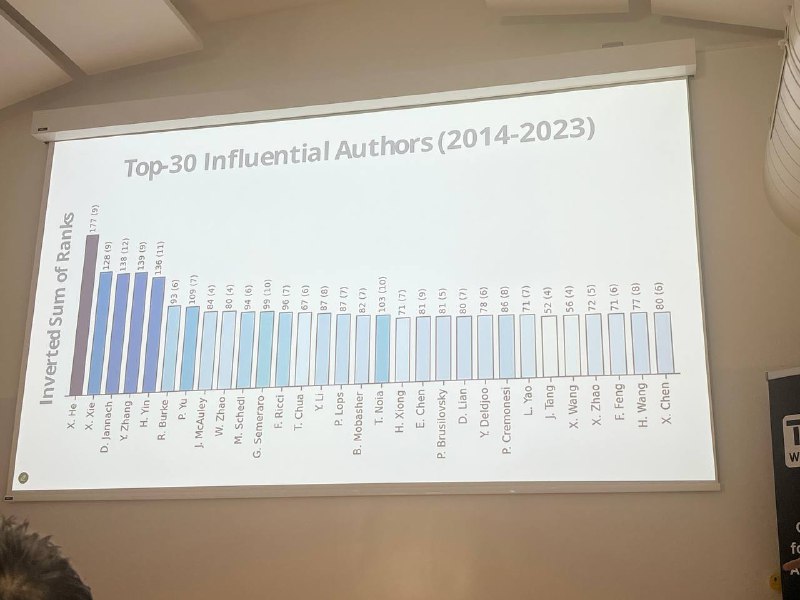
2. Barry Smyth (h-index 85!) выступил с рассказом по мотивам статьи
People Who Liked This Also Liked ... A Publication Analysis of Three Decades of Recommender Systems Research, в которой приводится аналитика по всем RecSys публикациям за ближайшие 30 лет. Также он немного дополнил рассказ про историю рексистем, показал статью аж 1990 года от Jussi Karlgren под названием
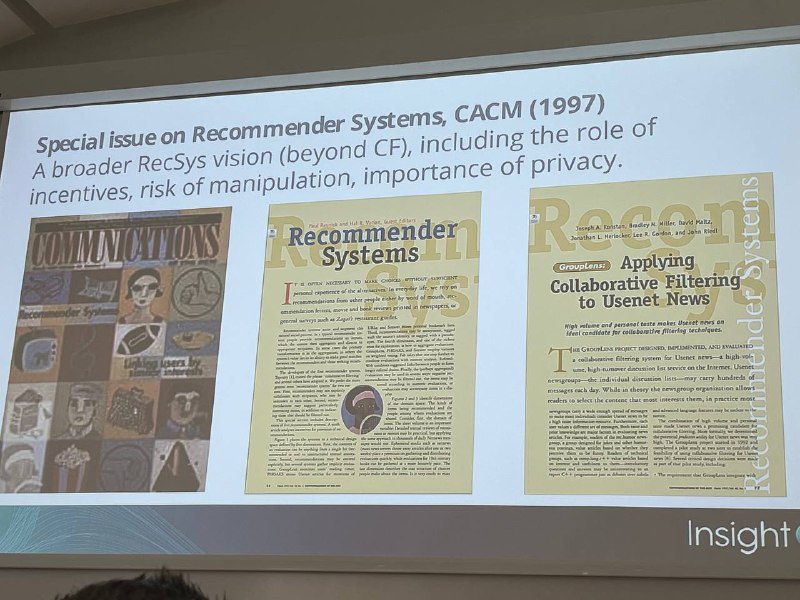
An Algebra for Recommendations, в которой уже говорится про моделирование пользовательского поведения и предсказание будущего пользователей. Еще показал очень красивое издание Communications of the ACM 1997-го года, special issue on recommender systems (картинку прикладываю).
Получилось, что за последние 30 лет появилось порядка 50к статей про рекомендательные системы.
А сегодня, во второй день школы, были лекции по психологии, графовым нейронным сетям, а также про оффлайн оценку качества рексистем. Но про это расскажу чуть позже :)