
Как и обещал ранее, сегодня расскажу про интересную штуку, о которой, вы вероятно не знали.
Как известно, основным способом улучшения нейронных сетей является два основных метода: дообучение уже существующей модели (обучение архитектуры с инициированными ненулевыми весами, полученными ранее) или Transfer Learning (ярким примером является дообучение BERT'ов, где мы обучаем поверх уже существующего эмбеддера полносвязный слой 'голову' на нужный нам таргет). И в целом, я тут вам Америку не открыл.
-Но знали ли вы, что аналогичные финты ушами можно проводить с моделями градиентного бустинга?
Если нет, то давайте расскажу.
Прежде всего я хотел бы ответить на вопрос "а зачем такое надо? ". Нередко, особенно в рисках, например в моделях скоринга, модели имеют схожий домен и таргет, но при этом обучаются и значит используются на разных бизнес сегментах. Если в более крупном сегменте по выручке мы имеем недостаток данных или целевых наблюдений (мало компаний, низкий Default Rate), то тогда мы можем взять наработки более мелкого сегмента и переиспользовать на более крупный, путем дообучения.
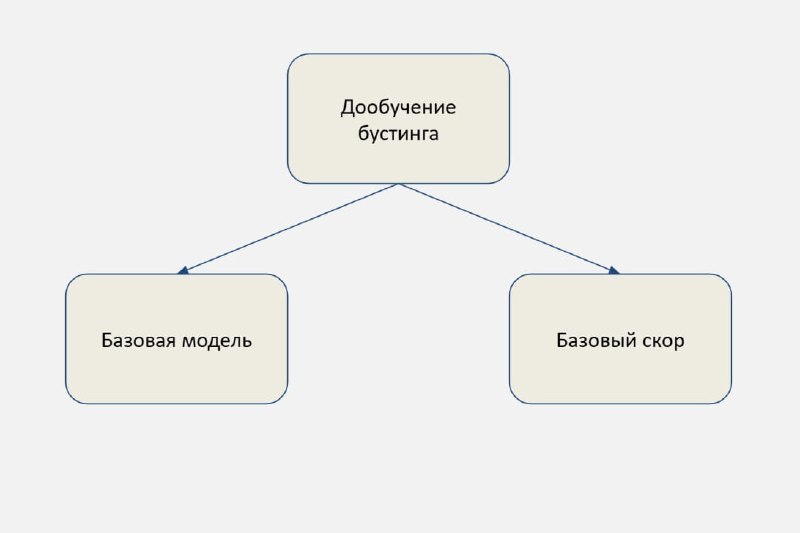
Глобально, метода дообучения два: у вас имеется базовая модель и имеется базовый скор. Оба имеют свои плюсы и свои минусы. Давайте поподробнее поговорим о них.
🔸🔠🔠🔠🔠🔠🔠🔠 🔠🔠🔠🔠🔠🔠
Это сценарий, когда ранее была использована модель градиентного бустинга и теперь мы можем дообучить ее, технически добавляя деревьев в уже существующий бустинг.
🔠🔠🔠🔠🔠⬇️
➕Простота вывода. Результат - единая модель бустинга, не требующая дополнительных вызовов базовой модели.
➕Экономия вычислительной мощности. Ваша базовая модель уже с какой-то точностью умеет предсказывать целевую метку, вам не нужно строить модель с нуля.
🔠🔠🔠🔠🔠🔠⬇️
〰️ Ограничение выбираемой реализации. Дообучая XGBoost, вы получите бустинг, написанный на XGBoost. Другого не дано.
〰️Ограничение базовых параметров. Большинство параметров дерева в бустинге, наследуются от базовой модели.
Интересный факт: В Catboost можно изменять learning_rate, но при этом большинство параметров, включая способ кодирования категориальных признаков, наследуется от базовой модели.
🔠🔠🔠🔠🔠🔠🔠⬇️
🔸XGBoost:
xgb.train(data=data, xgb_model=old_model)
🔸LightGBM:
lgb.train(train_set=train_new, init_model=old_model)
🔸Catboost:
model.fit(X_new, y_new, init_model=old_model)
🔸🔠🔠🔠🔠🔠🔠🔠 🔠🔠🔠🔠
Это сценарий, когда вместо базовой модели мы получаем на вход предсказания уже готовой модели и строим уже на них модель бустинга, уточняющую предсказание старой модели.
Важно: Предсказания в случае бинарной классификации должны подаваться не в формате предсказаний вероятности, а именно логитов, т.е предсказания до сигмоидального преобразования!
🔠🔠🔠🔠🔠⬇️
➕Свобода выбора базовой модели. В данной конфигурации мы воспринимаем базовую модель в формате black box, то есть нам не важна ее архитектура.
🔠🔠🔠🔠🔠🔠⬇️
〰️ Сложность вывода. Базовый скор необходимо откалибровать на выборке дообучения, т.е построить простейшую линейную модель. Также нам необходимо в продовом инференсе использование инференса базовой модели, то нам необходимо реализовать где-то рядом с дообученной моделью вызов базовой модели.
〰️Итоговая модель - не финальная. Основной сложностью данного подхода является то, что дообученная модель дает лишь смещение и для получения итоговой вероятности модели нам нужно смешать скоры базовой и дообученной модели и после этого прогнать через сигмоидальное преобразование.
🔠🔠🔠🔠🔠🔠🔠⬇️
🔸XGBoost:
xgb.train(data=data, base_margin=init_logits)
🔸LightGBM:
lgb.train(train_set=train_new, init_score=init_score)
🔸Catboost:
model.fit(X_new, y_new, baseline=init_logits)
На этом все, подробнее познакомится с данными техниками призываю самостоятельно, ставь 🔥, если понравилось!
#ds_лайфхаки