#полезное
❤️🔥 LMCache: умное кэширования для LLM-инференса.
LMCache - проект, который предлагает решение по сохранению KV-кэша на CPU, диске или даже в специализированной памяти NIXL. По сути, это инструмент, который превращает одноразовые вычисления в многократно используемые блоки, экономя время и ресурсы.
Представьте, что в чат-боте пользователи часто ссылаются на один и тот же системный промпт или историю диалога. Обычно модель заново обрабатывает эти данные, но LMCache просто загружает готовый кэш. Выгрузка KV-кэшей освобождает GPU для новых задач, уменьшая TTFT (время до первого токена) вплоть до 10 раз.
🟠LMCache гибкий.
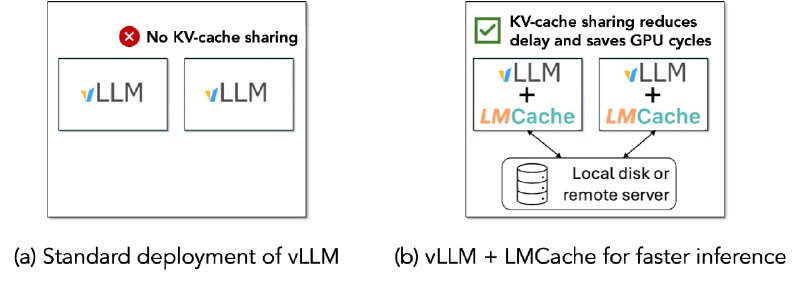
Кэши можно не только выгружать, но и делиться между разными инстансами LLM. Проще говоря, если два пользователя одновременно обращаются к разным копиям модели с одинаковым запросом, система не будет дублировать работу: результаты одного prefill’а станут доступны всем. Это работает даже для неполных префиксов, например, при частичном совпадении входных данных.
🟠LMCache умеет в раздельную предобработку.
Prefill и decode, которые обычно выполняются на одном GPU, теперь могут быть разнесены: первый этап обрабатывается на мощных узлах, а второй на оптимизированных для генерации. Для распределенных систем такая техника повысит пропускную способность.
Тесты разработчиков проекта показывают, что в реальных задачах задержка снижается в 3–10 раз, а GPU-циклы экономятся на повторных вычислениях.
Проект тесно интегрируется с vLLM, в репозитории есть большой набор с примерами, документация и советы по установке и настройке.
Калькулятор KV-кеша с выбором модели, ее типа данных и количества токенов, который поможет прикинуть, сколько VRAM можно сэкономить.
Гитхаб
👉Новости 👉База вопросов
Post #323
86