TGViewer
Channel Public Channel
Work & Beer Balance

Work & Beer Balance

@workbeer

Авторский канал @Akiyamka
Поддержать автора можно здесь:
buymeacoffee.com/cherrytea
Subscribers
1.55K
Photos
208
Videos
16
Links
286
Recent Posts 16 shown
Post #651 270
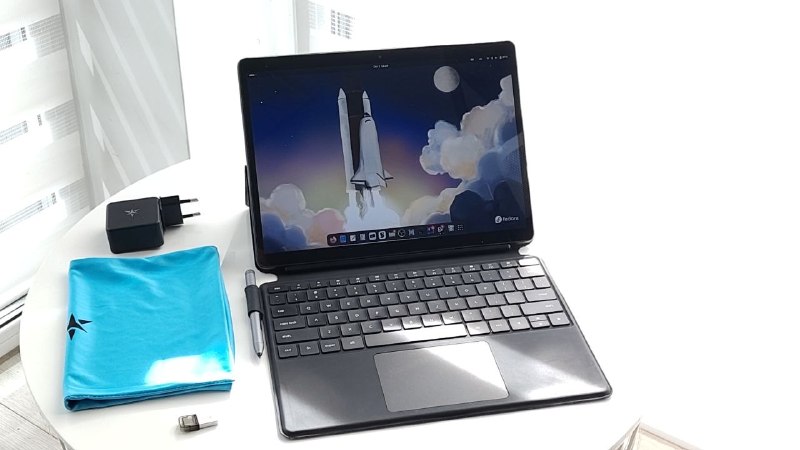
Ищу нового хозяина для своего Starlabs Starlight 12.5" Linux планшета (хочу поменять его на Framework 12).
Состояние идеальное, ни скола ни царапинки, в комплекте:
- тканевый чехол
- чехол-клавиатура с тачпадом
- активный стилус
- 2m type-c кабель (USB 5.0)
- брендированная usb-a / usb-c флешка
- 65W type-c блок питания.

Кроме того что-он linux-first есть еще пару особенностей отличающих его от других планшетов:
- это планшет на x86 (Intel N150) а не arm.
- этот планшет разборный и есть офф гайд как это делать, если например вы вдруг захотите поменять акб или заменить память планкой побольше
- кроме сменяемой 512GB на борту у него есть слот для micro-sd
- аж целых два type-c порта, micro-hdmi и jack 3.5
- хороший яркий сенсорный 2k экран (2880x1920)
- 16GB RAM

Новый он стоит 1,409$ (правда это уже перевыпуск на чуть лучшем N350, с чуть худшим экраном 2160x1440), я его отдам за 750$
  • 🔥 3
Post #646 303
👨‍💻 Фронтенд с AI: что можно делегировать агентам

5 октября, стартует конференция Podlodka Frontend Crew — сезон о том, как применять AI во фронтенд-разработке на практике.

Участники конференции узнают:


• Как находить prompt injection и противостоять таким атакам;
• Какие подходы помогают повысить доверие к результатам агентской разработки;
• Как проводить ревью кода, созданного AI-агентами;
• Как AI помогает упростить починку багов.

В программе ещё много практических кейсов. Также нужно отметить, что у конференции очень удобный формат. Это пять дней Zoom-сессий по утрам и вечерам и закрытое Telegram-комьюнити, где можно обсудить новый опыт и узнать от единомышленников то, что не догадаешься спросить у своей LLM.

Приходите, чтобы разобраться, какие задачи уже можно делегировать AI, где важно сохранять контроль и как выстроить системную работу с AI в команде или проекте.

🔗 Программа и билеты: https://podlodka.io/fecrew

Скидка для моих подписчиков по промокоду workbeer
  • ❤‍🔥 2
Post #645 319
Work & Beer Balance Насколько она умная? В реальном RAG-сервисе ZüriCityGPT на реальном пользовательском трафике Apertus 1.5 70B получил средний score 3.99 против 4.81 у GPT-5.6 Luna. Но вот что интересно, 2 октября 2026 опубликуют результаты бенчей маленькой Apertus 1.5 8B…
Ну и если вы пользуетесь продутами Proton - VPN или почтой, то вам будет интересно узнать что их LLM чатик lumo как раз таки использует Apertus (правда еще версии 1.0 пока)
lumo.proton.me Lumo: Privacy-first AI assistant where chats stay confidential Meet Lumo, the zero-access encrypted AI assistant by Proton that does not track or record your conversations. Ask me anything — it's confidential
  • 👍 1
Post #644 316
Work & Beer Balance Есть такая LLM модель о который вы скорее всего не слышали, но она заслуживает вашего внимания - Apertus. Интересна она по нескольким причинам: Во первых это действительно новая с нуля обученная модель а не модфикация glm или дипсика которые дестиляции клоды…
Насколько она умная?
В реальном RAG-сервисе ZüriCityGPT на реальном пользовательском трафике Apertus 1.5 70B получил средний score 3.99 против 4.81 у GPT-5.6 Luna.

Но вот что интересно, 2 октября 2026 опубликуют результаты бенчей маленькой Apertus 1.5 8B (MMLU-Pro, GSM8K, IFEval, LongBench, GPQA, MATH-500, AIME и MGSM + несколько релаьных бизнес задач) и уже анонсировали что среди моделей 7–9B Apertus 1.5 оказался сильнейшим среди протестированных open-моделей
  • ❤ 5
Post #643 320
Есть такая LLM модель о который вы скорее всего не слышали, но она заслуживает вашего внимания - Apertus.
Интересна она по нескольким причинам:

Во первых это действительно новая с нуля обученная модель а не модфикация glm или дипсика которые дестиляции клоды и gpt.

Во вторых, в противостоянии США и Китая появился новый игрок - Европа (EPFL, ETH Zürich и Swiss National Supercomputing Centre, модели тренируют на суперкомпьютере Alps в Лугано).

В третьих - это самая открытая модель - в опенсорсе не только веса, но и информация о всех датасетах на которой ее тренеровали, рецепеты и детали процесса обучения. Лицензия тоже достаточно свободная (Apache 2.0)
С датасетами тут особо заморочились - используются только полностью открытые training data, стараются соблюдать opt-out владельцев контента и специально применяют методы для уменьшения memorization, т.е. модель запоминает факты, закономерности, стиль, но не конкретные фрагменты. А это значит что нарушить авторское право используя эту модель шансов намного меньше чем с другими моделями

А что умеет? Она нативно-мультимодальная, т.е. умеет в текст, картинки, звук в обе стороны. thinking mode, tool use тоже на борту.

P.S. Надо будет проверить, может это будет единственная модель в мире которая умеет переводить на шотландский?
YouTube Подросток научил нейронку неправильному шотландскому новости, новости сегодня, новости дня, главные новости сегодня, гла...
  • 👏 4
  • 👍 1
Post #642 344
"How would you like to proceed?" спрашивает меня агнет.

Сохраню для предков как у нас выглядела безопасность в 2026ом
  • 😁 1
Post #640 618
Work & Beer Balance В следующие лет 5 я ожидаю увидеть интересную ситуацию - представьте что станет возможным купить платку для установки в ПК на которой будет написано - GPT-6 Astra. И ей не нужны будут горы оперативной памяти или мощный процессор, но при этом она позволит вам…
Каждый раз вычислительным блокам нужно снова читать огромный объём весов из памяти (которые не поменялись) чтобы произвести вычисления для следующего токена. И так снова и снова.

Ну вы поняли - узкое место не скорость вычислений, а пропускная способность между памятью и вычислительными блоками. По эффективности это похоже на наполнение ванной чайной ложкой.

В Taalas придумали как решить проблему принципиально, и хранить на кремнии сразу веса модели, и электрически прямо на этом кремнии воспроизвести процесс вычисления (на одном транзисторе и параметр хранится и на нем же умножение с ним выполняется ). Нет постоянных обращений к памяти - нет проблемы пропускной способности!

Причем процесс такого "запекания" модели в чип удалось сократить до 2х месяцев. И хотя сейчас llama зашивается сильно квантизированной (3-6 бит) следующее поколение с большим количеством битов уже на подходе.

А это значит что в перспективе ближайших лет мы вполне можем увидеть обвал стоимости токена для своего рода "LTS моделей". Т.е. за совсем свеженькую надо будет платить как и раньше, а вот за пол года "полежавшую" в несколько раз (если не степеней) меньше, и на скоростях которые мне даже представить тяжело

Глядишь и опертивку можно будет по старой цене купить которая уже не нужна будет в таких обьемах...

Чуть не забыл - вот тут можно пощупать эту запеченную в кремнии модель онлайн: https://chatjimmy.ai
chatjimmy.ai chat jimmy chat jimmy LLM web interface
  • 👍 10
Post #639 538
В следующие лет 5 я ожидаю увидеть интересную ситуацию - представьте что станет возможным купить платку для установки в ПК на которой будет написано - GPT-6 Astra. И ей не нужны будут горы оперативной памяти или мощный процессор, но при этом она позволит вам запускать конкретно эту модель на скоростях в ДЕСЯТОК ТЫСЯЧ токенов в секунду.

Звучит как фантастика, но в компании Taalas уже доказали что это возможно и сделали такой Llama 3.1 8B чип который выдает 17к токенов в секунду (по публично доступному тесту 15к+). В довесок Taalas утверждает что система поулчилась в 20 раз дешевле и потребляет в 10 раз меньше. Как это возможно?

Дело в том что веса у обученной модели которую мы с вами используем каждый день - не меняются. А любой современный ПК спроектирован для того чтобы работать с динамическими данными, поэтому его работа с моделью мягко говоря - не оптимальна.
  • 👍 8
  • 🔥 3
  • ❤ 1
Post #638 687
Work & Beer Balance Как писать перфоманс тесты? Unit тесты и e2e сейчас кажется уже есть везде - с появлением агентской раработки такие тесты стали краеугольным камнем разработки. Линтерами и регулярками я с большего закрыл code quality моменты (вплоть до максмиамльного размера…
В целом немного беспокоюсь за будущее софта с учётом того что именно перф останется без контроля во время бума генерированного кода
  • 💯 2
Post #637 655
Как писать перфоманс тесты?

Unit тесты и e2e сейчас кажется уже есть везде - с появлением агентской раработки такие тесты стали краеугольным камнем разработки.

Линтерами и регулярками я с большего закрыл code quality моменты (вплоть до максмиамльного размера файла, длинны комменатрия и нарушения границ модулей)

А вот перфоманс - у меня нет идей как его нормально тестировать и обнаруживать деградации - даже фиксирование FPS или времени прогона не помогает - разные машины имеют разный перф, с таким тестами нужно в комплекте выдавать "референсную" железку что конечно же утопия.
  • 👍 4
Post #636 642
Work & Beer Balance Представьте - вы в горах на хайкинге, и вам с другом нужно разделиться. Мобильная связь в таких местах, как обычно, не ловит: вышка далеко, а между вами и ей ещё и гора. Какие есть другие варианты? Bluetooth Есть в каждом смартфоне, работает без вышек, существуют…
Ну зато мы можем ее добавить сами!
Я взял на алике вот такой передатчик
RAK3272S, добавил к нему USB do TTL CP2102 чтобы это все можно было запитать и использовать из андроида
(правда 3.3V там оказались не стабильные так что добавил еще стабилизатор D45V5F3)

Навайбкодил себе приложуху на андроид и теперь у меня есть LoRa чат в смартфоне XD
  • 👍 5
  • 🔥 5
  • ❤ 2
Post #635 517
Представьте - вы в горах на хайкинге, и вам с другом нужно разделиться.

Мобильная связь в таких местах, как обычно, не ловит: вышка далеко, а между вами и ей ещё и гора.
Какие есть другие варианты?

Bluetooth
Есть в каждом смартфоне, работает без вышек, существуют даже чаты поверх него. Однако дальность довольно скромная — для связи между смартфонами обычно речь идёт о десятках метров, примерно до 50 м. В идеальных условиях Bluetooth LE может работать значительно дальше, но рассчитывать на это в горах не стоит.

Wi-Fi
5 GHz при прямой видимости вполне способен работать на расстоянии порядка сотни метров, иногда и дальше, но плохо переносит препятствия и особенно растительность.

2.4 GHz получше: при прямой видимости связь со смартфоном может сохраняться примерно на 150–300 м, и хотя более низкая частота также лучше проходит через препятствия, в лесу эти цифры стремительно уменьшаются. Влажная листва, стволы и рельеф поглощают и рассеивают сигнал; вместо сотен метров могут остаться десятки метров.

За эту не слишком впечатляющую дальность Wi-Fi приходится платить ещё и расходом батареи. Wi-Fi в активном режиме обычно потребляет в несколько раз больше энергии, чем Bluetooth LE, а при редком обмене короткими сообщениями разница может быть до 10 раз больше.

А вот что идеально бы подошло так это...

LoRa
Пропускная способность слабая: современные LoRa-чипы имеют максимальную скорость всего около 62,5 кбит/с. На режимах максимальной дальности это канал для коротких текстовых сообщений, координат и телеметрии, а не для картинок и видео.

Зато дальность совсем другого порядка: примерно 2–5 км в плотной городской застройке и до 15 км в сельской местности, а в горах при хорошей прямой видимости - потенциально ещё больше.
Работает LoRa, в частности, в европе в диапазоне около 868–869 MHz. Это более длинная волна по сравнению с wifi, поэтому сигнал заметно лучше переносит растительность, чем 2.4 и особенно 5 GHz. Конечно, гора посередине всё ещё остаётся горой и чудес LoRa не творит.

И энергии ей нужно удивительно мало. Например, современный LoRa-чип SX1262 потребляет от 4,6 мА а простое и диапазоне от 45 мА до 118 мА при передаче.

Если вы раньше слышали про Meshtastic - он как раз работает на LoRa сети.

Но, в нашем случае меш сеть не требуется, поэтому хватило бы и Peer to Peer варианта, жаль в смартфонах нет поддержки LoRa
  • 👍 5
  • 😁 2
  • ⚡ 1
  • 🙏 1
Post #634 623
Модели OpenAI уберут из Cursor потому что его купила Илона, известная тем что постоянно нарушает договоренности по поводу использовния AI. Вобщем Маск в черном списке у OpenAI.

И в codex вернут 5ти часовой лимит для Plus плана. Интересно что обьяление было сделано 25 числа, и доку уже обновили - но по факту новый лимит в codex не отображается и такое ощущение что его нет

Странное
X (formerly Twitter) Tibo (@thsottiaux) on X Codex & ChatGPT @OpenAI
  • ❤ 1
Post #633 605
Work & Beer Balance Вот какие результаты спустя день работы в таком режиме: * Модель стала намного чаще меня спрашивать о решениях и развилках Это не удивительно и не уникально - цикл ревью разными моделями по разному обученными поднимает больше вопросов и эйджкейсов * Кодекс…
При этом замечу что сама по себе система нестабильная и переодически зависает именно на кодексе.
Когда он закачивает слайс у него иногда в обвязке срабаывает хук на окончание задачи который прибивает все висящие в фоне "забытые" шелы включая вотчер за новыми тасками (при этом появляется надпись goal stale и предложение возобновить goal). Кодекс пытался это поправить но сдался

Но с учетом того что мне надо делать ручной clear между слайсами это уже ни на что не влияет.

Вобщем обвязка все же нужна, но зато я получил интересный опыт как сегментирование контекста возможно через создание иреархии из агентов
  • ❤ 4
Post #632 564
Work & Beer Balance Почитав вчера как агенты огранизовали форум из файлов и папок для взлома hugging face (если вы еще не читали то обязательно прочитайте) я подумал: Это что же, никаких обвязок и "харнессов" не нужно? И решил повторить эксперимент у себя: Клоде (Opus xhigh)…
Вот какие результаты спустя день работы в таком режиме:

* Модель стала намного чаще меня спрашивать о решениях и развилках
Это не удивительно и не уникально - цикл ревью разными моделями по разному обученными поднимает больше вопросов и эйджкейсов

* Кодекс стал впитывать большую часть нагрузки (токенов).
А вот эта часть интереснее. Изначально мне показалось что расход токенов существенно уменьшился, но это не совсем так.

Просто недельный лимит кодекса заполняетя медлнее 5ти часового лимита клода, и визуально на дешборде это стало выглядить как будто токены стали сгорять медленее.

Но теперь я вижу что просто нагрузка сместилась на кодекс, но это именно то что мне и надо было, ведь он в любом случае выходит мне дешевле (недельный лимит сбрасывает раньше, и еще ручной сброс подкидывают).

* Токены сгорают быстрее если контекст забит

Вот здесь выглядит так что я токены сэкономил, хотя у меня нет цифр на руках так как я так и не придумал как доказать это эмперически.

Поэтому дальше только мои наблюдения и мысли

Но сначала надо немножечко углубится в то как порезан мой эпик:
На верхнем уровне идут фазы (A, B, C, D и тд)
В них вложены слайсы у которых могут быть подслайсы (A1, B2, D41)

Раньше я двигался просто по-порядку создавая нового агента на фазу и держал его до конца фазы, делая только compact между слайсами

Практика показала что слишком частые компакты делают только хуже - агент все равно все перечитывает и переуточняет если текущие задачи все еще требуют старого контекста, поэтому не чаще чем между слайсами
Чтобы основной агнет не забивал свой контекст я просил его максимально делегировать все сабагентам, но все-равно под конец слайса миллионый контекст опуса обычно забаивался на 60-70%

Теперь же под конец слайса контекст рутового опуса забивается на 35-55% и в целом он жгет меньше токенов, даже не смотря на то что ему теперь приходится несколько раундов править свой изначальный план на слайс.
Я думаю это связано с тем что в середине процесса появился sol.

Хотя изначально я дал ему очень ограниченную роль - критиковать план на слайс и запускать сабагента по вотчу - я вижу что он взял на себя и другие роли:

- на стадии ревью - роль фактчекера. План составляется опусом в основном на данных собранных грепами, а сол при критике реально просматривает интересубщие его файлы. Это быстро забивает его контекст, но дает ему возмоджность предвитеть ошбики в плане. Интересно что соннет сам отмечае что "стратегия опрадывает себя полностью и каждый рах находит серьязные недочеты в плане вот уже 5ый раз слайс подряд"

- роль "няньки" за кодящим терра - вся проверка написанного кода и его подгонка легла на него, а опус просто финально прогоняет тесты и "одим глазком" смотрит что все ок. Такого чтобы он что-то дописывал сам или возращал работу не было не разу (а раньше бывало через раз не смотря на то что сабагнетом был соннет, и каждый раз ему приходилось погружатся глубже в написанный код)

- он же определяет где работу можно распаралелить на несокльких агентов (что тоже требует проверки и размышлений)

Интересно что уже на третьем слайсе терра стал жрать токены как не в себя из-за чего я делаю вывод - чем больше заполнился контекст тем больше расход токенов.
Хорошая новость - что промежуточный sol я могу полностью переосоздавать после каждого слайса, ему ничего не нужно знать о том что было до и что будет после - за это уже отвечает соннет.

👉 трехуровневая иерархия ненароком дала мне четкую границу по которой я могу сбрасывать ненужнй контекст не рискуя затереть нужный.

Получилась оптимальная для меня система архитектор - тимлид - кодер
Older posts →

About this channel

How can I read @workbeer without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Work & Beer Balance: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Work & Beer Balance have?
Work & Beer Balance (@workbeer) has 1.55K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Work & Beer Balance know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →