
🎤 Декомпозиция юзера на кластерные сущности
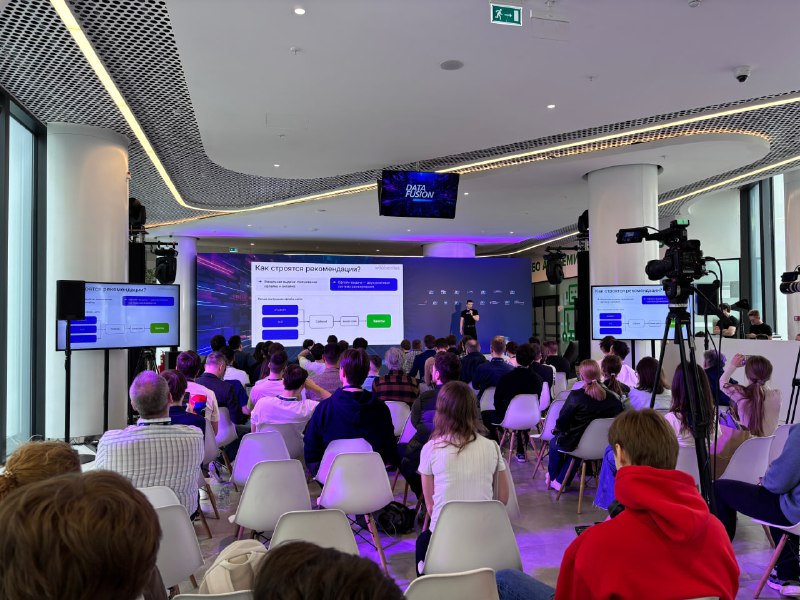
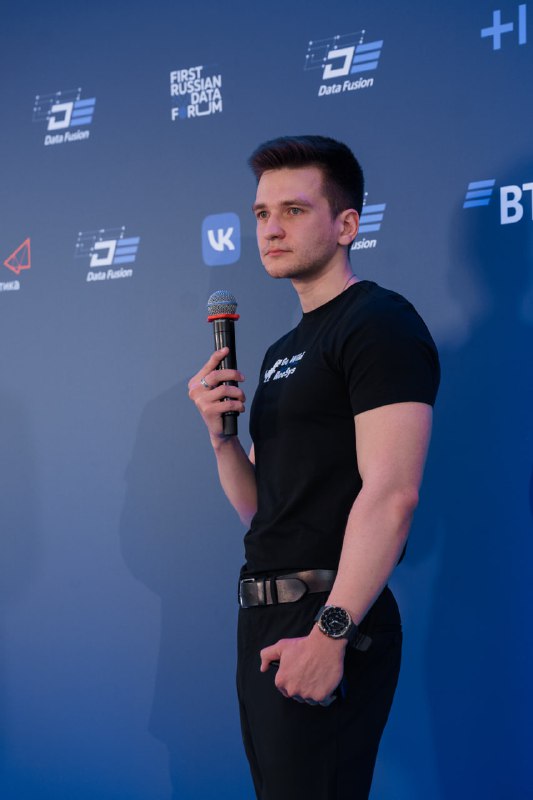
На прошлой неделе прошла конференция Data Fusion, где в кейс-сессии рекомендательных систем мы рассказали как не разориться на инфраструктуре при постоянном росте количества пользователей
➡ Запись сессии
➡ Презентация
❓ Описание
При построении персональных рекомендаций зачастую подразумевается, что мы должны получить для каждого пользователя свою, уникальную подборку товаров. Однако в случае, когда пользователей становится слишком много, а в инфраструктуре товары хранятся с обогащением бизнес-факторами, такая схема становится все менее масштабируема.
Расскажу о том, как мы без просадки в качестве существенно сократили затраты на инфраструктуру за счет кластеризации пользователей и товаров.
💬 Основные тезисы:
- кластеризация пользователей (эмбеддинги WildBERT), создание агрегированной выдачи для кластера
- кластеризация товаров (e5) - выделение интересов, отображение пользователя в пространство интересов
- сравнение АБ-тестов для схем "храним подборку для каждого пользователя" и "храним только кластера, юзера описываем как набор кластеров и интересов" в разрезе ранжирующих метрик и затрат на инфраструктуру
- как в такой схеме не просадить качество - доранжирование по эмбедингам в онлайне в момент формирования выдачи
⏱ Скоро расскажем как выступили на Стачке в Ульяновске, которая также прошла на прошлой неделе
Post #41
6.35K
- 👍 24
- 🔥 14
- ❤ 10
- 🍾 1