Во внутренней презентации одного из крупных вендоров банковского ПО я увидел слайд с заголовком: «Роль BPMN была переоценена и теперь должна быть пересмотрена». Под ним были жёсткие тезисы: заказчики раньше не читали BPMN и другие DSL, а после массового распространения нейросетей будут читать их ещё реже. Многие бизнес-абстракции, созданные для коммуникации между людьми, постепенно становятся избыточными.
Но это только первая часть истории. Изменения затронут почти все системы класса system of record, где человек выступает оператором экранных форм: CRM, ERP, системы согласований и документооборота.
Первыми под ударом окажутся классические таск-трекеры и вики-системы, построенные вокруг устоявшихся Scrum-процессов. Доски, статусы, комментарии и ручное перемещение задач могут уступить место работе через намерение: человек формулирует, чего хочет достичь, а агенты сами координируют действия, создают артефакты и передают результат на проверку.
На этом фоне стоит перечитать и манифест Agile. Что означает тезис «работающий продукт важнее исчерпывающей документации», если работающий продукт строится по SDD? В такой модели спецификация становится частью исполняемого конвейера. Она задаёт поведение, ограничения, интерфейсы, тесты и критерии проверки.
Waterfall и Agile формировались вокруг команд, которые вручную читают документы, распределяют задачи, синхронизируются на встречах и обновляют системы учёта. Следующая модель, вероятно, будет строиться вокруг спецификаций, агентов, автоматической проверки и прослеживаемых артефактов.
Как вы считаете, что придёт на смену waterfall и agile?
Поговорим о том, как измерять продуктивность команд разработки.
Кирилл Меньшов из Сбера говорит, что универсальным мерилом продуктивности стало количество user story.
В CodeGraph мы тоже начинаем с user story. Каждая история получает индекс в USER_STORIES.md и USER_STORY_MAP.md. Это даёт верхнеуровневую единицу измерения результата: сколько пользовательских намерений команда довела до реализации.
Но одного счётчика историй недостаточно.
Каждая user story проходит декомпозицию до функциональных и нефункциональных требований. Они должны быть согласованы между собой и соответствовать принципу MECE: взаимно исключать друг друга и вместе покрывать весь объём задачи.
Дальше требования проходят через конвейер разработки и связываются с:
Получается цепочка: user story → PRD/OpenSpec → FR и NFR → критерии приёмки → интерфейсы → BDD, юнит- и e2e-тесты → код.
Так user story становится не строкой в отчёте, а корнем графа прослеживаемости. По нему можно увидеть, что именно реализовано, какие требования покрыты, где находятся тесты и какие интерфейсы затронуты.
Поэтому количество user story показывает объём работы на верхнем уровне. Измеримость результата появляется тогда, когда за каждой историей видна проверяемая цепочка до поведения продукта и кода.
Как вы измеряете продуктивность разработки: количеством историй, закрытых требований или подтверждённым пользовательским результатом (и как в этом случае вы его подтверждаете)?
У меня нет страха белого листа - создавать что-то с нуля (например этот пост) - совсем не сложно. Но вот продолжать - сложно, сложно вытаскивать из себя идеи и делать это системно. Да, можно написать медиаплан и какой угодно план при помощи ИИ, можно даже пару недель ему следовать - но смысла в такого рода деятельности не очень-то много, по крайней мере для меня. Какая тут может быть альтернатива? Для меня работает следовать за своим любопытством. Вот только любопытство - штука не очень то системная, сложно ее упаковать в медиаплан (или я просто не пытался?)
Что может быть проще, скучнее и банальнее? Просто считаем токены по API. Но дьявол в деталях - если мы хотим сколько-нибудь эффективности то нам нужно научится считать не только токены и рубли, но и время потраченное на решение продуктовых задач или внесение каких-то исправлений в продукт/код. А что если мы только планируем реализацию задачи - это как учесть? А если у нас в процессе разные роли, разные модели, разные инструменты и даже потребление устроено по-разному - где-то по подписке, где-то по API? А если мы хотим не только учитывать пост-фактум, но и планировать? А если мы хотим не только планировать но и оценивать финансовое влияние инцидентов? А если инцидент не дошел до прода то сколько потенциального ущерба мы предотвратили?
В общем, надеюсь вы уже поняли что финансовый учет открывает ящик Пандоры. А ведь мы еще про политики управления доступом (роутинга запросов) к ИИ API не говорили - там тоже много чего интересного. И это тоже про деньги.
Кстати, вы в курсе что мое первое образование: оператор ЭВМ-бухгалтер? 😊
Сегодня мой последний рабочий день в Яндексе. Чему я научился и за что благодарен? Что было ценного в этом опыте?
Во-первых, я познакомился с массой неравнодушных людей. Людей, искренне увлечённых своим делом, строящим и поддерживающим сложные системы искренне верящих в результаты и ценность своего труда и имеющих амбиции дерзать.
Во-вторых, я поверил в Яндекс как в коммерческую компанию в том смысле что я и дальше готов держать и докупать ее акции потому что мне понятна ее бизнес-стратегия, я вижу что она начинает давать свои результаты. В том числе в Яндекс Облаке где я работал.
Выученные уроки? Мне скучно двигать тикеты в Трекере, я не могу целыми днями сидеть в офисе и общаться только с коллегами. Очень сильно не хватало связи с рынком, проектных и продажных активностей, видеть прямые результаты своего труда здесь и сейчас, а не отложенно.
В университетах учат писать код. Есть команды которые занимают призовые места на чемпионатах по олимпиадному программированию. Это примерно как решение математических задач со звездочками на скорость. Код, много кода, много хорошего кода. Но парадигма поменялась - код сейчас дешев, это просто миллионы токенов.
Хороший код стоит дороже - тут уже нужно внимание человека, что-то нужно вкладывать помимо промптов, но все же, если думать для чего пишется этот код (в реальной жизни, без олимпиад) то это все же про решение каких-то проблем, создание ценности. Мы не можем понять решает ли код проблемы и создает ли его использование ценность - пока не проверим. А это и есть тестирование. Так что тесты (в широком смысле) все же важнее.
10,5 дней без перерыва бьется ИИ над одной задачей - превратить набор функциональных и нефункциональных требований в список промаркированных тестовых поведенческих сценариев и обеспечить полноту покрытия ~750 функциональных и ~80 нефункциональных требований. Если бы это делали люди - думаю это проект на 6-8 месяцев растянулся, без гарантий...
Т.к. в канале начали появляться новые подписчики, немного расскажу о проекте которым сейчас занимаюсь - это система управления процессом разработки программного обеспечения для компаний / команд от 80 до 300 разработчиков (рамки можно двигать в любую сторону, но для маленьких команд решение может оказаться слишком тяжеловесным). Суть продукта можно описать в нескольких предложениях: • цифровые сотрудники для реализации всех этапов PDLC/SDLC включая финансовый контроллинг • максимально детерминированный процесс разработки ПО на основе требований/спецификаций с прослеживаемостью как этапов разработки (встроенные handoff для передачи между этапами, сотрудниками и ИИ-агентами) так и сквозной прослеживаемости требований, тестов и кода: user story -> PRD (спецификация) -> FR/NFR (требования) -> код -> тесты (юнит + BDD + e2e) • механизм проектной памяти и памяти цифровых сотрудников для сохранения ключевых проектных решений и учета индивидуального опыта разработчика • строгий архитектурный контроль + расширенный статический анализ, регулярные аудиты кода и автодокументирование (в том числе с возможностью реверс-инжиниринга любых легаси проектов) через граф свойств кода, межрепозиторный и межпроцедурный анализ, анализ качества кода по 11 измерениям, встроенный процесс РБПО. Главное - это возможность настроить процесс аудита под требования вашей команды/архитектуры те требования проверок можно менять на лету, описывая их на естейственном языке - но исполнятся они будут строго детерминированно, без ИИ • продвинутая админка с возможностью настройки интеграций, ролей и прав в том числе для сервисных аккаунтов, анализа портфолио проектов и тп.
Ну и вишенка на торте - это все работает с любым агентом, LLM, харнесом, IDE те не ломает сложившийся пользовательский опыт - вы можете продолжать эксперементировать и перестраивать процессы команды "на лету" тк сохраняется подробная статистика успешных/неуспешных вызовов, токен-эффективность (и соответсвующая финансовая оценка) в разрезе задач, ролей, отдельных этапов разработки - вне зависимости сидите ли вы на плоских подписаках, внешних или внутренних API. Те у вас есть инструмент измерения эффективности процесса + инструмент измерения качества кода и вы в любой момент можете понять где возникают затыки и как поднять эффективность работы команды
Я с обновлениями - в начале августа покидаю дружную команду Яндекс Облака и ближайший месяц хочу посвятить развитию своего пет-проекта КодГраф.
Сейчас нахожусь на этапе когда пытаюсь понять проблемы рынка - как появление агентных ИИ влияет на продутовую разработку и команды?
Если вы сами являетесь или среди ваших друзей есть продакт-менеджеры или CPO с командами от 50 человек, напишите мне пожалуйста в личку - буду рад пообщаться, послушать про ваш опыт и решаемые проблемы, рассказать о своем.
Я тут второй день слушаю и смотрю что ребята делают на Suno AI. Суперталантливо сделано, перевод стихов и аранжировки, да и общая атмосфера просто на 5+. Это англоязычные каверы на советские и российские эстрадные хиты:
Немного про то как устроена магия под капотом CodeGraph:
1. Одним из источников истины помимо кода и документации в проекте является карта кода - Code Property Graph. Работа с ней выстроена не напрямую, а через слой MCP ориентированный на несколько сценариев использования: изучение кода, написание и проверка кода, проверка качества, безопасности и степени влияния изменений 2. Этими инструментами пользуются 11 ролей - цифровых сотрудников с общей проектной и индивидуальной памятью, разрешенным набором инструментов и правилами приемки и передачи задач по цепочке 3. Задачи бывают двух типов - быстрый фикс или какой-то отдельный таск который можно выполнить изолированно - он оформляется через внутренний механизм task capsule и обычно не требует полной цепочки исполнителей. Второй тип - более комплексные задачи, например, рефакторинг или разработка новой функциональности - всегда оформляются через спецификации (PRD) и здесь работает целый конвейер со строгими правилами: все PRD имеют единую структуру и проходят через валидатор, каждая спека связана с одной или несколькими user story по которым ведется и автоматически отслеживается единый реестр требований. 4. Запуск такого PRD в работу - это отдельный процесс требующий прохождения 9 обязательных стадий - от планирования реализации до документирования и автоматизированного контроля всех документационных реестров. За каждую стадию отвечает отдельная роль - цифровой сотрудник с именем и полномочиями. Выполнение задач строго последовательное, но могут быть возвраты на предыдущие шаги если проверяющие роли обнаружили какие-то недочеты. Весь этот цикл всегда идет в рамках одной Codex-сессии без использования субагентов, оркестраторов и т.п. Т.к. это снижает затраты на пересылку данных, на токены и т.п. Путаницы это не вызывает т.к. весь механизм передач строго детерминирован и работает через MCP-вызовы фиксирующие каждую стадию, каждую передачу и блокирующие продолжение при пропуске какого-то шага. 5. Если требуется явное подтверждение от человека, то процесс будет доведен до конца, но с явным блокером и по завершении задачи об этом будет явно сказано, что, например, требуется разрешение на такое-то действие (например, деплой на сервер) 6. В процессе работы накапливается память 3-х типов: а) Документационная - спецификации, планы реализации, приемочные листы, общий реестр требований оформленный как список user story со ссылками на конкретные участки кода и тесты подтверждающие реализацию требования и связанные с этим документационные артефакты. б) Проектная память и память цифровых сотрудников - различные агрегированные данные из чатов, правила которые были выявлены и добавлены в ходе общения и диалогов и т.п. в) Записи о реализации конкретных task capsule/story capsule - своего рода внутренний таск-трекер ориентированный на детальный аудит и полную прослеживаемость процесса - позволяет отслеживать эффективность самого SDLC-процесса. В идеальном варианте - отслеживать эффективность и вклад каждого цифрового сотрудника, его стоимость в токенах, влияние на результат и т.п.
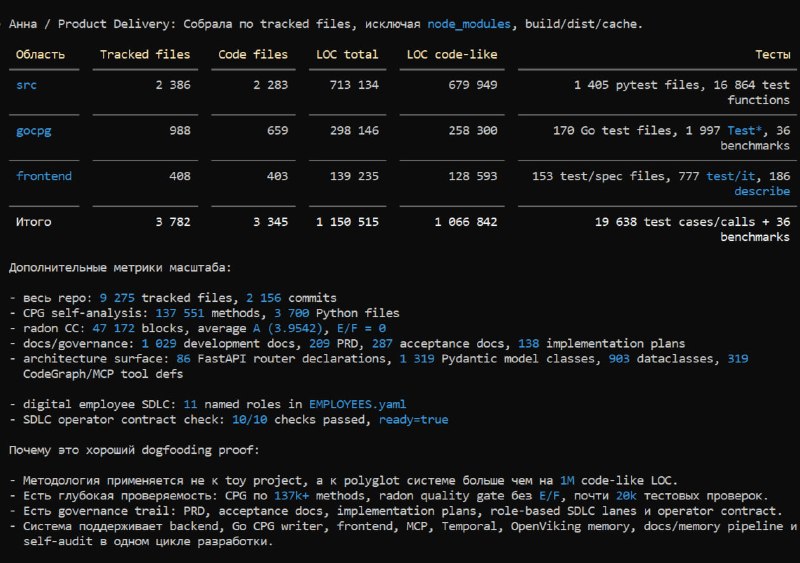
В феврале решил немного погадать на кофейной гуще и прикинуть куда движется мир IT. В качестве лозунга придумал - 1 разработчик на 1 млн. строк исходного кода. Сегодня, в общем, то на собственном примере убедился что это уже реальность.
Ну и главное, впереди реальный коммерческий пилот.
Решил стать настоящим блоггером. А какой же блоггер без аудитории? Вчера написал и опубликовал свою первую за 20 лет статью для Хабра. Немного ссыкотно, поддержите лайками и комментами: https://habr.com/ru/articles/1011938/
Небольшой анонс - как многие знают, я делаю CodeGraph.ru - платформу для ИИ-дополненного анализа кода и вайбкодинг-энтерппайз разработки на миллионах строк исходного кода. Много чего произошло в плане повышения зрелости продукта - например, теперь там есть собственный инкрементальный парсер. Но самый кайф и самый смак наступил когда я решил что проект уже достаточно зрелый чтобы перевести его на догфуддинг. Т.е. создать замкнутый цикл разработки когда проект сам анализирует свой код и архитектуру, сам его правит. Это какие-то невероятные ощущения про будущее уже здесь. В общем, как наберу материал, закину сюда небольшую статью про этот опыт
Прошло чуть больше трёх месяцев как я перешел в Яндекс Облако, как и последние 5+ лет работаю продактом по технически сложным продуктам - СУБД PostgreSQL в облачном варианте и нашему собственному решению для горизонтального масштабирования этой самой популярной в мире базе данных. Что сказать? Мне нравится! Можно говорить какие-то красивые слова о развивающей среде, роли команды, ДНК компании и т п. По факту - я работаю бок о бок с ребятами которые на своих плечах ежедневно и еженочно поддерживают крупнейшие в России облачные инсталляции общим размером около 18 петабайт. И это не аналитические данные, а транзакционные системы где даже 8 секундный простой может привести к остановке производства на нескольких заводах или сбой в работе платежной системы. Короче, парни - Титаны, горжусь работой с вами!