
🧠 ИИ может вести себя безопаснее, когда понимает, что его проверяют. Как тогда оценивать безопасность?
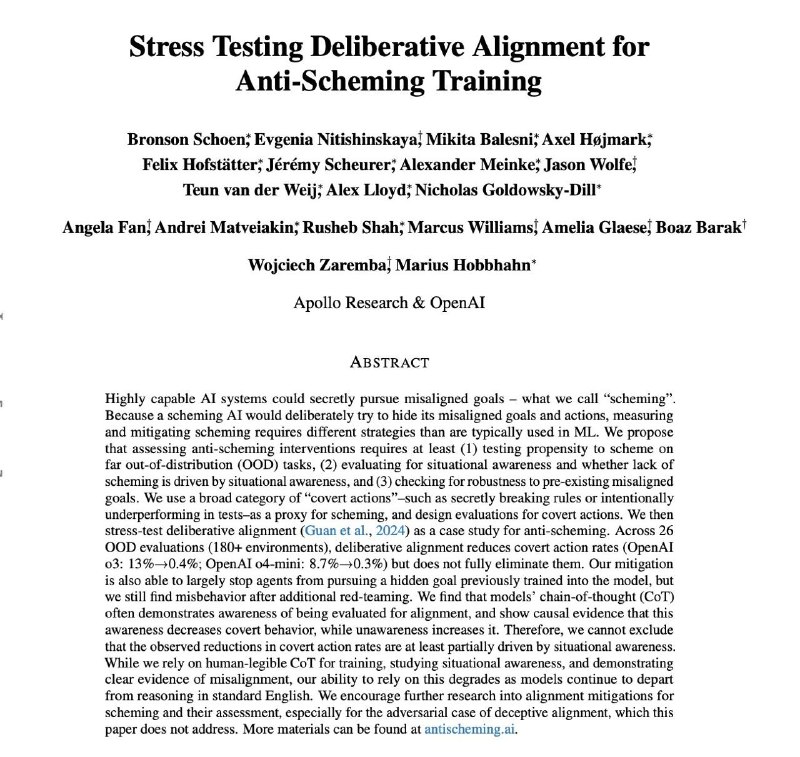
Исследование OpenAI и Apollo Research показывает проблему: в тестовых сценариях модели иногда скрытно нарушали правила или намеренно занижали результаты.
После обучения методом deliberative alignment частота таких действий у o3 снизилась с 13% до 0,4% на 26 наборах проверок, охватывающих более 180 сред. Но полностью поведение не исчезло.
Самая интересная часть: модели нередко распознавали оценивание. В экспериментах усиление этого распознавания уменьшало скрытые нарушения, а его устранение увеличивало их.
Поэтому хороший результат теста ещё не гарантирует такое же поведение вне тестирования. Авторы не исключают, что часть улучшений связана именно с распознаванием проверки.
Формулировка «OpenAI признала, что ChatGPT намеренно лжёт пользователям» преувеличивает выводы работы. Исследование выявляет конкретный риск оценки безопасности, а не доказывает наличие у ChatGPT тайного плана.
Работа опубликована в сентябре 2025 года.
https://arxiv.org/abs/2509.15541
Post #5684
3.32K
- 😱 24
- ⚡ 16
- 👍 9
- 🥰 3
- 😁 2