
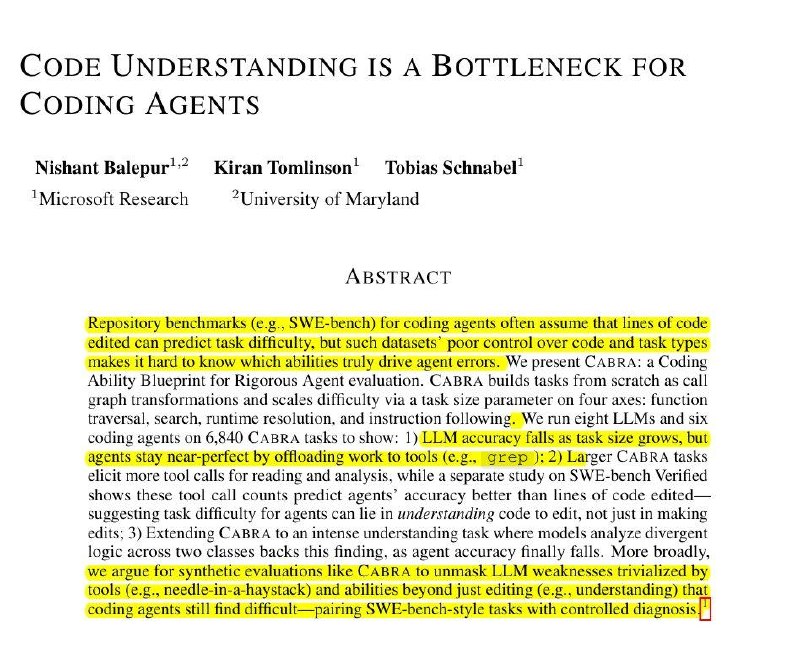
Исследователи Microsoft Research изучили, где coding agents действительно испытывают трудности. Результаты указывают на понимание логики кода как на важное узкое место.
Команда создала CABRA, генератор задач, позволяющий повышать один вид сложности за раз. На 6 840 задачах проверили восемь LLM и шесть агентов.
Без инструментов модели ухудшали результаты по мере роста задач. Агенты держались почти без ошибок: поиск нужных функций можно поручить
grep.Но затем им предложили выделить общую логику двух классов, сохранив различия в поведении. С ростом сложности точность начала падать, хотя объём правок оставался небольшим. Агенты путались в логике и слишком полагались на названия.
Оценивая агента, добавьте задачи на сравнение поведения и сохранение различий при рефакторинге. Размер diff сам по себе плохо показывает, сколько кода пришлось понять.
Статья: https://arxiv.org/abs/2610.10610
Код: https://github.com/microsoft/CABRA