
Почему-то во всех командах, где я работал, я всегда отвечал за оценку, сколько нам надо GPU. То ли я выгляжу очень экономным, то ли авторитетным. Хотя для оценки GPU надо быть скорее везучим. Потому что оценить, во сколько нам влетит инференс — очень хитрая задача. И зависит это в первую очередь от терпения наших пользователей. Давайте вместе разбираться.
Предсказание в LLM идёт токен за токеном, слева направо. И в прошлом посте мы выяснили, что инференс LLM тормозит, потому что мы на каждый токен гоняем миллиарды весов модели по памяти видеокарты.
На самом деле, я вас тогда капелюшечку обманул. Помимо весов модели, нам придётся гонять ещё матрицу с результатами прошлых вычислений — чтобы не пересчитывать заново всё. Хранятся там K и V каждого прошлого токена, отсюда и название: KV-кэш. Подробнее про это самые любознательные инженеры могут почитать вот тут.
И иногда он даже может занимать памяти больше, чем миллиардные веса модели.
ТУТ НЕМНОГО МАТЕМАТИКИ, БОРИТЕСЬ ИЛИ ПРОПУСКАЙТЕ
KV-кэш занимает =
2 (K и V) × слои × число KV-голов × размер головы × байт × длина контекста
Допустим, у нас 60 слоёв, 8 KV-голов, размер головы 128, и храним кэш в fp16:
2 × 60 × 8 × 128 × 2 = 245 760 байт ≈ 246 КБ на токен
Тогда, если контекст 2000 на 1 запрос:
245 760 × 2000 ≈ 0,49 ГБ =
= Полгигабайта памяти. На один запрос.
Сева, ну и что нам с этих полгигабайта?
Память = размер модели + батч × размер KV-кэша
И тут ключевое: веса общие для всех запросов в батче, а KV-кэш у каждого свой. Поэтому веса делятся на всех, а кэши складываются.
Возьмём модель 35B в fp8 — это 35 ГБ. Если батч маленький, KV-кэш мал, на него можно забить. Но если батч 100, то кэш уже 50 гигабайт — больше, чем сама модель, и основное время будет уходить на его загрузку.
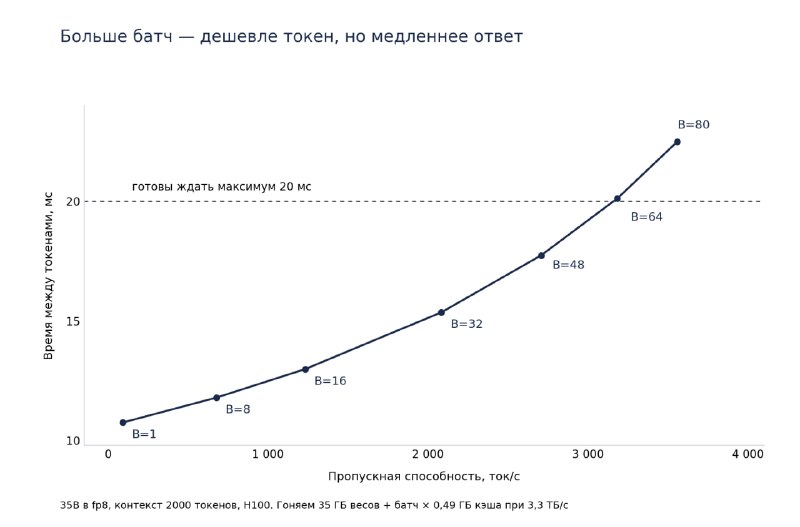
Итого очень понятный размен: больше батч — мы загрузили модель 1 раз и параллельно предсказываем весь батч. То есть больше пропускная способность видеокарты (токены в секунду), то есть можем держать больше запросов, то есть нужно меньше карт. Но при этом больше KV-кэш, дольше наш пользователь будет ждать своего ответа.
Можно легко построить график, как время между токенами зависит от пропускной способности карты (
Сева, а что нам делать-то?
Учиться терпению! Ну или платить. Очень простой план:
Шаг 1. Думаем, сколько пользователь готов ждать. Обычно ничего умнее, чем 5 секунд, не придумывается. Интересно, у всех так?
Шаг 2. Прикидываем пиковый RPS в сервис. Потом умножаем на 1.5, потому что прикинули плохо.
Шаг 3. Берём 1 карту, берём корзинку входных запросов (с продовым распределением, чтобы KV-кэш был честный). Бенчим ваш инстанс (команда vllm bench serve). Смотрим p50/p95/p99 перцентили. Расстраиваемся.
Шаг 4. Не хватило — делаем карты ×2, батч падает в 2 раза, время ответа падает по нашему графику. Правда, не в 2 раза, а процентов на 20, увы. Повторять до целевых 5 секунд.
Шаг 5. Видите, что вам нужно 100500 карт — сначала расстраивайтесь. А потом думаете. Может, они могут немножко подождать?))) Я там стриминг намучу, UI красивый сделаю, мемы смешные буду показывать, пока ответ загружается. И на одной H100 как-нибудь протянем...
Говорила мне мама, терпение — золото. 30 лет прошло. И только сейчас до меня дошло.