TGViewer
Channel Public Channel
Вайб-кодинг

Вайб-кодинг

@vibecoding_tg

Авторский канал по ВАЙБ КОДИНГУ

Ссылка для друзей: https://t.me/+ll3pbl442dNkZmYy

Cотрудничество: @devmangx

РКН: https://clck.ru/3RRVfk
Subscribers
63.3K
Photos
2.2K
Videos
924
Links
1.5K

Showing posts older than #3399 · Back to latest

Older Posts 16 shown
Post #3397 17.8K
В Claude Code v2.1.198 появился новый встроенный навык: /dataviz

Он загружает в контекст рекомендации по проектированию диаграмм и дашбордов: выбор типа диаграммы, правила компоновки и визуальную иерархию для интерфейсов с большим объемом данных.

Также в него входит исполняемый валидатор цветовой палитры, благодаря которому Claude может программно проверять контрастность и соответствие требованиям доступности, а не делать предположения.

Ничего устанавливать не нужно - навык уже входит в состав CLI.
Если вам нужно быстро визуализировать данные в HTML и получить качественный результат с первой попытки, этот навык стоит вызывать явно. На втором демо он генерирует дашборд на основе статистики загрузок с http://aitmpl.com. 🐸
Post #3396 18.5K
С Anthropic сняли экспортные ограничения. После конструктивных переговоров с правительством США - доступ к Fable 5 начнут восстанавливать уже завтра

В неё добавлены новые классификаторы, нацеленные на блокировку задач по кибербезопасности. На первых порах часть рутинных операций, вроде кодинга и отладки — будет автоматически передаваться модели Opus 4.8.

Параллельно Anthropic совместно с Amazon, Microsoft, Google и другими партнёрами Glasswing начали разработку консенсусного фреймворка для оценки серьёзности ИИ-джейлбрейков и регламента реакции разработчиков.

Кроме того, компания расширяет сотрудничество с правительством США в области тестирования моделей и мер безопасности. Это будет включать предоставление раннего доступа к моделям и средствам защиты для оценки, обмен информацией о джейлбрейках и злоупотреблениях, а также выделенные ресурсы для совместных исследований. ☕️
Post #3394 17.8K
Sonnet 5 вышел. TL;DR:

1. Anthropic называет его самым агентным Sonnet на сегодня
2. Производительность почти как у Opus 4.8, но дешевле
3. Серьёзные улучшения в рассуждении, использовании инструментов, кодинге и работе со знаниями
4. Модель по умолчанию для Free и Pro пользователей
5. Доступен в Claude Code и API сегодня
6. Вводная цена: $2/M input, $10/M output до 31 августа
7. Стандартная цена: $3/M input, $15/M output
8. В целом безопаснее Sonnet 4.6, ниже уровень галлюцинаций и сикофантии
9. Киберзащита включена по умолчанию, но Opus остаётся сильнее для серьёзной киберработы

Также тестеры сравнили Sonnet 5 с Opus 4.8, Sonnet 4.6 и GPT 5.5.

Всем четырём моделям дали одинаковый промпт: создать три автономные HTML5 Canvas-сцены с реалистичной физикой столкновений.

Промпты:
- Автомобиль врезается в кирпичную стену.
- Шар для сноса разрушает дом.
- Катапульта запускает камень в стену замка.

Результаты:
Sonnet 5: 15 047 токенов, $0.15
Opus 4.8: 23 063 токена, $0.58
Sonnet 4.6: 25 824 токена, $0.39
GPT 5.5: 31 152 токена, $0.94

Sonnet 5 показал такой же уровень, как Opus 4.8 и GPT 5.5, во всех трёх тестах. В сценарии с шаром для сноса он превзошёл Opus 4.8: трос двигался плавно, и каждый удар приходился точно в цель. В тесте с катапультой он оказался лучше GPT 5.5: камень каждый раз попадал внутрь стены.

При этом Sonnet 5 всё ещё уступает по детализации и качеству графики. Зато он использовал меньше токенов, чем остальные модели. 😜
Post #3393 19.7K
Gamma теперь в ChatGPT.

Теперь можно генерировать презентации прямо в чате и дальше редактировать их в Gamma.

Можно просить Gamma:

«Преврати этот техотчёт в саммари для руководства»
«Собери маркетинговый бриф для нашего продукта по кибербезопасности»
«Создай питч-дек из 4 слайдов о выезде команды на Гавайи»

Собираешь идею в ChatGPT. Презентуешь в Gamma. 🐸
Post #3392 20.3K
Держите практическое руководство по созданию обвязок для ИИ-агентов

Оно помогает понять, что превращает голую языковую модель в агента, разбирая компоненты обвязки: выполнение инструментов, память, сборку контекста, границы безопасности, планирование и мультиагентную оркестрацию.

Начинается с самых основ и 50-строчного Python-примера, который можно скопировать и запустить. Практические главы охватывают песочницы, навыки, саб-агентов, обработку ошибок и проектирование долгоиграющих обвязок. Отдельно приводится сравнение OpenClaw, Claude Code, Codex, Cline, Aider и Cursor. 🐸
GitHub GitHub - nexu-io/harness-engineering-guide: 🔧 The open guide to Harness Engineering — concepts, tutorials, papers, tools, and resources… 🔧 The open guide to Harness Engineering — concepts, tutorials, papers, tools, and resources for building and managing AI agent runtimes. - nexu-io/harness-engineering-guide
Post #3390 19.8K
Разработчик из Китая, выпустил тул, который почти автоматически собирает презентации из любых файлов.

Просто отдаёте агенту ссылку или документ и он автоматически собирает полноценные редактируемые .pptx-файлы с нативными фигурами и анимациями.

ppt-master умеет конвертировать любой документ в .pptx, поддерживает кастомные шаблоны и даже добавляет аудионарацию для заметок докладчика.

В веб-версии ChatGPT и Claude это уже есть, поэтому хорошо, что появился и CLI-вариант. В реальной практике обычно ИИ делает черновик, а человек доводит руками. Такие пайплайны будут дальше только развиваться.

100% опенсорс 😎
Post #3389 18.4K
Промпт-инжиниринг и loop engineering. Простое объяснение

По своей сути агент это цикл while:

- Модель выполняется
- Она запрашивает вызовы инструментов
- Результаты работы инструментов возвращаются в контекст
- Модель запускается снова, пока не перестанет запрашивать инструменты

Подход ReAct описал такую форму цикла ещё в 2022–2023 годах, и почти все современные агентные системы и фреймворки используют похожую реализацию.

Поэтому сами циклы это далеко не новая идея. Описанная выше реализация была решена уже давно.

Но оставался нерешённым цикл вокруг этого цикла. Именно о нём недавно говорили Борис Черни и Питер.

В наиболее распространённой схеме внешним циклом управляешь ты.

- Пишешь промпт
- Читаешь шаги, которые выполняет агент
- Пишешь следующий промпт
- Повторяешь процесс, отслеживая ошибки по мере работы

Сейчас появляются попытки автоматизировать и внешний цикл, чтобы исключить человека из процесса.

- Запуск происходит по расписанию или по событию
- Агент выполняет множество шагов без новых промптов между ними
- Сам решает, когда работа завершена
- Возвращается к человеку только тогда, когда действительно требуется его участие

Рассмотрим пример с упавшим тестом в CI.

Сейчас ты копируешь сообщение об ошибке в агента, читаешь предложенное исправление, запускаешь тесты и снова передаёшь следующую ошибку, пока все тесты не пройдут.

То есть каждый шаг проходит через тебя.

При автоматизированном цикле агент выполняет те же самые шаги самостоятельно.

Он запускается по расписанию, считывает ошибку, готовит исправление в отдельной ветке, запускает тесты и передаёт следующую ошибку самому себе как новый шаг, пока тесты не пройдут или не будет достигнут лимит шагов.

Отдельный ревьюер проверяет исправление, открывает PR, если всё в порядке, или передаёт его человеку, если обнаруживает проблемы.

Внутренний цикл всегда был автоматическим. Сейчас автоматизируют именно твоё участие в этом процессе.

Но бесплатно это не даётся.

> Пока ты управлял внешним циклом, ты мог остановить процесс, обладал памятью о проекте и выступал в роли ревьюера. Теперь все эти функции должны существовать внутри самой системы.

> И хотя участие в цикле замедляло работу, зато ты понимал, что именно происходит.

Главный недостаток исключения человека из цикла в том, что ответственность остаётся за тобой, а понимание происходящего, скорее всего, теряется.

> Сам по себе цикл не умеет определять, когда действительно пора остановиться. Он просто поверит агенту, что задача выполнена, и может завершиться даже при падающих тестах. Поэтому условие остановки должно проверяться независимо, а также необходим лимит шагов или токенов, чтобы избежать бесконечных циклов.

> Контекст увеличивается на каждом шаге, и по мере его роста качество работы модели снижается.

Поэтому цикл должен сокращать контекст, сохраняя только сводки вместо полной истории, переносить большие результаты в файлы и разбивать крупные задачи на отдельные запуски.

> Наконец, агент не должен сам проверять собственную работу, потому что он примет любое своё решение как правильное.

Такую проверку должна выполнять отдельная модель или бинарный/детерминированный тест.

Стоимость тоже быстро растёт, потому что на каждом шаге заново передаётся весь контекст. Поэтому длинный цикл может стоить во много раз дороже, чем выполнение одного промпта.

Если хочешь разобраться глубже, можно прочитать подробный разбор - от описанного выше цикла до полностью автономного запуска, который завершает работу самостоятельно, с примерами кода для каждого этапа.

Читайте дальше 🐸
Post #3388 21.7K
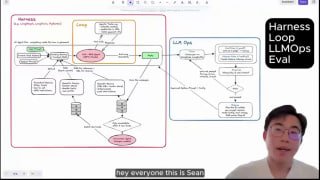
Бывший инженер Google объяснил, как работают AI agent loops, harness и evals за 20 минут.

Логика простая: трассируешь каждый запуск → прогоняешь через LLM-оценщик → находишь сбои → фиксишь → выкатываешь новую версию.

Так агенты постепенно улучшаются.

Agent loops + memory + harness + evals - базовый стек для таких систем.

Смотреть на ютуб 😜 Посмотри и сохрани этот фреймворк.
Post #3387 20.8K
Началось
Post #3384 21.9K
Нашёл отличную книгу — The Hitchhiker’s Guide to Agentic AI, которая охватывает практически весь стек Agentic AI.

Главная ценность книги - это широкий обзор всего направления: архитектура LLM, обучение моделей, методы обучения с подкреплением, системы инференса, оценка моделей, агентные системы и многое другое.
Лучше всего использовать её как карту знаний. Сначала просмотреть оглавление, найти темы, в которых есть пробелы, понять, чего ещё не хватает, а затем углубиться в соответствующие главы. Такой подход помогает выстроить системное понимание Agentic AI.

🐸🐸🐸
Post #3383 18.1K
Если используете LLM-as-a-Judge для оценки моделей, стоит обратить внимание на эту работу.

В статье представлен метод BINEVAL, который разбивает каждый критерий оценки на набор простых вопросов с ответами «да» или «нет». Каждый вопрос оценивается независимо, после чего результаты объединяются в многомерную итоговую оценку.

Такой подход позволяет увидеть, почему модель получила низкий балл по конкретному критерию, а сами ответы можно использовать для точечной доработки промптов.
Авторы сообщают, что на бенчмарках SummEval, Topical-Chat и QAGS метод без дополнительного обучения показывает результаты на уровне или выше UniEval и G-Eval, особенно при проверке фактической достоверности.

Статья: https://arxiv.org/abs/2606.27226 🐸
Post #3382 17.9K
Разработчик, гений и филантроп, представил экспериментальный проект LoginWithChatGPT.

Он позволяет пользователям входить в сторонние сайты через свой аккаунт ChatGPT и использовать его возможности без необходимости оплачивать API OpenAI владельцу сервиса.

Все по-разному восприняли идею. Некоторые вспомнили, что несколько месяцев назад обсуждалась возможность использовать подписку ChatGPT как источник токенов для сторонних приложений. Другие усомнились, соответствует ли такой подход условиям использования OpenAI.

По словам автора, OpenAI уже позволяет сторонним приложениям (например OpenClaw/Hermes) получать доступ к Codex через CLI. Он с помощью реверс-инжиниринга реализовал аналогичный механизм через OAuth для веба и мобильных приложений. При этом разраб отметил, что пока не уверен, соответствует ли решение правилам OpenAI, и ждёт официального ответа компании, прежде чем открывать исходный код проекта.

Демо проекта 🤔
Post #3381 19.3K
Проект OpenHuman менее чем за месяц набрал более 33 тысяч звёзд на GitHub. Одной из главных причин такого роста стала новая функция Super Context 🐸

При открытии нового чата OpenHuman сначала собирает контекст: анализирует релевантную информацию о пользователе, текущем экране и выполняемой работе. Благодаря этому уже первый ответ строится так, будто диалог длится уже несколько сообщений.

OpenHuman это ИИ-ассистент с открытым исходным кодом, который работает на уровне операционной системы и интегрируется со 118 приложениями. По словам разработчиков, он использует локальные данные пользователя и со временем всё лучше адаптируется к его стилю работы

Проект работает локально, поэтому данные не покидают устройство пользователя.

В течение десяти дней подряд OpenHuman входил в число самых популярных репозиториев GitHub, а сейчас занимает первое место в рейтинге платформы.

http://github.com/tinyhumansai/OpenHuman
Post #3380 16.5K
DeepSeek представила DSpark — новый метод спекулятивного декодирования для DeepSeek V4 Flash и DeepSeek V4 Pro, который увеличивает пропускную способность инференса на 51–400%.

По данным разработчиков, DSpark хорошо работает не только с моделями DeepSeek, но и с другими открытыми LLM, включая Gemma и Qwen.

Вместе с анонсом компания открыла исходный код проекта, опубликовала научную статью с описанием метода и выложила готовую модель на Hugging Face.
Post #3379 19.4K
NVIDIA открыла исходный код модели визуальной локализации LocateAnything-3B.

Модель умеет находить объекты даже в очень плотных сценах. Например, на изображении с десятками миньонов, стоящих вплотную друг к другу, она корректно выделяет каждого отдельной рамкой.

Главное отличие от большинства существующих моделей - это способ генерации ограничивающих рамок. Обычно координаты (x1, y1, x2, y2) предсказываются последовательно, цифра за цифрой. Это замедляет работу, а ошибки на ранних этапах могут влиять на последующие координаты, особенно если объектов много.

В LocateAnything-3B используется параллельное декодирование, тоесть модель сразу предсказывает готовые рамки целиком, а не строит их поэтапно. За счёт этого детекция становится стабильнее, особенно в сценах с большим количеством объектов.
Для обучения использовались не только классические датасеты для распознавания объектов, но и данные для распознавания интерфейсов, OCR и анализа структуры документов. Поэтому модель умеет находить как реальные объекты, так и элементы пользовательского интерфейса и текстовые области.

Модель содержит 3 млрд параметров и распространяется с открытым исходным кодом. 💜
Post #3378 18.9K
Вайбкодинг. День 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →