TGViewer
Channel Public Channel
VF | Science

VF | Science

@vf_science

Генерацией музыки и всем, что связано с аудио ML я занимаюсь, а всем остальным ML интересуюсь)

Делюсь знаниями, мыслями, событиями по своей карье, делаю анонсы своих онлайн/офлайн мероприятий.

Автор: @varfolomeefff
Subscribers
1.13K
Photos
225
Videos
23
Links
92

Showing posts older than #397 · Back to latest

Older Posts 13 shown
Post #396 1.45K
эйай фор сайенс Про учебники (very hard) The Principles of Deep Learning Theory (2022, 385 цит., 449 стр.) Последнее время я писал про простые учебники для начинающих и очень ориентированные на практику. Возможно у кого то возник вопрос, а есть ли что-то невероятно сложное?…
Кстати, подробнее изучил канал, интересное чтиво, но подписчиков как-то маловато) Хочу поддержать автора, советую тоже обратить внимание на посты. Подойдет начинающим и экспертам.

Там много обзоров с рефернсами и разным уровнем сложности. Например [1], [2], [3].

Но преимущественно посты про действительно тонкие темы, типа DL для химии, физики, сейсмологии, диффуров. В общем всё что не является LLM-мейнстромом, но возможно станет широко распространено в будущем.
Telegram эйай фор сайенс AI для естественных наук и инженерии: от основ DL до Geometric GNN и последних работ в области. В ближайшее время будет много про химию.
  • 👍 8
  • ❤ 1
Post #395 1.18K
Наконец то я пришел сюда. Встречай, круглый тензор.

🔣 IT Purple Conf в сколтехе
  • ❤‍🔥 12
  • 👍 7
  • 🔥 3
  • ⚡ 1
Post #394 1.11K

Forwarded from эйай фор сайенс

Про учебники (very hard)
The Principles of Deep Learning Theory (2022, 385 цит., 449 стр.)


Последнее время я писал про простые учебники для начинающих и очень ориентированные на практику. Возможно у кого то возник вопрос, а есть ли что-то невероятно сложное? Например, про современную математическую теорию DL, за 40-60 лет с доказательства универсальной теоремы аппроксимации вероятно уже что-то ещё придумали?

Вот такой учебник. Внутри Neural Tangent Kernel, основы теории информации для DL, теоремы про residul block (соединения вида x = x + f(x)), одна из теорий инициализации весов, нейронные сети с точки зрения термодинамики и ещё много очень странных вешей.

Рекомендую читать, только если вам этот мир абсолютно понятен и вы ищете покоя, умиротворения, гармонии от слияния с бесконечно вечным.

#dl #textbook #theory
  • 🔥 3
  • ❤ 2
  • ✍ 1
  • 😨 1
Post #392 1.11K
Делаем ресерч в прекрасный пятничный вечер
  • 🔥 11
  • 🏆 6
  • 🍾 4
  • 🤗 1
  • 💅 1
Post #391 1.11K
👀 CLaMP 3: Universal Music Information Retrieval Across Unaligned Modalities and Unseen Languages
[paper] | [code] | [hf_demo]

Подгончик для яндекс музыки :) Интересно, как там устроен MIR (Music Information Retrieval).

Здесь мультимодальный и мультиязычный (100 языков) поиск музыки. Все как обычно, 3 энкодера и контрастив лосс. Для текста XLM-R-base (ну и динозавр), для нот M3, для аудио MERT. Стоит выделить разве что стратегию обучения вдохновленную ImageBind:
*️⃣ Текстовый энкодер выравнивается с одним музыкальным энкодером (например, символическим)
*️⃣ Текстовый энкодер замораживается, и выравнивается второй музыкальный энкодер (например, аудио)
*️⃣ Текстовый энкодер размораживается для уточнения выравнивания со вторым энкодером
*️⃣ Текстовый энкодер снова замораживается для повторного выравнивания с первым энкодером

Однако для меня в таких штуках важнее датасет. Сделали датасет M4-RAG с 2.31 миллиона пар музыка-текст. Собрали через RAG на основе названий произведений и имен исполнителей выполнялся поиск в Google (топ-10 результатов), затем LLM (Qwen2.5-72B) генерировала аннотации: жанры, теги, фоновую информацию, описания. Состоит из 0.58 млн пар ABC-текст, 0.17 млн пар MIDI-текст, 1.56 млн пар аудио-текст. Охватывает 27 языков и 194 страны. Метаданные включают короткие теги и длинные описания, переведенные на случайные языки для увеличения многоязычности.

Ребята еще свой бенчмарк WikiMT-X выпустили из 1000 триплетов (ноты, аудио, текст). По сути просто улучшили WikiMT с помощью LLM (llama-3.1) и ручной проверки соответствия аудио. Ну, и это первый датасет, объединяющий три модальности с разнообразными семантическими аспектами.

А еще я чет не заметил моего любимого VQ-VAE, хотя ладно, он использовался при обучении их аудио энкодера.

#music #papers #datasets
  • 👍 7
  • 🔥 4
  • ❤ 1
  • 💩 1
  • 🆒 1
Post #389 13.3K
👀 DiffRhythm: Blazingly Fast and Embarrassingly Simple End-to-End Full Length Song Generation with Latent Diffusion
[paper] | [code] | [hf_demo]

Опенсурс для генерации музыки развивается 👍

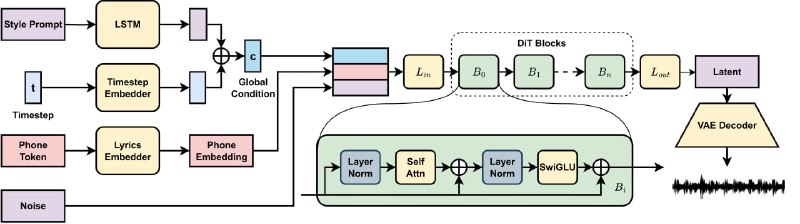
Теперь, в отличие от YuE у нас первая модель для генерации полного трека на латентной диффузии — DiffRhythm. Можно генерить треки длительностью до 4 минут 45 секунд с вокалом и аккомпанементом значительно быстрее всяких авторегрессионок, очевидно) Также можно указать тайминги для лирики, крутая фича. Модель основана на двух последовательно обученных компонентах: VAE и DiT (рис. 1).

VAE основан на Stable Audio 2 и отличается полностью сверточной архитектурой, чтобы обрабатывать аудио произвольной длины. Учится на реконструкцию качественных треков и для лучшей устойчивости делают аугментацию имитирующую MP3-сжатие. Входные данные случайно сжимаются с переменным битрейтом, а на выходе мы также хотим качественное аудио. Также накинули 2 лосса: multi-resolution STFT и adversarial, дискриминатор сделали в 4 раза больше, чем в Stable Audio, чтобы моделька видела больше деталей и реконструкция была лучше.

DiT в DiffRhythm отвечает за генерацию латентных представлений и адаптирован для работы с длинными музыкальными последовательностями. Принимает 3 кондишна:
*️⃣ Стиль. Короткий аудиофрагмент обрабатывается через LSTM, где финальное скрытое состояние используется как глобальная информация о стиле.
*️⃣ Временной шаг. Embedding текущего шага диффузии суммируется со стилевым признаком, формируя глобальное условие.
*️⃣ Текст песни. Преобразуется в фонемы через grapheme-to-phoneme (G2P) конверсию, затем встраивается в непрерывные эмбеддинги через слой embedding. Эти признаки конкатенируются с зашумлённым латентным представлением и подаются в DiT.

DiT состоит из 16 слоёв декодера LLaMA с 2048-мерным скрытым размером и 32 головами внимания (64 измерения на голову), что составляет 1.1 миллиарда параметров. Для оптимизации используются FlashAttention2, дабы ускорить вычисления внимания для длинных последовательностях и gradient checkpointing, дабы снизить потребление памяти при обучении. Также применяется 20% dropout к стилю и тексту для поддержки classifier-free guidance (CFG) с масштабом 4 на инференсе. Учится это все дело с conditional flow matching, где моделька учится преобразовывать шум в данные через ODE. Музыка генерится за 32 шага с Euler ODE солвером и на протяжении всего трека музыка остается цельной, то есть мы получаем не набор случайных звуков))

Но, пожалуй, самое главное в этой работе — это алаймент текста и латентных представлений. Вокальные сегменты часто прерываются длительными инструментальными частями, что создаёт разрывы в временной последовательности. Также одни и те же слова могут звучать по-разному из-за различного аккомпанемента, что усложняет выравнивание. Авторы сказали, что всякий кросс-аттеншн или прямая конкатенация фичей не позволяют генерить разборчивые песни. Поэтому авторы предлагают выравнивание на уровне предложений, требующее только аннотаций начала предложений t_i_start (рис. 2) и делают его так:
*️⃣ Преобразуют текст в последовательность фонем через G2P преобразование
*️⃣ Инициализуют последовательность для алаймента P_i длиной L_max (4м45с), которая полностью заполнена падингами
*️⃣ Размещение фонем p_i в P_i на позициях, соответствующих временным меткам (𝑓_𝑖_start=[𝑡_𝑖_start * 𝐹_𝑠], где 𝐹_𝑠=21.5Гц)

Такой алаймент уменьшает потребность в детальных аннотациях, расходы на подготовку датасета и разборчивость вокала становится лучше. Бьютифул.

А теперь мои мысли: делать ллама подобные сетки с кучей аудио токенов, каким то ризонингом на лирику здорово, но можно делать как DiffRhythm. Авторегрессия, к слову, хороша тем, что с ней можно учить все, этот подход универсален. Foundation моделей на диффузии я пока не видел (upd: видел). Ну и наверное авторегрессия хорошая для бизнеса, который может дать деняк, взять авторегрессию и поскейлить модельки, чтобы решить большинство возникающих задач. Что думаете?

#music #papers
  • ❤ 12
  • 👍 2
  • 🎉 2
  • 💩 1
Post #386 970

Forwarded from VF | Meetups

А сейчас будет прямо особенный анонс. Я конечно вряд ли попаду туда, но ооочень постараюсь.

Eastern European Machine Learning Summer School | 21-26 July 2025, Sarajevo, Bosnia and Herzegovina

Летная ML школа от крутейших ребят из гугла, кэмбриджа, оксфорда и тд... У некоторых ребят научруки с хиршем >230. Я посмотрел научруков каждого и научруков их научруков)) Ну вот так интересно было.

Дедлайн подачи заявки - 31 марта включительно

Чтобы туда попасть нужно, конечно, написать интересное мотивационное письмо, а также расписать свои ресерч интересы. Затем самое главное, нужно определить ваши навыки ресерча. Можно выбрать 3 пути:
*️⃣ Написать 3 разбора статьей с топовых конференций
*️⃣ Поделиться опытом своих проектов/исследований, написать мини-статью на 2 страницы
*️⃣Поделиться опытом решения сорев на kaggle
*️⃣Воспроизвести результаты статей с топовых конференций

Не знаю, какая там конкуренция и насколько отличаются студенты за рубежом, но податься попробую. Получается (надеюсь) меня оценят чуваки из гугла и тд, это полезно.
  • ❤‍🔥 11
  • ⚡ 2
  • 💅 2
  • 🔥 1
Post #382 850
кажется, я нашел себе научрука
  • 😁 13
Post #381 980
Ситуация у меня следующая: до дедлайна подачи статьи про векторное квантование на NIPS осталось два месяца. Эксперименты ещё не начаты, есть четыре разные постановки задачи. Статья, конечно, пишется сильно заранее, до того как появятся результаты экспериментов. Сейчас такой период, когда я круглые сутки работаю над статьей. Надо ускориться с её оформлением и кодом для экспериментов, а потом получить доступ к вычислительным мощностям — возможности для этого есть. В статье я уверен. У меня даже есть один конкурент с препринтом на arXiv, где описана похожая работа, но различий между нашими подходами достаточно. Они тоже будут подаваться на NIPS, это точно. Короче, моя проблематика уже не такая уникальная, но это лишь означает, что я выбрал хорошую тему и могу быть увереннее в эффективности своих идей.

Прошло шесть месяцев с того момента, как я начал активно ресерчить. Пишу статью впервые, в одиночку, не умея поначалу расставлять приоритеты, оценивать гипотезы и задавать правильные вопросы. Все эти проблемы я постепенно решил, почти полностью. Очень хочется поделиться идеей и опытом написания статьи, но это будет не раньше чем через три-четыре месяца. Было бы значительно легче, если бы исследования были моей основной работой — надо этим заняться. Мне нравится заниматься ресерчем, но также хочется активно внедрять их в бизнес и улучшать продукты. Мой исследовательский интерес возник из задачи audio2midi. Параллельно я активно обучаю новую нейросеть для @Audio2MIDIBot. Главное применение моего исследования будет именно в этом боте. Он призван решить проблему повторяющихся нот в музыке, где вокал и аккомпанемент звучат в одной тональности, монотонно или имеют совсем небольшие изменения, которые нейронной сети сложнее уловить. Например, такой жанр музыки, как фонк, часто хорошо переводится в MIDI: там есть чёткие и частые переходы, перепады громкости, смена инструментов и всё такое.
Telegram VF | Science 👀 Vector Quantized Variational Autoencoder — My Review Автор уже давно фокусируется на теме векторного квантования и даже начинает свой ресерч, который, возможно, значительно улучшит все модели связанные с VQ-VAE :) Пока что за 2 месяца не успел разочароваться…
  • ❤ 9
  • 🔥 5
  • 🆒 2
  • ⚡ 1
Post #378 894

Forwarded from Sinекура

Вчера читал лекции про SVM да RVM, и вот видео уже выложено, да и все материалы на странице курса доступны как обычно.

Что мне всегда нравилось в околоматематических науках, в том числе и в машинном обучении, — это то, что как бы быстро ни двигался прогресс, всё равно основные идеи сохраняются, не устаревают и время от времени возникают в самых разных местах.

В этих лекциях вот рассказывал про SVM и kernel trick. Казалось бы, кому в эпоху нейросетей захочется самому придумывать ядра для нелинейной классификации и применять kernel trick — сеть же сама выучит нужное нелинейное преобразование. И действительно, может выучить, и базовые SVM сейчас редко встретишь в живой природе — но трюк отнюдь не умер! Это математическая идея, и она вовсе не об SVM, а о том, что скалярные произведения в пространствах признаков высокой размерности φ(x) эквивалентны нелинейным функциям от исходных векторов малой размерности x.

Так что когда в трансформерах понадобилось решать проблему квадратичной сложности, одним из подходов стал как раз kernel trick, только наоборот: если перейти от softmax(q⋅k)⋅v в пространство признаков, где softmax будет линейным, φ(q)⋅φ(k) (приближённо, разумеется), то можно будет переставить скобочки и матрицу квадратичной от длины входа сложности не считать. Эта идея называется сейчас linear attention, и я об этом недавно подробно писал в посте про линейное внимание и Mamba.

Это хороший пример к извечной морали любого образовательного процесса: изучать надо не рецепты, не конкретные модели и решения, а идеи, которые лежат в их основе. Модели устареют, рецепты заменятся на другие, — а идеи вечны.

https://www.youtube.com/watch?v=tHjg8mH0VSM
YouTube СПбГУ -- 2025.02.18 -- SVM, kernel trick, ядерные методы, метод релевантных векторов Это лекция из курса "Графические вероятностные модели", который читается на Факультете математики и компьютерных наук СПбГУ вместе с двумя другими частями курса машинного обучения -- "Основами байесовского вывода" и "Глубоким обучением". Все материалы этой…
  • 💯 7
  • 👍 4
  • ❤ 2
Post #373 1.14K
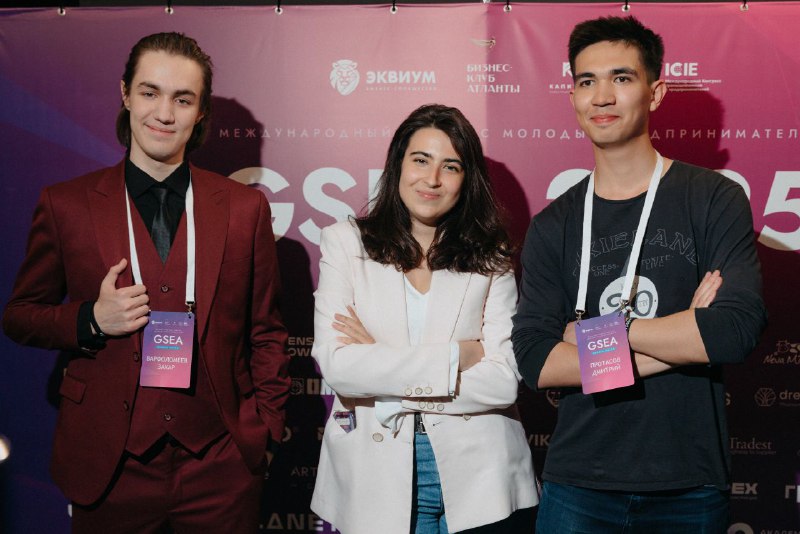
👀 Посетил финал конкурса предпринимателей GSEA 2025

За пару дней до мероприятия узнал от нашего замечательного PM, что наша команда Audio2MIDI зарегистрирована на конкурс. Смотрю такой, что там будет, вижу Оскар Хартман придет (долларовый миллиардер) и другие серьезные люди. Стало интересно узнать, как на таких мероприятиях дела делаются, ибо я был только на айтишных и научных сходках. Спойлер: финал мы увы не выиграли, все впереди.

Какие выводы сделал:
*️⃣На такие мероприятия люди идут с конкретными целями и знают, что и кому говорить.
*️⃣ Честно, порой я смотрел на продукты, которые развивают люди и удивлялся, что в этом можно создать потребность и найти свою аудиторию. Порой нужно быть увереннее у своих продуктах и создавать в них потребность, не только искать ее.
*️⃣Люди активно знакомятся и обмениваются опытом, каждый человек инициативный. Мне было тяжело знакомиться первым и направлять диалог, но под конец стало хорошо получаться.
*️⃣Новых контактов после таких мероприятий много, лучше сразу писать напоминалку о вашем последнем разговоре.
*️⃣Кто успел, тот и съел. Нужно не упускать возможности, в том числе возможность познакомиться с человеком за соседним столиком :) Я стеснялся, но решился познакомиться, получил весьма полезное знакомство!
*️⃣Нужно рисковать, но с умом. В том числе нужно правильно выбирать с кем сотрудничать, как сотрудничать, сколько сотрудничать. Время это деньги )) Заезженная фраза.

Выводов и новых знаний сильно больше. Было много докладов и нетворка, мероприятие длилось 13 часов! Есть запись: https://gsea.ru/

Я познакомился с основателями компаний, бизнес трекерами, инвесторами... Впечатлений много и такая смена обстановки, окружения и целей создали неопределенность в голове. Ибо я в основном инженер и будущий ученый, я так думал...
  • ❤ 18
  • 🔥 9
  • 👍 7
  • 💩 3
  • 👎 1
Post #372 855
А вообще, знаете к чему идут посты про VQ-VAE? К полному отказу от использования VQ-VAE))) Думаю все, кто имел дело с ним понимают, что раньше либо не было альтернатив и приходилось мучиться, либо учили на патчах, либо думали, что авторергессия для генерации изображений/аудио это скам. Но с другой стороны, есть задачи кроме генерации картинок и аудио, там все чуток иначе. Скоро мы дойдем до самых интересных работ и до мего неинтересного ресерча, обсудим все это 😆
  • 👍 7
  • 😭 3
Post #368 971
👀 Image Understanding Makes for A Good Tokenizer for Image Generation
[paper] | [code] | NIPS 2024

Вот есть Image Generation (IG) и Image Understanding (IU) модели (рис. 1). IG модели помогают IU моделям, путем генерации синтетических данных, улучшения representation learning'а, добавления промежуточных фичей из IG моделей для perception задач. А что IU модели могут сделать для IG моделей?) Спойлер: качество генерации лучше, если считать лосс реконструкции не по пикселям, а по feature maps из предобученного энкодера, учитывающего семантическую информацию изображений.

Авторы также обнаружили, что токенайзеры с более слабыми возможностями IU требуют более крупных авторегрессионок и демонстрируют меньшую устойчивость к изменениям в обучающих изображениях.

Мы, конечно, будем снова обсуждать модели с VQ-VAE, а вы что подумали) Авторегрессионная генерация изображений на VQ токенах делается в 2 этапа (рис. 2). Сначала обучают VQ-VAE на реконструкцию, потом заменяют CNN декодер на какой-нибудь трансформер и учатся генерировать изображения, используя предобученный кодбук.

Пока мы учим модель реконструкции, мы по сути учим модель запоминать детальное расположение пикселей, то есть модель не видит никакой семантики в данных. Авторы предложили исправить это и составлять кодбук, учитывающий семантику изображений.

Чтобы учитывать семантику изображений, логично использовать предобученные энкодеры, например CLIP. Теперь модель обучается реконструировать feature maps из предобученного энкодера (учителя) (рис. 3). Подход называется VQ-KD и он не новый. Это просто дистилляция знаний от предварительно обученных IU-энкодеров к токенайзерам. Может показаться, что можно просто заменить энкодер перед векторным квантованием, но это другое. Здесь декодер D(C(z)) учится минимизировать косинусное расстояние до feature maps учителя x^t. C(z) это векторное квантование.
L_rec = − cos(D(C(z)), x^t)


В контексте генерации изображений авторы исследуют четыре IU-энкодера: ViT, CLIP, DINO и MAE. Как итог: метрики значительно растут на разных датасетах и декодерах, кодбук используется под 100%, ведь авторы знают про FSQ и CVQ-VAE, все хорошо.

Только вот я не понял уникальности работы, многое основано на статье про BEIT V2. Однако ревьюеры на NIPS 2024 даже 4/5 ставили. Статья написана просто отлично, но все же.

#papers #vqvae #images
  • ❤ 4
  • 👍 4
  • 🤔 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →