TGViewer
Channel Public Channel
VF | Science

VF | Science

@vf_science

Генерацией музыки и всем, что связано с аудио ML я занимаюсь, а всем остальным ML интересуюсь)

Делюсь знаниями, мыслями, событиями по своей карье, делаю анонсы своих онлайн/офлайн мероприятий.

Автор: @varfolomeefff
Subscribers
1.13K
Photos
225
Videos
23
Links
92

Showing posts older than #368 · Back to latest

Older Posts 13 shown
Post #367 880
  • 😁 26
  • 🔥 2
  • 👍 1
  • 🌚 1
Post #366 1.16K
Пошлите послушаем как школьники в 15 лет пишут папиры на A ранговые конфы, а именно моего хорошего друга Дениса. Мы проводим постерную сессию онлайн. Денис создал лучший расстановщик ударений для ruTTS.

https://t.me/den4ikresearch
Telegram Den4ik Research HuggingFace: https://huggingface.co/Den4ikAI GitHub: https://github.com/Den4ikAI Донат: https://pay.cloudtips.ru/p/b9d86686 Личка: https://t.me/bceloss Канал одного Audio-ресерчера
  • 👍 7
  • ❤ 1
Post #365 4.04K
Ого, нормальный опенсурс добрался до домена музыки! Авторегрессионка генерирует вокал и аккомпанемент. Ждите обзор, это весьма значимое событие! (да блин, когда вы уже статью выложите)

https://huggingface.co/m-a-p/YuE-s1-7B-anneal-zh-cot
  • 👍 12
  • ❤ 3
  • ❤‍🔥 3
  • 🍓 1
Post #364 1.15K
Как вам такой лосс? 😆
Встречайте современные аудио кодеки/ттски.

P. S. вот [статья]
  • ✍ 6
  • 🫡 4
  • 👀 2
  • 🤨 1
Post #362 1.22K
👀 Снова посетил семинар в AIRI

Хожу без пропусков, вот бы также в вуз ходил :) Сегодня обсуждали безградиентную оптимизацию и спайковые нейронки. Было очень интересно, да и мой любимый VQVAE упомянули. Особенно отметил для себя information bottleneck method.

Information Bottleneck Method — это подход из области теории информации, который используется для выделения и сохранения наиболее релевантной информации из одного сигнала ( X ), которая важна для предсказания другого сигнала ( Y ). Основная идея метода заключается в том, чтобы "сжать" информацию в ( X ), сохраняя только ту её часть, которая полезна для понимания или предсказания ( Y ).


Например, в задаче классификации изображений мы изучаем латентное пространство, учитывающее множество положений пикселей, цветов, текстур и тд. Все это учить нам не нужно, давайте выкинем всю лишнюю информацию и оставим гораздо более простое латентное пространство, позволяющее решить задачу классификации.

Это направление можно хорошо адаптировать для теоретической основы глубокого обучения в общем. Все это я говорю, потому что интересно + для затравочки перед своим ресерчем VQVAE, потому что я делаю весьма похожую штуку... Пока не сделаю, это будет тайной))
  • 👍 17
  • ❤ 3
  • ❤‍🔥 2
  • ✍ 1
Post #360 1.08K
Эээ, вот это дела... Я юзаю токены VQ-VAE для генерации картинок, а кто то трейдит VQ-VAE токены 😆
  • 🌚 9
  • ❤ 3
  • 💋 1
  • 🗿 1
  • 💘 1
Post #357 928
👀 Scaling the Codebook Size of VQGAN to 100,000 with a Utilization Rate of 99%
[статья] | [код]

Давайте сегодня закончим тему колапса кодбука и последнее слово будет за VQGAN-LC (Large Codebook), свежая работа на NIPS 2024. Вы видите??? 100 тыщ кодбук!

Идея мне очень понравилась. Помните я говорил, что колапс кодбука происходит потому, что мы обновляем кодбук относительно последних фичермапов. Некоторые элементы кодбука могут остаться без изменений и не будут использоваться. Данное решение примечательно тем, что каждый раз обновляется весь кодбук. Теперь мы стараемся приблизить фичермапы и кодбук не по семплам, а приближаем распределение кодбука к фичермапам.

Кодбук будет фиксированным, инициализирован с помощью CLIP энкодера с ViT бекбоном. Далее делаем проекцию кодбука через линейный слой и считаем L2 между проекцией и элементами фичермапов, получаем квантованые фичермапы. Затем считаем стандартный VQ лосс, но кодбук остается фиксированным, а линейный слой для проекции кодбука и наш энкодер обучаются.

Получается, что теперь мы учитываем все элементы кодбука на каждом степе и учимся распределять фичермапы максимально эффективно вплоть до кодбука размером 100к! И до миллиона можно разогнать, если декодер будет побольше.

Но если посмотреть на результаты, то далеко не всегда размер кодбука значительно улучшает качество. Больше не всегда хорошо, здесь, конечно, об этом не написано. Ну, все же чаще масштабирование в большую сторону помогает :)

Конец, дальше будем обсуждать работы решающие другие проблемы VQ-VAE и тихонечко ждать когда я проведу свои экспы по улучшению моделек.

#papers #vqvae #images
  • 👍 7
  • 🔥 3
Post #356 731
Да, я
  • 🥴 9
  • 😁 4
Post #352 703
👀 Finite Scalar Quantization: VQ-VAE Made Simple
[статья] | [код]

Самая актуальная работа решающая колапс кодбука и очень хорошо воспроизводится, поэтому запомните FSQ. Идея простая и хорошо масштабируемая на люблю vq-vae модельку.

Берем элементы фичермапов, а теперь внимание: значение каждой размерности ограничивается пространством меньшей размерности (рис.1) по этой формуле:
Z_i → ⌊L/2⌋ tanh(Z_i)

где Z_i наши фичермапы, а L количество возможных значений для каждой размерности. Теперь у нас нет операции поиска ближайших элементов из кодбука к фичерамапам, мы просто округляем в меньшую сторону L/2 и скейлим на tanh(Z_i).

Градиент проходит через округление с помощью straight-through estimator (STE), но в 2025 я бы смотрел в сторону rotation trick. Поскольку теперь мы работаем с каждым измерением фичермапов, градиенты распространяются по множеству квантованых ячеек. Благодаря этому элементы кодбука эффективно заполняют латентное пространство и у нас используются ВСЕ элементы кодбука. Бьютифул.

Говоря в принципе, до каких масштабов скейлится этот метод не знаю, но в общепринятых масштабах кодбука, а это до 2^16 ситуация удовлетворительная (рис. 2, экспы на imagenet).

Я также отмечу факт, что статья написана очень хорошо, она легко читается и идея простая, масштабируемая, код легко запускается. А зачем делать ресерч, который не масштабируется и на заводится? Давайте вспомним горький урок от Ричарда Саттона :)

#papers #vqvae #images
  • 🔥 8
  • 👍 2
  • 🥴 1
Post #348 812
VF | Science 👀 Robust Training of Vector Quantized Bottleneck Models Сейчас обсудим работу, дающую полезную интуицию про обучение VQ-VAE. Предыдущий пост был про основные проблемы, а этот будет про их решения. Больше всего внимания было уделено "коллапсу кодбука" [1]…
👀 SQ-VAE: Variational Bayes on Discrete Representation with Self-annealed Stochastic Quantization
[Статья] | [Код]

Напомню, насколько важен VQ-VAE и продолжу делать заметки про коллапс кодбука. Явление, при котором модель использует лишь небольшую часть доступных кодов, что ограничивает её способность эффективно обрабатывать данные. Сегодня обсудим SQ-VAE, частично решающий колапс кодбука. SQ-VAE обучается генерации без вспомогательных лоссов для кодбука и энкодера, то есть градиент без проблем проходит через операцию векторного квантования.

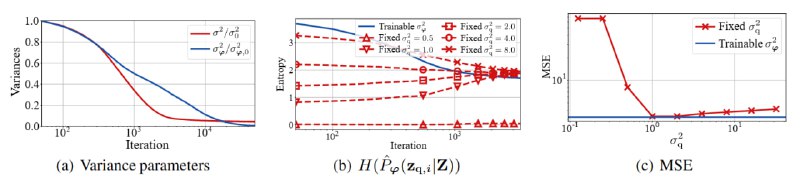
Авторы решили вернуться к истокам, точнее к VAE, и сделали процесс квантования стохастическим. Фичермапы семплируются из непрерывного распределения с обучаемыми параметрами, например из Гауссова (рис. 1). Теперь, как в VAE, мы оптимизируем ELBO и можем применить reparametrization trick, так операция семплирования не остановит градиент.

При этом под конец обучения стохастичность приближается к нулю и мы возвращаемся к детерминированному векторному квантованию. Это явление авторы назвали self-annealing (рис. 2, эксперимент на mnist). Довольно удобный результат, на инференсе не будет семплирования и мы вернемся к классическому VQ-VAE. Такой сценарий наблюдается если распределение данных непрерывное.

Что если распределение данных дискретное? Интуитивный способ адаптации SQ-VAE для категориального распределения данных — смоделировать выходных данные декодера в виде категориального распределения. Но при таком сценарии self-annealing не наблюдается. Чтобы исправить это авторы используют von Mises-Fisher distribution для стохастического векторного квантования. Истинная причина проблемы лежит в исчезновении дисперсии в лоссе после замены непрерывного распределения на дискретное (см. статью в 3.4).

Метрики по картиночным и аудио задачам на рис. 3 и работа с 2022, поэтому посмотрите цитирования.

#papers #vqvae #images #audio
  • ❤ 7
  • 👍 1
  • 🤔 1
Post #347 1.04K
Продолжайте следить за каналом, потому что цели на 2025:
✔️ Понять какие цели и пути мне реально важны))
*️⃣Научиться грамотно распределять время и свои ресурсы
*️⃣Расширять свои знания и навыки за пределы аудио ML
*️⃣Сделать 100+ классных постов и стримов по разным доменам ML
✔️ Пройти отбор на лето с AIRI
*️⃣Написать свою научную статью на A/A* конфу
*️⃣Улучшить нейронку для Audio2MIDI до человеческого уровня распознавания нот
*️⃣Подтянуть английский до разговорного B2+ (сейчас свободно читаю статьи и смотрю видео, а говорить не могу)
✔️ Вырости до синьер грейда как ML инженер
✔️ Продолжать выступать, а может и начать организовывать конференции/митапы
✔️Помочь сотням студентов в развитии карьеры
✔️1000+ подписчиков на канале, в том числе студентов, ресерчеров, мл инженеров, лидов
  • ❤‍🔥 13
  • ❤ 3
  • ⚡ 2
Post #337 909
2024 в картинках! Смотрите пост с текстом выше 👆
  • ❤ 8
  • 😎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →