TGViewer
Channel Public Channel
Den4ik Research

Den4ik Research

@den4ikresearch

HuggingFace: https://huggingface.co/Den4ikAI
GitHub: https://github.com/Den4ikAI
Донат: https://pay.cloudtips.ru/p/b9d86686
Личка: https://t.me/bceloss

Канал одного Audio-ресерчера
Subscribers
1.79K
Photos
61
Videos
3
Links
44
Recent Posts 10 shown
Post #126 1.79K
В копилку CPU синтезов
  • ❤ 3
Post #125 1.56K
Post #124 2.39K

Forwarded from Voice stuff

🎉 Подготовили статью "Dialogs: a studio-quality expressive conversational Russian speech corpus for dialog assistants", с Ильёй Латышевым, которую приняли на Interspeech 2026

Слова Ильи:

Это был мой первый подобный опыт, и теперь я могу с уверенностью сказать: если кажется, что всё, что может пойти не по плану, обязательно пойдёт не по плану — скорее всего, так и будет 😄 Переносы записей, сорванные дедлайны, организационные сложности, постоянные мелкие проблемы, которые по отдельности кажутся незначительными, но вместе сильно тормозят работу. В какой-то момент начинает казаться, что проект уже никогда не закончится. Но в итоге всё получилось, и я очень рад, что мы довели его до конца.

За время работы я понял, насколько много мелочей влияют на качество речевого корпуса.

Например:
• желательно использовать одинаковые микрофоны и одинаковую аудиоцепочку для всех дикторов;
• одинаковое расстояние до микрофонов;
• необходимо контролировать уровень фонового шума и акустику помещения;
• важно не менять настройки записи между сессиями;
• стоит заранее продумать организацию записи, потому что именно она часто становится источником самых неожиданных проблем.


Одной из особенностей нашего корпуса стали условия записи диалогов. Два актёра театра сидели напротив друг друга и читали реплики, видя мимику, жесты и эмоциональную реакцию собеседника. Несмотря на то что текст был заранее подготовлен, такое взаимодействие делало реплики значительно более естественными и выразительными. Это заметно отличается от записи, когда каждый диктор работает в одиночку и произносит свои реплики изолированно.

В результате получился открытый студийный корпус выразительной русской разговорной речи:

• 20 часов записей;
• 3 профессиональных диктора — актёра театра;
• широкий набор эмоций и разговорных стилей;
• открытая лицензия для исследований.

Корпус в первую очередь предназначен для файнтюна моделей синтеза речи. В статье мы также показываем результаты обучения моделей и субъективную оценку качества (MOS) для различных разговорных стилей.

📄 Статья на arxiv: https://arxiv.org/abs/2607.14310

📄Статья на hf: https://huggingface.co/papers/2607.14310

🤗 Датасет: https://huggingface.co/datasets/langswap/dialogs-ru-emotional-conversations

🎤 Демо: https://huggingface.co/spaces/frappuccino/dialogs-ru-tts

Спасибо Илье за работу над этим проектом - это было очень непросто и ресурсозатратно и я очень хочу чтобы результаты нашей работы приносили пользу таким же исследователям речевых технологий как мы.

Подписывайтесь на канал Ильи, он делает крутые обзоры там! @decent_researcher

И на этот канал, @voicestuff
arXiv.org Dialogs: a studio-quality expressive conversational Russian speech... We introduce Dialogs, a studio-quality Russian conversational speech corpus for dialog assistants. The dataset contains 20.6 hours of face-to-face acted dialogs recorded in a professional studio...
  • 🔥 30
  • ❤ 3
Post #122 5.26K

Forwarded from Разработки Теры

Всем привет ребятки, выложил тут датасет с ютуба, сделан через пайплайн FireRed Vad -> двойной гигаам с мерджингом (пунктуация из е2е и текст из обычной) -> алайн через квен алайн -> отчистка через clearer voice

Данные в формате опус, 48khz, mono, один спикер, у каждого опус файла есть txt файл с текстом аудио, в метадате данные в формате путь||текст(с ударениями)||время аудио в секундах

https://huggingface.co/datasets/TeraTTS/betterset
  • ❤ 39
Post #120 8.35K

Forwarded from VF | Science

Колаб для семинара, в котором мы обучим поверх кодов Mimi кодека классификатор голосов на мужской и женский 😄

Используем 8 кодбуков, обучаем 8 трансформер-энкодеров, делаем темпоральный пулинг по токенам, а затем атеншн пулинг между энкодерами. Потом обычный классификатор. Из прикольного - визуализация атеншна на разные уровни RVQ.

Научились работать с RVQ и в качестве упражнения можете посчитать разные статистики для кодовых книг, например perpexity (покажет насколько равномерно используются коды) или утилизацию кодов на разных уровнях/на первом. Или попробовать другую простенькую задачу и посмотреть как интерпретируются уровни RVQ, вероятно на разных уровнях содержится разная семантика/смысл.

https://colab.research.google.com/drive/1L6sTCrpdxybkSOOrc4G2E4AuRnQLWZQj#scrollTo=cHGzcgj8oRVi
Google Copy of Копия блокнота Colab notebook
  • 🔥 15
  • ❤ 5
Post #119 6.64K

Forwarded from VF | Science

👀 Про аудио кодеки в Deep Learning School

Сегодня выложили 2 части лекции и она немножко затянулась, примерно на 100 минут :)

На лекции мы обсудили основополагающую технологию VQ-VAE и дошли до современных подходов к обучению аудиокодеков. Попутно рассмотрели специфические для них проблемы и способы их решения — такие как недифференцируемость в процессе обучения, коллапс кодовой книги, неэффективное покрытие домена и недостаточная репрезентативность для последующих задач. Отметили тенденции в современных исследованиях, разобрали конкретные примеры актуальных аудиокодеков и подумали, как можно объединить существующие подходы для обучения собственного кодека, потенциально превосходящего текущие решения. В завершение поговорили о практических рекомендациях по обучению кодеков и дополнительной литературе по теме.

Лекцию сделал без глубокого погружения в конкретные работы, зато мы обсудили гораздо больше других мыслей и сохранили интуицию по самым важным идеям и проблемам VQ-VAE моделей. Хотелось сделать лецию с упором на актуальные идеи и дать ровно столько, чтобы вы могли решить, куда стоит углубиться самостоятельно, имея фундамент заложенный после просмотра. Пишите возникающие вопросы в чат курса DLS или мне @varfolomeefff

Предлагаю посмотреть и поделиться мнением под постом. Давно я длинные лекции не читал.

На днях выделю особенно интересные тезисы из лекции в канал и обсужу их. Интуиция на леции правда животрепещущая и есть, о чем поспорить/подумать.

Часть 1: https://youtu.be/4mVfb-mhv9k?si=k9Q2wgtsA1h2DcP0

Часть 2: https://youtu.be/kOS6qHc6K2g?si=Po-jHSLwpeO5LmkZ

#audio #perfomances
YouTube Лекция. Аудио кодеки. Часть 1 Занятие ведёт Захар Варфоломеев Ссылка на материалы занятия: --- Deep Learning School при ФПМИ МФТИ Каждые полгода мы запускаем новую итерацию нашего двухсеместрового практического онлайн-курса по глубокому обучению. Наборы проводятся в августе-сентябре…
  • 🔥 17
  • ❤ 8
  • 🥰 5
  • 👍 3
Post #117 56K
Наш русскоязычный датасет для TTS опубликован!

Сегодня выкладываем открытые корпуса на 4000+ часов речи, а еще синтезатор речи ESpeech-TTS-1

Наш датасет содержит больше 4000 часов русской речи. Статистика по корпусам:

Многоголосые:
ESpeech-podcasts - 3200 часов
ESpeech-webinars - 850 часов

Одноголосые:
ESpeech-igm - 220 часов
ESpeech-buldjat - 54 часа
ESpeech-upvote - 296 часов
ESpeech-tuchniyzhab - 306 часов

Данные лежат вот тут: https://huggingface.co/ESpeech

Техрепорт датасета доступен тут: https://github.com/Den4ikAI/ESpeech/blob/main/ESpeech_techreport.pdf


Также, мы решили провести некоторые эксперименты с TTS. Получилось обучить F5-TTS на 10000 часов речи и сделать одну из лучших по нашим замерам моделей в опенсурсе для русского языка.

Какие модели доступны?
ESpeech-TTS-1 [RL] V1 - Первая версия модели с RL
ESpeech-TTS-1 [RL] V2 - Вторая версия модели с RL
ESpeech-TTS-1 PODCASTER [SFT] - Модель обученная только на подкастах, лучше генерирует спонтанную речь
ESpeech-TTS-1 [SFT] 95K - чекпоинт с 95000 шагов (на нем основана RL V1)
ESpeech-TTS-1 [SFT] 265K - чекпоинт с 265000 шагов (на нем основана RL V2)

Лайкайте модель которая больше понравится чтобы мы понимали есть ли смысл запускать RL.

Послушать модели без скачивания можно вот здесь:

https://huggingface.co/spaces/Den4ikAI/ESpeech-TTS

Совместно с @speech_recognition_ru ещё сделали лидерборд русского ТТС, где можно глянуть метрики:

https://huggingface.co/spaces/ESpeech/open_tts_leaderboard_ru
Задать вопросы по поводу данных и модели можно в наших телеграм каналах:
https://t.me/den4ikresearch
https://t.me/voice_stuff_chat

Вы можете мне задонатить, чтобы у меня были ресурсы делать более крутые модели и датасеты:

USDT (TRC20): TEpEM4VVmGmqKHn4Xz1FxM7qZiXjWtUEUB
BTC: bc1qw5lq7fc455e47hggax6zp8txw4ru7yvsxvawv3
https://www.tbank.ru/cf/7WKnNMqWtOx
  • 🔥 148
  • ❤‍🔥 31
  • 👏 20
  • ❤ 13
  • 🤡 5
  • 👍 3
  • 👎 2
  • 💩 1
  • 🌚 1
Post #115 8.04K
AIRI Poster.pdf2.7 MB
Наш проект на Лето с AIRI 👾

Мы с Захаром @vf_science решили выложить постер с нашим методом, по которому, вероятно, будет наш финальный проект.

Но есть несколько дополнений, ибо места в постере мало (проговорим вживую на постерной сессии):

1. Перплексия считается по кодбуку, а не по языковой модели (И да, чем больше тем лучше)
2. MOS низкий, поскольку у нас небыло времени обучить на достаточном количестве данных, а рисерч пропозал делать надо :)
3. Планируем сэмплировть новые коды в менее плотных местах распределения + имеет смысл проводить революцию среди насэмплированных кодов


@den4ikresearch
  • ❤ 15
  • 🔥 10
  • ❤‍🔥 6
Post #105 6.14K

Forwarded from VF | Science

❤️ Секция про ML в музыке на DataFest 2025!

Посмотреть запись секции: https://vkvideo.ru/video-164555658_456241380?t=5h35m33s
Отдельно доклады будут выложены на ютубе позже.

Впервые за время существования датафеста (10 лет!) мною была собрана секция про ML в музыке и сразу 5 спикеров на 1 площадке:
▪️Максим Смоляков: "AI-Generated Music: методологии оценки качества и оптимизация генерации."
▪️Алексей Попов: "Генерация пения с помощью диффузионных трансформеров."
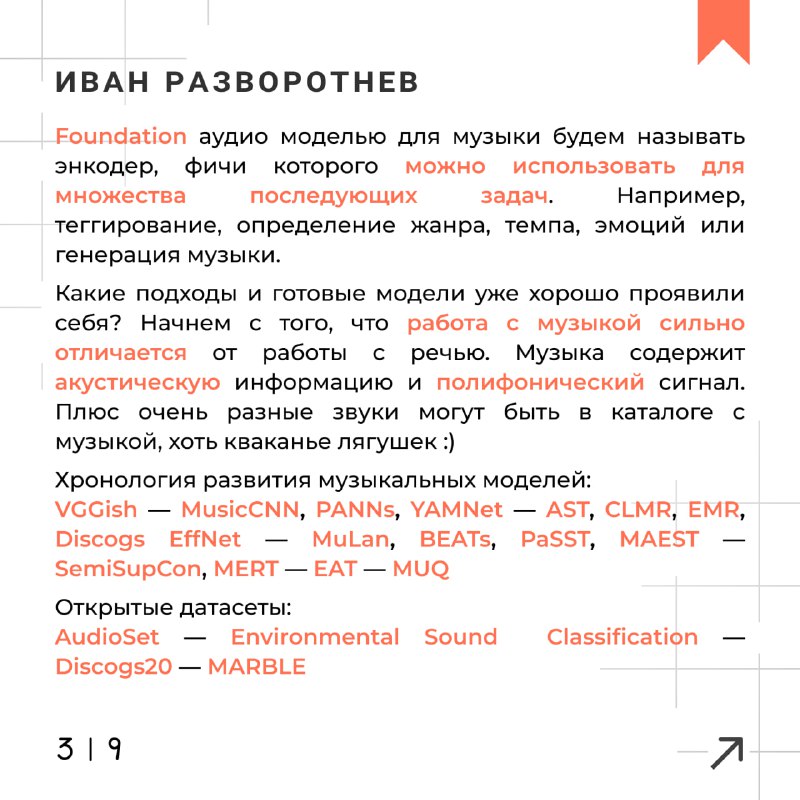
▪️Иван Разворотнев: "Foundation Audio Models For Music."
▪️Николай Глазырин: "Трейлеры в Яндекс Музыке с точки зрения ML инженера."
▪️Захар Варфоломеев (я): "Автоматическая транскрипция музыки в ноты фортепиано. Часть 2. "

На докладах мы послушали музычку и узнали множество инсайдов при работе с авторегрессией и диффузией для генерации музыки, а также обсудили задачи music information retrieval (MIR), где поговорили о foundation моделях в музыке, существующих подходах (актуальных и не очень), выделении трейлеров в музыке, исследованиях по аудио кодекам... список длинный, поэтому предлагаю почитать резюме в формате карточек!

🔤🔤На карточки про себя места не хватило, интересную мысль с моего доклада расскажу в следующем посте. Идеи применимы не только к моей задаче транскрипции музыки, а в целом к TTS/ASR моделям и не только 😬

#music #audio #perfomances
  • ❤ 12
  • 🔥 2
Older posts →

About this channel

How can I read @den4ikresearch without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Den4ik Research: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Den4ik Research have?
Den4ik Research (@den4ikresearch) has 1.79K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Den4ik Research know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →