TGViewer
Channel Public Channel
very vibe coding

very vibe coding

@veryvibecoding

Канал Алексея Макрушина об экспериментах в области vibe coding и всего интересного, что есть в области AI, ML и тому подобного
Subscribers
133
Photos
465
Videos
126
Links
1K

Showing posts older than #396 · Back to latest

Older Posts 18 shown
Post #393 39

Forwarded from Machinelearning

🧠 mem-agent — агент с памятью в стиле Obsidian

Лёгкая LLM-модель, которая умеет хранить знания в человеко-читаемой памяти (Markdown-файлы) и использовать их для ответов. Агент не просто отвечает на запросы, а действительно «помнит» факты и обновляет их по ходу работы.

Это агент на 4B с локальной, совместимой памятью для Claude, ChatGPT и LM Studio.

Как работает память:
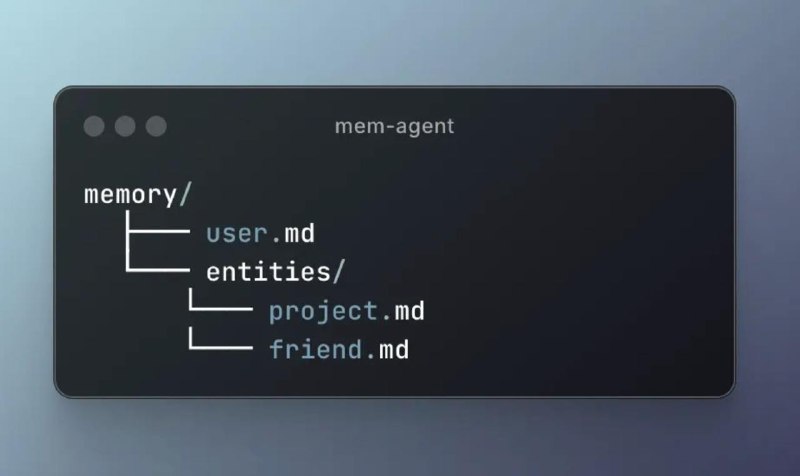
- Вся информация лежит в Markdown: memory/user.md и отдельные файлы для сущностей.
- Связи между файлами сделаны как в Obsidian: [[entity]].
- Агент может извлекать факты, обновлять их или задавать уточняющие вопросы, если запрос неполный.

Вместо огромных контекстов и упора в лимиты, Mem-Agent извлекает нужные фрагменты из локальных документов, сжимает их и передаёт агенту.

Как обучали:
- Базовая модель: Qwen3-4B-Thinking-2507.
- Использовали метод онлайн-RL (GSPO).
- Тестировали на md-memory-bench.

Результаты:
- mem-agent уверенно решает задачи памяти, близко к уровню больших моделей.
- Даже в сжатых версиях (4-bit и 8-bit) сохраняет почти то же качество.

Чем хорош:
- Память можно читать и редактировать вручную.
- Агент работает быстро и эффективно, даже в маленьком размере.
- Удобен как компонент в более крупных системах (например, через MCP).

🟠Model: https://huggingface.co/driaforall/mem-agent
🟠Blog: https://huggingface.co/blog/driaforall/mem-agent
🟠Repo: https://github.com/firstbatchxyz/mem-agent-mcp

@ai_machinelearning_big_data


#LLM #AI #Agents #MemAgent #Dria #MCP #LocalAI
Post #392 45
Важный пост про безопасность

Уже некоторое время назад я перестал использовать пароли, которые придумываю и запоминаю сам. Так как мысль доверять генерацию и хранение паролей Apple и Google мне претила, использую стороннее приложение - Bitwarden. Бесплатное, нравится, есть плагин для браузеров. Паради хранятся на сервере и доступны со всех устройств.

Все было бы хорошо, но работая с нейронками, особенно с моделями типа Claude Code, столкнулся с тем, что они читают .env файлы с паролями не задумываясь, как ты не ограничивай их промптами. Перебирая различные способы скрыть пароли и ключи от нейронок я пришел к следующему.

В дополнение к своему Bitwarden установил опен-сорс серверное приложение Vaultwarden - хранилище для моих паролей и ключей. Bitwarden переключил с облака на мой сервер. Сделал автоматическое формирование бэкапов и дублирующий сервер, если вдруг основной отрубится. В итоге все ключи и пароли - только на моих собственных серверах.

А в скриптах, с которыми работает ИИ, используются не ключи, а ссылки на мое хранилище, чтение которых не позволяет ничего лишнего раскрыть. Ну и браузер заодно поменял на Brave, чтобы сбор информации обо мне был на минимуме.

Все относительно несложно, но выходные на это можно и, пожалуй, стоит потратить.

Да, для двухфакторной аутентификации также попробуйте такую штуку как Google Authentificator. Удобно и надежно, проще, чем использование email и пр., возможно есть и опенсорсные аналоги, но здесь мне это показалось лишним.

Пока возился со всем этим, попутно выяснил, что мой немецкий сервер атакуется не то чтобы нон-стоп, но регулярно. Поэтому к другим серверам, которыми пользуюсь только я, отрубил доступ по паролю и оставил только ключи - то есть на сервер можно зайти только с того компьютера, у которое есть этот ключ (уже наловчился их генерить). Это еще и удобнее для работы в терминале - быстрее подключаешься. Тоже рекомендую

И в довесок - опенсорсное приложение для анализа утекших секретов. Не пробовал, но это один из топов GirHub на сегодняшний день

https://github.com/trufflesecurity/trufflehog
GitHub GitHub - trufflesecurity/trufflehog: Find, verify, and analyze leaked credentials Find, verify, and analyze leaked credentials. Contribute to trufflesecurity/trufflehog development by creating an account on GitHub.
Post #391 47
Браузер Brave выпустил SOTA поиск с использованием AI. Утверждается, что лучше, чем у Perplexity.

Я, кстати, неделю назад перешел с Google Chrome на Brave. История в том, что это браузер хоть и коммерческий, но с открытым кодом и акцентом на приватность. Его разрабатывают на деньги Питера Тиля. Основатель Брендон Айк - создатель JavaScript и бывший директор Mozilla.

Это не первая моя попытка перехода, но судя по всему, первая успешная - сейчас мне все нравится. Ну а заморочился я этим, так как решил посвятить немного сил безопасности и приватности - об этом подробнее в следующем посту
Brave Introducing AI Grounding with Brave Search API, providing enhanced search performance in AI applications | Brave With AI Grounding, responses are anchored in high-quality, factual information from verifiable Web sources, thus reducing hallucinations and responding more appropriately to nuanced inputs.
Post #390 35
Сейчас первая по популярности модель для скачивания на hugging face (не угадаете) - Ernie 4.5 21b. Но тут уже новая моделька, с которая дает тесты, не хуже, а местами и на уровне got-oss 20b.

Встречайте Ling-mini-2.0 16b- A1B-MoE. Сразу даю ссылку на оптимизированную под мак квантизацию на 4 бита - должна летать на маках с 16гб памяти
huggingface.co mlx-community/Ling-mini-2.0-4bit · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
Post #389 32
Не перевелись умельцы и в родном отечестве - вашему вниманию представляется агент от Сбера.

По сегодняшним временам мысль использовать для агента не самый дешевый и не самый открытый Gigachat диковата, но можно подключить и другие модельки. Посмотрим, во что это разовьется, а то как-то мы на фоне китайцев совсем потерялись.

Для интереса можно посмотреть и на иностранные новинки по части агентов, например - на Agent 3 от Replit
GitHub GitHub - ai-forever/giga_agent: GigaAgent — это универсальный агент-оркестратор для решения широкого круга задач (ReAct + REPL) GigaAgent — это универсальный агент-оркестратор для решения широкого круга задач (ReAct + REPL) - ai-forever/giga_agent
Post #388 30

Forwarded from Все о блокчейн/мозге/space/WEB 3.0 в России и мире

Все-таки школа ByteDance крутая: Genspark выпустили 1-й в мире ИИ-браузер, который работает без интернета и бесплатно

Genspark AI Browser — это браузер от компании Genspark, основатели экс-ByteDance, который работает полностью локально на устройстве без необходимости подключения к интернету. Предыдущие релизы команды здесь.

Это значит, что можно скачать и запускать открытые модели ИИ, такие как GPT-OSS, Gemma3 и другие. Всё это бесплатно для всех пользователей навсегда.

Основные фичи этого релиза:

1. Локальный ИИ без интернета. Модели загружаются на твой компьютер или устройство, так что браузер работает автономно.

2. Genspark Super Agent встроен в каждую страницу, которую ты посещаешь. Например, на сайтах шопинга просто нажми "Найти лучшую сделку", и ИИ мгновенно просканирует цены по всему вебу, сравнит продукты и отзывы, чтобы помочь выбрать оптимальный вариант.

3. Режим автопилота, где ИИ самостоятельно "гуляет" по интернету, собирает информацию, выполняет задачи (например, исследует тему или автоматизирует рутину) без твоего участия.

4. Без рекламы. По умолчанию блокирует всю рекламу, попапы и баннеры, чтобы просмотр был чистым и без отвлекающих факторов.

5. Импорт всех данных: закладки, пароли, история из старого браузера одним кликом.
Genspark Genspark - Your All-in-One AI Workspace Genspark is your all-in-one AI workspace. Slides, docs, images, video, code, and design — all in one place. Try free today.
Post #387 38
Для того, что бы модель с открытыми весами работала на обычных устройствах без больших плясок с бубнами, ее надо переупаковать в GGUF файл (или в другой формат - например, в MLX, оптимизированный для маков). Как правило, это делается сообществом, на одну модельку может быть много вариаций таких файлов с различными квантизациями, файн-тьюнингом и пр.

Напомню, квантизация, позволяет "огрублять" параметры модели, жертвуя точностью, но экономя память, которая является узким местом для запуска моделей. Так, стандартная модель - это параметры с 16 бит, квантизация до 8 бит уменьшает требования к памяти в 2 раза, но делает точность модели 99% от начальной. Квантизация до 4 бит снижает требования в 4 раза при точности 95-97%.

Команда Unsloth знаменита своими "упаковками" и поэтому новость от нее заслуживает внимания. Ребята научились делать динамическую квантизацию до 3 бит, и даже до 1 бита, которая вполне достойно работает. Идея в том, что важные параметры модели огрубляются мало - до 8 бит, а менее важные - сильно, в том числе, и до 1 бита. Как итог, снижение качества незначительное, а требования к памяти падают сильно.

В целом, при прочих равных, лучше большая квантованная модель будет на том же компьютере давать лучшие результаты, чем маленькая неквантованная, если квантование не слишком сильное. Поэтому такая оптимизация - штука очень интересная и перспективная. Буду следить за новыми моделями от unsloth
unsloth.ai Unsloth Dynamic GGUFs on Aider Polyglot | Unsloth Documentation Performance of Unsloth Dynamic GGUFs on Aider Polyglot Benchmarks
Post #386 33
Сегодня моделек и новостей не так много.

Конечно, хит недели - Qwen 3 Next 80b. О ней, кажется, написали уже все. Очень быстрая и эффективная, но живых отзывов пока мало. Для того, чтобы развернуть дома, желательно иметь Mac Studio M3 Ultra в базовой комплектации, за 400К руб. Маков с 64Гб памяти, видимо, будет маловато для этой модели.

Seedreams 4 от ByteDance (создатель ТикТока) обгоняет по популярности гугловскую nanobanana (модели рисуют картинки), и это интересно. Битва монстров.

Китайцы разместили в открытом доступе Ernie-4.5-21b, модель - лидер по скачиваниям и это уже имеет практический интерес - на 32Гб памяти можно уверенно пробовать. Вот здесь ссылка на модель, оптимизированную под маки, с 4-битной квантизаций.

У Клода появился режим инкогнито (для тех, кто разрешил записывать диалоги в память - я пока нет). И, говорят, на 3 месяца снизили стоимость подписки на Pro для новых пользователей до 9 баксов в месяц. Это стоит того
huggingface.co baidu/ERNIE-4.5-21B-A3B-Thinking · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
Post #385 31

Forwarded from БлоGнот

OpenAI добавила полную поддержку MCP в ChatGPT. Правда, в десктопном приложении вы этого, разумеется, не найдете, впрочем, там много чего нет. А в настройках вебчата надо в пункте «Connectors» найти Advanced Settings, включить там Developer Mode и тогда появится возможность добавить «unverified connectors that could modify or erase data permanently. Use at your own risk». И тогда появится возможность нажать «Create» в списке коннекторов и указать там все параметры обычных MCP серверов.

В общем, enjoy.

https://platform.openai.com/docs/guides/developer-mode
Post #384 36
У ChatGpt теперь тоже есть полноценный доступ к МСР. Это прекрасно, ждем когда и Gemini перестанет рассказывать, что это сырая технология ))
Post #383 45
Сегодня прямо море новостей про новые модели, мне нравится. А еще

- Microsoft развивает свой IDE (редактор, в котором программируют);

- команда Qwen готовит анонс новой модели Qwen-3-Next-80B-A3B с радикальной MoE архитектурой: 80B общих параметров при всего 3B активных. Это самая разреженная архитектура в истории — активируется лишь 3.75% от общего числа параметров против обычных 10-15% в MoE;

- новая открытая модель FLUX.1 от Krea для работы с фотореалистичными изображениями;

- еще одна топовая моделька по генерации картинок (по 3 руб. за штуку) - Seedream 4.0;

- большое обновление Google Notebook LM (это интересно - аналогов для перевода информации в вид подкаста у других производителей нет, попробуйте - прикольная штука, и совершенно бесплатно);

- Lipsync-2-pro еще лучше подстраивает движения губ под речь.

Как вы понимаете - это еще далеко не все. Но, пожалуй, самая забористая новость сегодняшнего дня - наушики, которые позволяют чатиться силой мысли. Дожили
X (formerly Twitter) alterego (@alterego_io) on X Introducing Alterego: the world’s first near-telepathic wearable that enables silent communication at the speed of thought. Alterego makes AI an extension of the human mind. We’ve made several …
Post #382 71
🚀 mmBERT: первый достойный преемник XLM-R за 6 лет

Johns Hopkins University представил mmBERT — первую многоязычную encoder-only модель, которая значительно превосходит XLM-R. За 6 лет это первый real upgrade для multilingual encoders, что действительно вечность в AI-времени. Обучена на 3T+ токенах в более чем 1800 языках с революционным подходом progressive language addition.

Ключевые результаты: В 2-4 раза быстрее предыдущих моделей при лучшем качестве. На низкоресурсных языках превосходит даже o3 и Gemini 2.5 Pro. Значительно опережает XLM-R на XTREME benchmark и показывает strong gains на MTEB v2 для multilingual retrieval. Поддерживает 8192 токена против 512 у XLM-R.

🎯 Назначение модели: Классификация текстов (тональность, категории), семантический поиск в RAG системах, извлечение эмбеддингов для similarity search, NER (извлечение сущностей). НЕ генерирует текст — только анализирует и понимает. Аналог BERT/XLM-R, но в разы лучше.

🖥️ Системные требования: mmBERT-small (140M) — ~1GB VRAM, работает на RTX 3060. mmBERT-base (307M) — ~2GB VRAM, RTX 4060/MacBook M2 16GB. В отличие от больших LLM, запускается на обычных GPU и даже CPU. Inference намного быстрее генеративных моделей.

⚡ Технические преимущества: До 8x более эффективная обработка длинных последовательностей. Energy efficient благодаря современной архитектуре. Лучший throughput на всех длинах последовательностей. Работает с любыми текстовыми данными — от классификации до code retrieval.

✅ Открытость: Полностью опенсорс под Apache 2.0. Доступны модели jhu-clsp/mmBERT-base (307M) и jhu-clsp/mmBERT-small (140M), training data, intermediate checkpoints и код обучения. Можно легко fine-tune под свои задачи.

🔗 Основные ссылки:
📄 [Научная статья](https://arxiv.org/abs/2509.06888)
🤗 [Модели HuggingFace](https://huggingface.co/collections/jhu-clsp/mmbert-a-modern-multilingual-encoder-68b725831d7c6e3acc435ed4)
📝 [Блог пост](https://huggingface.co/blog/mmbert)

#multilingual #encoder #opensource #написаноклодом
arXiv.org mmBERT: A Modern Multilingual Encoder with Annealed Language Learning Encoder-only languages models are frequently used for a variety of standard machine learning tasks, including classification and retrieval. However, there has been a lack of recent research for...
  • ❤ 1
  • 👍 1
Post #381 41
🚀 ERNIE X1.1: Baidu обновил reasoning-модель и сравнялся с GPT-5

На Wave Summit 2025 Baidu представил ERNIE X1.1 — улучшенную версию своей reasoning-модели. По сравнению с ERNIE X1 новая версия показала +34.8% точности фактов, +12.5% следования инструкциям и +9.6% агентских способностей. Базируется на ERNIE 4.5 с гибридным reinforcement learning и итеративной самодистилляцией.

Ключевые результаты: В бенчмарках превосходит DeepSeek R1-0528 и показывает результаты наравне с GPT-5 и Gemini 2.5 Pro. Особенно хорошо справляется с задачами, требующими рассуждений и точности фактов — проблемными зонами многих LLM.

🖼️🎬🎵 Мультимодальность: Поддерживает понимание и генерацию изображений, работу с видео, аудио и графиками. Может анализировать мемы, комиксы, чарты и даже фильмы. Особенность — высокий "эмоциональный интеллект" для понимания сарказма и интернет-культуры.

🖥️📱 Доступность: Сразу доступен в ERNIE Bot (ernie.baidu.com), приложении Wenxiaoyan и платформе Qianfan через API для разработчиков. Пока только на китайском и английском языках.

🇷🇺 Русский язык: Поддержка кириллицы есть (базируется на ERNIE 4.5)

🔥 Бонус релиза: Открыли исходники ERNIE-4.5-21B-A3B-Thinking — lightweight MoE модель (21B общих параметров, 3B активных) с 128K контекстом. Показывает near-SOTA результаты при значительно

🔗 Основные ссылки: 🏠 ERNIE Bot 🤗 GitHub ERNIE 🎮 Live демо

#reasoning #baidu #написаноклодом
ERNIE Blog
Post #380 34
🚀 K2-Think: новая frontier 32B модель

MBZUAI и G42 выпустили K2-Think — открытую reasoning-систему на 32B параметров, которая показывает результаты уровня frontier-моделей. Базируется на Qwen2.5-32B с добавлением продвинутого пост-тренинга: long chain-of-thought SFT (обучение с длинными цепочками рассуждений), RLVR (обучение с подкреплением от проверяемых наград), agentic планирование и test-time scaling.

Модель генерирует на 11.7% меньше токенов чем конкуренты, сохраняя качество ответов. Интересная особенность — "план-перед-решением" подход: сначала создает компактный план, потом полное решение.

Базируется на Qwen2.5-32B. Для 32B модели понадобится ~20GB RAM для 4-bit квантизации. На данный момент оптимизирована для Cerebras WSE с ~2000 токенов/сек.

Пока народ еще модель не распробовал, посмотрим, какие будут отзывы.

🔗 Основные ссылки:
🏠 [Техотчет](https://k2think-about.pages.dev/assets/tech-report/K2-Think_Tech-Report.pdf)
🤗 [HuggingFace](https://huggingface.co/LLM360/K2-Think)
🐙 [GitHub SFT](https://github.com/MBZUAI-IFM/K2-Think-SFT)
🎮 [Демо](https://k2think.ai/k2think)
💬 Сообщество:
(https://marktechpost.com/2025/09/09/mbzuai-researchers-release-k2-think-a-32b-open-source-system-for-advanced-ai-reasoning-and-outperforms-20x-larger-reasoning-models/)

#reasoning #opensource #написаноклодом
Post #379 90
Долгожнанная новость - нейросеть, в данном случае Claude начала работать с редактированием файлов MS Ofiice. Удивительно, конечно, что это не Copilot (совершенно бесполезный в офисных приложениях) или Gemini, который мог бы работать с google docs. Очень жду, когда функционал раскатают на более дешевые подписки - у меня много задачек такого рода, начиная с банального единообразного оформления справок и докладов..
Telegram Refat Talks: Tech & AI 🤩 Claude научился создавать и редактировать реальные файлы: excel, word, powerpoint - мой детальный обзор Пока фича доступна только на Max, Team и Enterprise тарифах (Pro получат скоро), я сразу потестил и хочу рассказать, как это вообще работает и что можно…
  • 🔥 2
Post #378 32
🎙️ Alibaba выпустила Qwen3-ASR-Flash — универсальную модель распознавания речи

Команда Qwen анонсировала Qwen3-ASR-Flash — специализированную ASR модель (автоматическое распознавание речи), обученную на базе Qwen3-Omni. Модель тренировалась на десятках миллионов часов речевых данных и показывает впечатляющие результаты на бенчмарках.

Ключевые характеристики:
Поддерживает 11 языков с диалектами: китайский (мандарин + кантонский, сычуаньский), английский (американский, британский), французский, немецкий, испанский, итальянский, португальский, русский, японский, корейский, арабский

Автоматическое определение языка и фильтрация тишины/шума

Контекстная настройка — можно подавать любой текст для улучшения точности (имена, жаргон, даже бессмыслицу)

Производительность превосходит конкурентов: 🖥️⚡ На тестах августа 2025 года Qwen3-ASR-Flash показал ошибку всего 3.97% на стандартном китайском против 8.98% у Gemini-2.5-Pro и 15.72% у GPT-4o-Transcribe. На английском — 3.81% против 7.63% и 8.45% соответственно.

Уникальная фишка — музыка: 🎵 Модель отлично распознает тексты песен с фоновой музыкой (ошибка 4.51% против 32.79% у Gemini и 58.59% у GPT-4o на полных песнях). Работает даже с рэпом и сложными акустическими условиями.

Для русского языка: 🇷🇺 Входит в список поддерживаемых языков, но пока нет детальных тестов качества работы с кириллицей.

Доступность: ✅🔒 Доступен только через API Alibaba Cloud (платформа Bailian). Веса модели не открыты. Есть демо на HuggingFace для тестирования.

🔗 Основные ссылки:
🎮 HuggingFace Demo
🏠 Официальный блог Qwen
🤖 ModelScope Demo
🔧 API Alibaba Cloud

#Qwen3ASR #ИИ #написаноклодом
huggingface.co Qwen3 ASR Demo - a Hugging Face Space by Qwen This app lets you upload an audio file and instantly get a written transcription. You can add optional context, choose a specific language or let the system detect it, and enable inverse text norma...
  • 🔥 1
Post #377 34
Google снижает цены на Veo3 в 2 раза (это SOTA модель по генерации видео) и запускает генерацию вертикальных видео. В принципе, доступ к Veo3 - один из поводов купить платную подписку.
Googleblog Google for Developers Blog - News about Web, Mobile, AI and Cloud Veo updates: vertical video, 1080p HD, and lower pricing for Veo 3 and Veo 3 Fast. Now stable in Gemini API for high-quality video generation.
Post #376 32

Forwarded from partially unsupervised

What makes Claude Code so damn good (and how to recreate that magic in your agent)

Рекомендую почитать любителям везде воткнуть мультиагентный граф, сверху накинуть векторный RAG и удивляться, почему все не очень работает.
minusx.ai What makes Claude Code so damn good (and how to recreate that magic in your agent)!? Claude Code is the most delightful AI agent/workflow I have used so far. Not only does it make targeted edits or vibe coding throwaway tools less annoying, ...
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →