TGViewer
Channel Public Channel
very vibe coding

very vibe coding

@veryvibecoding

Канал Алексея Макрушина об экспериментах в области vibe coding и всего интересного, что есть в области AI, ML и тому подобного
Subscribers
121
Photos
462
Videos
126
Links
990

Showing posts older than #1151 · Back to latest

Older Posts 20 shown
Post #1150 44
И завершая на сегодня с моделями - в маленьком (до 30В) размере обратите внимание на новые модели от IBM - Granite, и NVIDIA - Nemotron. Может быть интересно, не квеном единым, что называется
Post #1148 91
В продолжение темы моделей - есть такая контора FactoryAI, которая запускает неплохих агентов Droids. Она провела исследование, какие модели лучше делают ревью кода.

И здесь тоже новые модели Антропика и OpenAI уступают старым! Лучшая модель - GPT 5.2 (интересно, что в кодексе старые модели доступны, похоже что не случайно..)

Видимо, какое-то плато не так далеко, и опенсорсные модели не так далеко от него
X (formerly Twitter) Factory (@FactoryAI) on X Read our full analysis here: https://t.co/l30oDzIXbJ
Post #1147 43
Глядя на размер топовых моделей в 5-10Т параметров, понимаешь, что такое локально не запустишь никогда.. немного грустно от этого
Post #1146 43
Из новостей - Mistral вчера выпустил модельку на 128B, но думаю, что эта тема пройдет незамеченной. Вообще, 5 баксов, которые я потратил на апи Мистраля кажутся мне пока самой неудачной инвестицией в ИИ
Post #1145 48
Tencent представила микромодельку-переводчика на 1,8B параметров (ставится на телефон, в квантах - 440Mb памяти), которая обгоняет переводчик от Google
GitHub GitHub - Tencent/AngelSlim: Model compression toolkit engineered for enhanced usability, comprehensiveness, and efficiency. Model compression toolkit engineered for enhanced usability, comprehensiveness, and efficiency. - Tencent/AngelSlim
Post #1144 48
В продолжение темы исследования, о котором писал выше - как и чувствовалось, Опус 4.7 - более компактная и "глупая" модель, чем Опус-4.6. И токенов жрет в 1,5 раза больше. Возвращайтесь на 4.6, кто работает с Клодом. Интересная история с размером Хайку - очень маленькая модель тоже. И глупая. Не используйте Хайку, лучше - Соннет. Антропик, очевидно, экономит как может.

У Google, судя по всему, все неплохо заточено на ресерч.и работу с длинным контекстом. То есть модель не для программирования, а для исследований. Запомним. Лучшие китайцы - на уровне Соннета, но и это неплохо. Жить можно. Первый раз за долгое время статью научную посмотрел.
Post #1143 43

Forwarded from Machinelearning

⚡️ Sakana AI научила голосовой ИИ думать на ходу

Японская Sakana AI показала KAME - систему, которая может заметно изменить голосовых ассистентов. Работу уже приняли на ICASSP 2026, и идея там очень простая: ИИ должен не сначала долго думать, а потом говорить, а думать прямо во время разговора.

Сейчас у голосовых моделей есть неприятный компромисс. Быстрые speech-to-speech системы отвечают почти мгновенно, но часто звучат поверхностно. А если подключить мощную языковую модель, ответ становится умнее, но появляется пауза, которая ломает живой диалог.

KAME пытается убрать этот выбор между скоростью и качеством.

Авторы взяли за основу то, как говорят люди. Мы редко строим идеальную фразу целиком перед тем как ее сказать. Обычно начинаем говорить, а мысль уточняется уже по ходу предложения. Sakana AI перенесла этот принцип в архитектуру голосового ИИ.

Система работает в два потока. Лёгкая речевая модель сразу начинает отвечать, чтобы не было неловкой задержки. А параллельно большая языковая модель думает глубже и в реальном времени подмешивает более сильные варианты в речь. Получается, что ассистент не просто выдаёт готовую реплику после паузы, а ведёт разговор и дорабатывает мысль на лету.

Отдельно интересно, что бэкенд можно менять. Нужна логика - подключаешь Claude. Нужна скорость - берёшь Gemini Flash. Нужен другой стиль ответа - ставишь GPT. При этом сам голосовой слой не приходится пересобирать.

В экспериментах разные модели показали себя по-разному: Claude лучше справлялся с задачами на рассуждение, GPT сильнее выглядел в гуманитарных вопросах. То есть движок можно выбирать под конкретный сценарий, а не пытаться одной моделью закрыть всё.

KAME уже выложили на Hugging Face. Это идея из статьи, а штука, которую можно проверить руками.

Если подход взлетит, голосовые ассистенты станут гораздо ближе к нормальному разговору: без долгих пауз, но и без ощущения, что модель просто быстро болтает ни о чём.

Blog: https://pub.sakana.ai/kame/
Paper: https://arxiv.org/abs/2510.02327

@ai_machinelearning_big_data

#sakana
Post #1142 39
Post #1141 41

Forwarded from Анализ данных (Data analysis)

32 тысячи звёзд на GitHub всего за 10 часов!

Терминал Warp открыли в open-source.

Это одна из самых заметных agentic development environment: терминалом уже пользуются больше 1 млн разработчиков по всему миру. Теперь проект хотят развивать быстрее за счёт комьюнити, внешних контрибьюторов и прозрачной разработки.

open-source-релиз стал возможен при поддержке OpenAI, которые выступили главным спонсором проекта.

Реакция комьюнити мощная: репозиторий за несколько часов собрал уже 30+ тысяч звёзд на GitHub.

И, конечно же, он написан на Rust.

https://github.com/warpdotdev/warp
Post #1140 41
Очень интересная тема - пытался сделать что-то похожее, но как у вайбкодеров принято, остановился на полпути. Файловая система с графами и RAG

https://x.com/supermemory/status/2049330931564208249?s=46
X (formerly Twitter) supermemory (@supermemory) on X Introducing SMFS: The new Supermemory Filesystem. Supermemory did Memory. And then RAG, and then extractors and connectors. Now, we also have a new filesystem primitive: https://t.co/Lqmlwmd5hS
Post #1139 44
В связи с баном от Антропика встает вопрос - что дальше. Подписчики хотят, чтобы потестил локальные модели - я тоже хочу, но жду выхода Mac Studio M5 Ultra. Должны выпустить в июне, но могут и отложить из-за дефицита памяти. Но вообще, предложения интересные по железу есть..
Post #1138 45
Post #1137 42

Forwarded from эйай ньюз

У Сбера вышел Kandinsky 6.0 Image Pro.

Главный апдейт тут в editing. В side-by-side модель сравнивают с Flux 2 Max и GPT Image 1.5, причём оценивают конкретные вещи: как правка встраивается в сцену, сохраняются ли стиль, геометрия, лицо, фон и локальная консистентность. Именно на этом обычно сыпятся image editing модели.

По скорости тоже прирост: больше 40% к прошлой версии за счёт MoE, распараллеливания инференса и оптимизации внимания.

Самая интересная часть — Image RAG. Модель подтягивает релевантные изображения в контекст и точнее попадает в специфические штуки, которые в обычной генерации легко превращаются во «что-то примерно славянское».

Из кейсов: удаление объектов и надписей, замена предметов с сохранением стиля, стилизация с сохранением лица, реставрация архивных фото, интерьеры по плану и фасады одним промтом.

Анонс

@ai_newz
Post #1136 41
Привык, конечно, к Клоду. Но может, пришло время экспериментов..
Выйти из зоны комфорта..
Post #1135 43
О, меня забанил Антропик. Интересно с чего это. Подпишусь на большую подписку у ChatGPT, а вот подписываться ли на Антропик с другого эккаунта - подумаю... свет клином не сошелся
Post #1134 44
Post #1133 47
Поставил себе новомодного агента - Hermes. Чем дальше, тем проще все ставится. Подключил к ChatGPT по подписке (можно Gemini). А вот Антропик, хоть и подключается к Claude code, работает по API. Жгучее желание есть перейти на GPT, но подписка за 20 баксов расходуется так экономно, что ее пока хватает..
  • 👍 2
Post #1132 49
Post #1131 38

Forwarded from Machinelearning

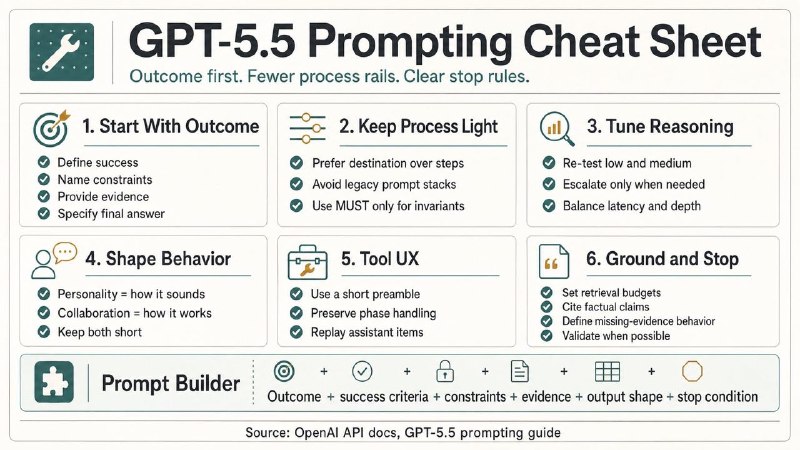
📌 Гайд по промптингу GPT-5.5: старые промпты придётся переписать.

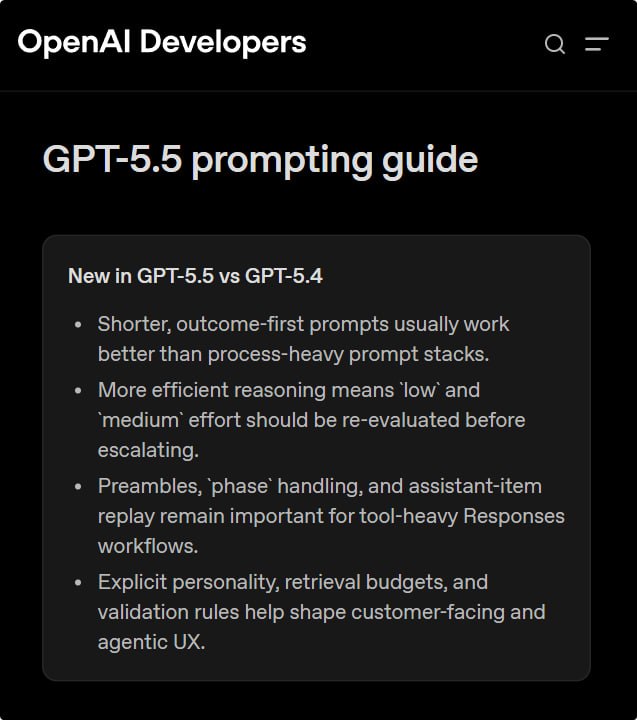
GPT-5.5 отличается от GPT-5.2 или GPT-5.4 в части промптнинга. Миграцию OpenAI советует начинать с минимального промпта, который решает задачу, и только потом донастраивать reasoning effort, описания инструментов и формат вывода.

GPT-5.5 рассуждает эффективнее предшественников, поэтому сначала стоит проверять уровни «low» и «medium», а к более высоким тянуться только при необходимости.

Старые промпты часто расписывают процесс шаг за шагом: прежним моделям требовались подробные инструкции. Для GPT-5.5 это сужает пространство поиска и как следствие даст механические ответы.

OpenAI предлагает прописывать целевой результат, критерии успеха, ограничения и доступный контекст, а как добраться до результата, модель решит сама.

Слова «ALWAYS» и «NEVER» советуют беречь для настоящих инвариантов: правил безопасности и обязательных полей вывода. Для остального - правила и явные ограничители, чтобы модель не зацикливалась в бесконечных лупах.


Рекомендованная структура промпта открывается ролью и контекстом, дальше идут Personality, Goal, Success criteria, Constraints, Output и Stop rules.

Внутри блока Personality гайд просит разделять 2 измерения: как ассистент звучит (тон, формальность, юмор) и как он работает - когда уточнять, когда делать допущения и как обходиться с неопределённостью.

Поведение при поиске и цитировании

OpenAI вводит понятие retrieval budgets: один широкий поиск по коротким ключевым словам, повторный - только если не хватает фактов, нужен конкретный документ или пользователь просил исчерпывающий обзор.

Для презентаций и маркетинговых текстов руководство рекомендует чётко делить утверждения: где нужны источники, а где можно писать свободно.

Для стриминговых интерфейсов гайд предлагает preambles — короткие пользовательские апдейты в одно-два предложения перед первым вызовом инструментов. Они не ускоряют модель, но заметно сокращают воспринимаемую задержку.

Переписывать всё вручную не обязательно. OpenAI опубликовала собственный Skill для Codex и других кодинг-агентов - он применяет правила нового гайда одной командой.


@ai_machinelearning_big_data

#news #ai #ml
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →