
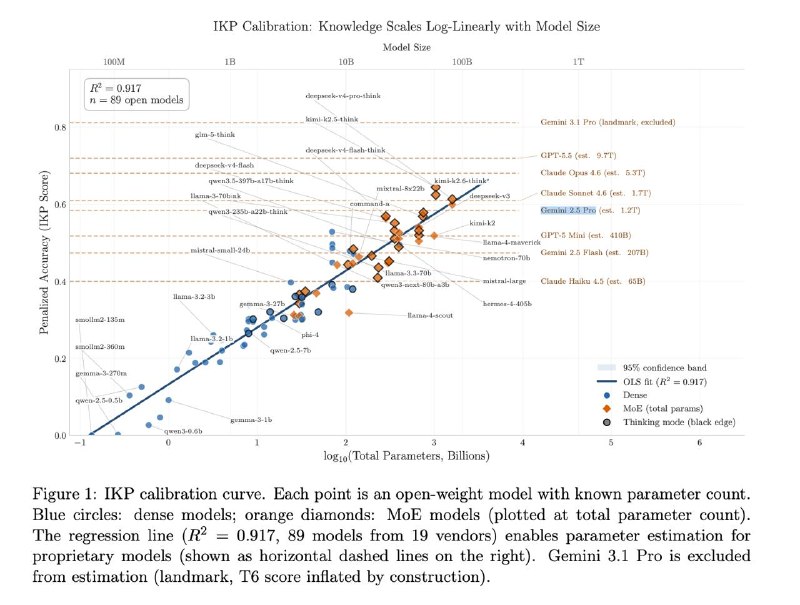
Как мы знаем, закрытые лаборатории не раскрывают количество параметров своих моделей. Есть стандартный метод оценки через экономику инференса, но он дает погрешность в 2× и более из-за неизвестных деталей об инфре.
Так вот: позавчера на архиве появилась статья, в которой автор предлагает принципиально иной подход, через оценку количества знаний модели. Речь именно о знании фактов, а не интеллекте в целом, потому что способность к рассуждению можно дистиллировать и сжимать в меньшие модели, а фактические знания – нет, они ограничены энтропией Шеннона.
Методология такая: автор создал бенчмарк из 1400 фактических вопросов, разбитых на 7 уровней редкости, от широко известных фактов до крайне малоизвестных. Его откалибровали на 89 открытых моделях с известным числом параметров, и оказалось, что есть явная (R²=0.917) лог-линейная зависимость скора на бенче от числа параметров.
Проецируя закрытые модели на калибровочную кривую, автор получает такие оценки*:
– GPT-5.5 ≈ 9.7T параметров
– Claude Opus 4.6 ≈ 5.3T
– Claude Sonnet 4.6 ≈ 1.7T
– Gemini 2.5 Pro ≈ 1.2T
• из-за природы метода и из-за настроек безопасности некоторых моделей (на какие-то вопросы они могут просто отказываться отвечать), эти оценки ближе к нижним границам.
Конечно, точность все равно довольно мала, но числа интересные.
https://arxiv.org/pdf/2604.24827