
Я заинтересовался, а нет ли ещё каких-то доказательств бесполезности тестов, которые получил Kun Chen на DeepSWE и Program Bench уже как академическое исследование, а не посты? Плюс странно, почему на такую «горячую тему» он с тем же ИИ не сверстал статью.
Исследование источников на деле показало, что Kun Chen тут немного хайпует за счёт того, что хорошо известный факт реальным учёным просто не очень известен обычным разработчикам. До него уже такие результаты получали и в разных исследованиях. Фактически ценность тестов Kun Chen в том, что он доказал на самых последних LLM и самых последних версиях SWE-тестов, что ситуация не изменилась и сохраняется на деле уже давно.
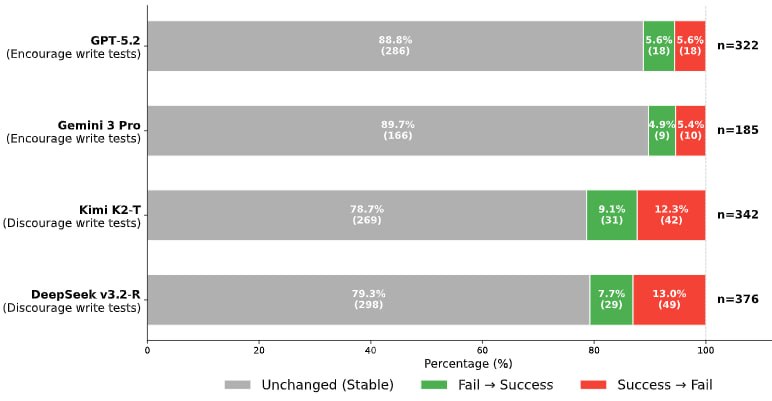
На графике вы можете видеть результаты исследования довольно авторитетной группы учёных, представляющих ByteDance, Shanghai Jiao Tong University и Singapore Management University.
График показывает, как меняется число решённых задач LLM, если отключить вообще все тесты в классических бенчмарках вроде SWE-Bench. Напомню, они построены на реальных крупных приложениях и сделаны обычно специалистами более высокой квалификации, чем большинство обычных приложений.
Для продуктов OpenAI ситуация не изменилась: сколько тесты нашли новых багов, с такой же силой запутали агента в других. Для Gemini включение тестов вызвало даже небольшой регресс. Для старых китайских моделей Kimi K2 и DeepSeek V3.2 отключение тестов вызвало небольшой регресс, но исследователи отмечают, что он статистически не значим (p=0.435).
Если почитать мнение учёных, какая коренная причина неэффективности тестов ИИ, то их консенсус скорее в том, что тесты, написанные самим ИИ, — «это мусор», т.к. просто зеркалят тот же код, что ИИ создал. Чтобы тесты были активом, они должны иметь «внешний фактор новой информации», т.е. это не тесты, созданные на том же контексте, что и код, а тесты либо написанные людьми, либо по внешним тестовым данным и т.п.
На деле это серьёзные моменты, многим ИТ-директорам тут есть о чём подумать. Не получается ли так, что разработчики часто тратят токены и рабочее время на бесполезную деятельность по созданию тестов? Как минимум деятельность по созданию тестов должна быть пересмотрена той самой инъекцией «внешнего контекста», или это бесполезные ритуалы, а не организация поддержки качества.
https://arxiv.org/abs/2602.07900
Post #5367
3.47K
- ✍ 14
- 🔥 9
- 🤯 6
- ❤ 5