TGViewer
Channel Public Channel
AI Projects

AI Projects

@turboproject

Искусственный интеллект. Управление проектами. Промптинг. Vibe coding
Subscribers
11.2K
Photos
2.9K
Videos
472
Links
2.3K
Recent Posts 20 shown
Post #5213 2.99K
🚀 Похоже, Дарио выигрывает этот раунд у Альтмана и может идти на IPO спокойно. Opus 5.5 сильнее GPT-6 Astra по бенчмаркам, в том числе ключевому агентскому — Terminal-Bench 4.0.

Но при этом Opus намного дешевле Astra. Также на руку Дарио развод Альтмана с Cursor, фактически клиентская база на фронтире там теперь его.

Anthropic вероятно снова «царь горы» во фронтирах. Стоит для фронтов подождать LM Arena, как обычно.

Я бы еще отметил, что прошло всего ДВА МЕСЯЦА с прошлых релизов фронтиров. Это вот настолько ускорился тем роста мощи ИИ. Мы наблюдаем ИИ сингулярность не в теории, а практически.

Для старого софта такое немыслимо, у того же Microsoft версии чаще раз в 2 ГОДА обновляются и не так принципиально как растут по мощи LLM.

Это еще не полная сингулярность, кожаные замедляют обучение ИИ, когда там будет 100% агентов, то самое время пристегнуться от скорости прогресса ИИ.

ИИ развивается намного быстрее всех самых смелых ожиданий и прогнозов.
  • 🤯 30
  • 👍 18
  • 🏆 7
  • ❤ 4
  • 👀 1
Post #5212 2.55K
🔄 Обновились OpenAI и Anthropic, давайте смотреть. У Anthropic давно заброшен Haiku и своей worker-модели нет. Однако у OpenAI есть Luna, вышла ее 6я версия. По цене она дороже флешек китайцев, ещё почти в дауне лежит гейтвей на самом OpenAI, быстро работает только на Amazon. Поэтому скорость скорее всего будет только за покупку токенами.

Для американцев Luna важна как «суверенная модель», но на международном рынке китайские флешки дешевле и быстрее.
  • 🏆 5
  • 👍 3
  • ❤ 1
Post #5211 2.39K
🎬 Обсудим, какие есть методы апскейла видео, совместимые с архитектурой Blackwell в RTX 50-й серии, т.е. NVFP4. Для начала отметим, что сейчас де-факто уже стандарт — не генерировать из того же MiniMax H3 видео очень высокого разрешения, а делать в более низком, а потом upscale. Даже такой процесс есть в готовом виде от Nvidia, но тут всё не так просто, давайте разбираться.

Если вам нужен NVFP4, то скорее всего вариант апскейла сократится до SeedVR2, которую недавно мигрировали в этот формат. Это 7B-модель, которая в NVFP4 весит всего 4.4 ГБ, что, как мы увидим далее, критично, т.к. у вас в VRAM будет больше занимать не веса, а само видео. Вам надо много свободной VRAM.

⚙️ Как вписаться в 16 ГБ (главные грабли)
• Длинное видео целиком НЕ влезает: на выходе 124+ кадров × 2688×1536 → «Not enough GPU memory» + spill в shared RAM (GPU 100%, но холодная = ядра ждут память)
• Лечение: split_latent = ON (темпоральное чанкование). Латент режется на куски, каждый проходит пайплайн отдельно, потом склейка. Несколько «проходов» в прогрессе — это чанки, не пересчёт
• Если заметите «подергивание видео», то это проблема склейки чанков, вы можете настроить перекрытие их кадров через split_latent_temporal_overlap примерно 4-8

🎛 Хитрости самого MiniMax H3
На деле в таком workflow вам нужно понимать, что тут больше зависит от настроек MiniMax, а не апскейлера. Если вы «запорите качество» в самом MiniMax, то апскейлер как мертвому таблетки.

Прежде всего надо знать, что MiniMax H3 требует, чтобы всегда короткая сторона видео была ≤768, выше — деградация нелинейна и резкое замедление. Как раз выше добивается апскейлером. Однако далеко не все разрешения MiniMax H3 дают достаточно низкий уровень артефактов. Рабочие разрешения такие скорее:
608 × 352 — заметные артефакты, черновой вариант, но ниже часто развал видео вообще
864 × 480 — достаточно хорошо уже держит сцены, артефакты умеренные
960 × 544 — оптимальный чистовой вариант под апскейл

Если вы выберете несовместимый с MiniMax H3 вариант разрешения, то он вас закинет артефактами.

📦 Файлы для скачивания (huggingface.co/Comfy-Org/SeedVR2, зеркало hf-mirror.com):
• diffusion_models/seedvr2_7b_sharp_nvfp4.safetensors — 4.4 ГБ (макс. детализация, 640p→HD)
• diffusion_models/seedvr2_3b_nvfp4.safetensors — 1.9 ГБ (быстрый/грубый)
• vae/ema_vae_fp16.safetensors — 0.5 ГБ
  • 🔥 9
  • ✍ 4
  • ❤ 3
  • 👍 1
Post #5210 2.66K
🔍 К спорам в чате: сделан ли Jev на ModernBERT или нет. Большинство экспертов считают, что да. В их числе почитаемый и у нас в чате Себастьян Рашка.

Однако самый сильный тест — просто на родственные архитектуры прямым изготовлением аналога. ModernBERT-base-zeroshot cross-encoder на 149M весов отличается по бенчмарку, и разрыв составляет всего 0.6% по датасету сравнения комбинацией известных как SST-2, AG News, Emotion и BANKING77 по 2500 примеров каждый. Тут как говорится «Совпадение? Не думаю!»

Отдельно отмечу по дискуссии в чате, что многие замечают чувствительность Jev к смене порядка слов или вариантов. Это не доказывает наличие маскированного внимания. Обычный BERT также видит Positional Encoding и понимает/различает порядок слов или вариантов. BERT не умеет предсказывать последовательности токенов как обычные каузальные трансформеры, т.к. будет пытаться как на обучении «заглядывать в будущее», а там данных ещё нет. BERT может предсказать только один токен/вектор, но для задач классификации или эмбеддингов RAG — этого достаточно.

https://huggingface.co/blog/dylantom2012/i-benchmarked-jev-against-open-cpu-only-stacks-it
https://sebastianraschka.com/blog/2026/jev-classification-generalization.html
  • ❤ 13
  • 👍 5
Post #5209 3.13K
🚩 Сейчас идёт настоящий бум Decision-моделей. В топе Hugging Face совсем не Qwen или DeepSeek, а Laya. Начался бум с Jev (API-аналог), который отвечает за 236–276 мс, но Laya ещё быстрее ~33 мс. Фантастическая скорость, крошечный размер и невероятная дешевизна в решениях выбора между вариантами создали бум таких моделей.

Однако я заметил, что многие откровенно наивно используют такие крошечные модели без понимания, что без дообучения они мало отличаются от подбрасывания монеты по точности. Разработчики Laya сами пишут: «Laya is a fast base to specialise, not a zero-shot decision engine». Zero-shot точность на typed-decisions составляет всего 0.362 — чуть выше случайного угадывания (0.318). Но после дообучения на тренировочном сплите того же бенчмарка точность поднимается до 0.766, обгоняя Jev (0.727).

Архитектурно такие модели построены на ModernBERT, но BERT имеет известную славу «мешка слов» и плохого понимания причинно-следственных связей. Это не нормальный трансформер с маскированным вниманием, который понимает «кто на ком стоял». Довольно наивно думать, что в 0.4B весов даже физически могут поместиться данные фактов, необходимые для сравнения вариантов под задачу.

Без обучения модель может отвечать только на простейшие общие вопросы типа «Есть ли фишинг в письме?», причём потребуется ещё сделать калибровку модели через Temperature Scaling (TS), Platt Scaling или Isotonic Regression.

Возможно ещё «подбрасывать факты» в промпт модели, то вам сразу нужен RAG, что убивает преимущества скорости.

Без тюнинга такие модели дают ответы крайне ненадёжно. То, что вы получили «какой-то ответ» — это не значит, что он правильный. Тут местами больше хайпа от тех, кто ещё не понял ограничений этих микроскопических моделей. Я бы напомнил тут про технику Single-Token Logit (STL) промптинга как альтернативу. Вы можете взять нормальную SLM/LLM и попросить модель выбирать вариант одним токеном. В логитах вы можете посмотреть также вероятности вариантов. Однако это нормальные трансформеры, которые знают много фактов мира и понимают причинно-следственные связи в вопросе. Ответ одним токеном тоже очень быстрый и почти ничего не стоит.

https://huggingface.co/convaiinnovations/laya
huggingface.co convaiinnovations/laya · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 💯 16
  • ❤ 8
  • ✍ 3
  • 👍 2
  • 🙏 1
Post #5208 2.9K
📊 На OpenRouter уже можно посмотреть статистику моделей. Можно оценить «какая флешка лучше». На деле вряд ли позиции DeepSeek V4.1 Flash тут пошатнуть получится, т.к. у него козырь очень высокой скорости. GLM на деле для абонентских подписок у зайцев быстрее напрямую через их API, чем OpenRouter показывает — 50 токенов/сек примерно, но это тоже медленней DeepSeek.

Однако MiMo-V2.6-Flash дешевле DeepSeek V4.1 Flash где-то в 2 раза получается. Если у вас очень большой объём токенов для worker-моделей, то MiMo-V2.6-Flash тут экономически целесообразен. Если вам важнее скорость пайплайна, то турболет DeepSeek V4.1 на его CED-архитектуре догнать никто не может из флешек за разумные деньги.
  • 👍 23
  • 🏆 5
Post #5207 2.81K
📊 Arena сделал предварительную оценку MiMo-V2.6-Pro, хотя модель на уровне Claude Fable 5 (High), как и Qwen3.8 Flash Next во фронтах, но можно уже сказать, что MiMo-V2.6-Flash не получится заметно опередить DeepSeek V4.1 Flash, что было критично.

Дело в том, что хотя DeepSeek V4.1 Flash формально на 16 месте, а glm-5.3-flash на 17-м, но у них оценки около 1610 баллов, а у MiMo-V2.6-Pro — 1628. В баллах Elo разница 50–100 баллов — это серьёзно, т. е. другой уровень. Однако 10–15 баллов — это уровень статистической погрешности измерений.

На деле все китайские «флешки» примерно на одном уровне, поэтому важнее скорость и цена. У DeepSeek V4.1 ещё очень важный аргумент именно по скорости.
  • 👍 17
  • ❤ 4
Post #5206 2.58K
Я сделал внимательный анализ, как Xiaomi сделала прорыв в Reinforcement Learning: они смогли путём создания огромных батчей с параллелизмом ускорить RL-обучение примерно в 10 раз. Тут есть тревожный момент ещё для разработчиков российских LLM в Сбере и Яндексе — в части усложнения попыток догнать китайцев. Давайте разберёмся.

Если поглядеть на архитектуру самой MiMo-V2.6, то там нет rocket science. Это обычный GPT, в котором сделали сокращение KV Cache за счёт использования Full Attention только небольшим числом слоёв, а остальные видят «скользящее окно» вокруг токенов и результат глобального анализа из предыдущих слоёв. Это не сложно, и тут нет архитектурной инновации на уровне CED у DeepSeek V4.1. Однако это иллюзия, т.к. инновации Xiaomi — это процесс обучения Reinforcement Learning, а GPT лишь «молотилка данных» для него, т.е. даже не главный компонент.

Архитектор MiMo-V2.6 — Fuli Luo, ранее работала над DeepSeek V2. Поэтому не удивительно, что по факту она создала новый вариант знаменитого GRPO от DeepSeek.

Как работает их процесс RL-обучения? Для начала используется огромная среда обучения из 7000 песочниц с разными harness, MCP, CLI и т.п. и т.д. Xiaomi также входит в сингулярность обучения ИИ и реально готовят среду их ИИ-агенты. Они крайне интеллектуально готовят dataset к песочницам, получая seed-задачи, но конечные задачи определяются уже исследованием реальной среды. Также агенты генерируют «предварительные рубрики» — предварительные критерии оценок.

Далее формируется огромный батч примерно на 2-4 миллиарда токенов из крайне разноплановых задач. Разноплановость нужна для равномерной нагрузки экспертов MoE. Сами внутри задачи это модифицированный GRPO с 16 вариантами, но математически они обрабатываются иначе: Fuli Luo придумала новый распараллеленный и более качественный вариант оценок с улучшенной защитой от reward hacking, что уже головная боль всех вендоров LLM. Побеги ИИ из песочниц — это и есть взломы системы оценок со стороны ИИ.

Первый приём Fuli Luo — метод группового синтеза вознаграждений (Groupwise Reward Synthesis, GRS). Для задач уже есть предварительные рубрики, но если их сделать константами, то ИИ быстро до них догадается и приступит к мошенничеству reward hacking. Поэтому Fuli Luo создаёт окончательные рубрики агентом-оценщиком только после ответов. Сами по себе рубрики уже классика — их применяет и DeepSeek V4.

Далее применяется метод группового перераспределения преимуществ (Groupwise Advantage Redistribution, GAR). Классический GRPO имеет проблемы:
• нужно ждать окончания всего батча до обновления весов
• если ответы все «довольно хорошие», то оценка в баллах «все по 10» не позволяет понять, в какую сторону менять веса

Агент GAR на деле не смотрит взвешенные оценки, а делает множество попарных A/B сравнений ответов относительно рубрик и каждый раз выбирает лучший. После этого можно уже менять веса, а не ждать всю партию 16 ответов из 16 песочниц. Это и есть секрет огромного параллелизма Xiaomi.

Какая тут мораль из этого:
🔹 Для разработчиков российских LLM в Сбере и Яндексе: происходит перелом, когда уже ключевую технологию китайцев для GPT нельзя «скачать с Hugging Face» и она просто не содержится физически в уже готовой модели. Требуется развивать компетенции и среды RL-обучения, которые у наших очень слабые, давайте честно.
🔹 Рубрики как оценки вариантов решений становятся де-факто стандартом во множестве LLM, поэтому почти обязательны при архитектурной аналитике с агентами при анализе вариантов в суперпозиции смысла уже на использовании моделей. Модели глубоко нативно понимают введение критериев оценок как рубрики и применение их для выбора лучших вариантов решений.

https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
  • 🔥 17
  • 👍 9
  • 👀 6
  • ❤ 2
  • 💯 1
Post #5205 3.08K
Изучил я пока предварительно технический отчёт по MiMo V2.6. Основной прорыв вендора в кардинальном ускорении Reinforcement Learning за счёт обучения крупными блоками данных. Поэтому они быстрее и дешевле учат модели.

Однако если сравнить MiMo V2.6 и DeepSeek V4.1, то тут есть «тревожный звонок» архитекторам LLM в Сбербанке и Яндексе: начав копировать модный китайский гибрид GPT + Delta State, они могут проиграть с треском конкуренцию Flash-моделям китайцев. Просто всем и так понятно, что даже если вы возьмёте с Hugging Face архитектуру Kimi K3 и запустите обучение в наших условиях, то у вас не выйдет копия Kimi K3. У наших намного меньше ресурса GPU, и на Hugging Face не лежит описание пайплайнов обучения. В реальности Сберу и Яндексу хоть даже не догнать DeepSeek V4.1 и MiMo V2.6, а сделать хотя бы ситуацию, чтобы отставание не выглядело уже неприличным образом, как сейчас. Китайские «флешки» умеют и программировать, и быть сложными агентами, а наши LLM — нет. Так вопрос в том, что обе эти «флешки» у китайцев не используют гибрид GPT + Delta State. Они сидят на доработанном GPT. У DeepSeek доработка сделана через CED, у Xiaomi не так радикально: на доработанном обычном GPT комбинациями глобального и оконного (SWA) внимания между слоями.

Тут как бы не вышло, как в известном меме Матвиенко «копали не туда» (про туннель Метростроя в Питере, который ушёл не туда, а стоил кучу денег).

https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL/blob/main/MiMo_V2_6_technical_report.pdf
  • ✍ 20
  • ❤ 4
  • 👏 3
  • 👍 2
Post #5204 3.25K
Xiaomi выпустила новую модель. По бенчмаркам типа DeepSWE претензия пошатнуть лидерство DeepSeek V4.1 в worker-агентах есть, т. к. модель не менее умна, но Xiaomi развязывает ценовую конкуренцию 🚩

* MiMo-V2.6-Flash: $0.14 / $0.28 за млн input/output
* DeepSeek V4.1 Flash: $0.15 / $0.60 за млн input/output

Кэширование примерно одинаково стоит, если использовать DeepSeek Harness, то там норма попадания от 95%.

Вполне вероятно, что стоит сменить модель для worker-агентов, хотя оплата из России через текущие «сложные международные отношения» скорее будет некоторым квестом.

Кто тестировал и как платили — делимся в комментах.

Вендор ещё сделал научную публикацию о своих прорывах, сейчас посмотрим.

https://mimo.xiaomi.com/mimo-v2-6
Xiaomi MiMo-V2.6 | Xiaomi Introducing the MiMo-V2.6 series: frontier intelligence, all the modalities, built in public.
  • 👍 27
Post #5203 3.2K
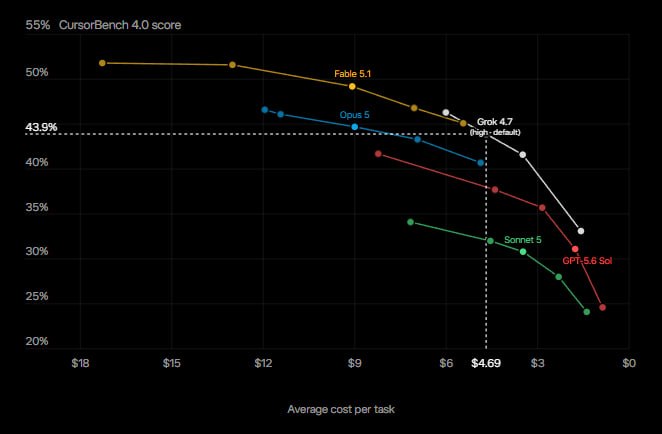
🤖 Вышел Grok 4.7, но скорее никакого переворота у Маска не получится, т.к. его аргумент, что у меня «чуть хуже Fable, но дешевле» на деле скорее не сработает.
Дело в том, что сейчас профессионалы имеют обычно пайплайн из фронтира (Fable, Astra) и worker-модели (обычно DeepSeek V4.1 сейчас). Фронтиры реально потребляют только 10% токенов для сложных решений, если пайплайн настраивал профессионал, поэтому цена их не так критична, как IQ. Практически Маск скорее будет бодаться сейчас с Kimi K3 и Qwen 3.8 Max в довольно узкой нише, кто тут реально ищет компромисс. Она актуальна для России, где завтра РКН может переломать все VPN и VPS, поэтому придётся в темпе вальса спрыгивать с Claude и ChatGPT, но для остального мира нет такого риска.

Надо подождать ещё результат LM Arena для окончательной оценки, может Grok фронтиры хорошо рисует.

https://x.ai/news/grok-4-7
  • ✍ 20
  • ❤ 7
  • 💯 2
Post #5202 3.13K
🤖 Честно говоря, даже и не знал, что у Сбера тоже есть T5, т.к. никто ими не пользуется из клиентов на обучении, а у меня это сотни специалистов. Правда, анализ AliceAI-T5-35B-A0.6B (Яндекс), google/t5gemma-2-4b-4b, FRED-T5-1.7B (Сбер) и FRIDA (Сбер) быстро пояснил почему.

У Yandex MoE и нагрузка на GPU только от 0.6B параметров, у Сбера модели хотя и крошечные, но нагрузка выше. Правда, потенциально можно делать LoRA для dense, но по параметрам модели видно, что она настолько глупая, что вряд ли это получится практически. Крошечный контекст 512 токенов у Сбера и обучение всего на 300GB корпуса текстов фактически делают модель неконкурентной против решений Yandex и Google в T5.

📌 Как обычно, можете не согласиться со мной в комментариях, мы обсуждаем сейчас в чате «Православные ИИ», т.к. в госсекторе какие бы они плохими ни были, но будут применяться именно они в итоге.
  • ✍ 17
  • 👍 7
Post #5201 3.03K
🔍 В чате мне написали коллеги, что Yandex занимается тоже энкодер-декодер нейросетями, но это не аналог Causal Encoder-Decoder (CED) у DeepSeek-V4.1-Flash, а это копия очень старой, но живой архитектуры Google T5, которая впервые была опубликована американцами в статье «Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer» в 2019 году.

Однако архитектура живая, хотя и нишевая. Аналогом AliceAI-T5-35B-A0.6B является тут Google t5gemma-2-4b-4b. Такие нейросети применяют Encoder на BERT, который не понимает причинно-следственных связей полностью и часто реагирует на вопрос как на «мешок слов». У DeepSeek энкодеры называются Causal Encoder именно потому, что там маскированное внимание как у классических трансформеров, поэтому там энкодер понимает уже сложные причинно-следственные связи.

Архитектура T5 тем не менее может работать для поисковых запросов, но почти всегда потребуется вам дообучать модель для эффективного использования. Однако они маленькие. Хотя dense-модель у Google тут выигрывает по простоте создания LoRA, поэтому они и не стали делать MoE как Yandex. Поскольку LoRA часто не сделать для MoE вообще, то у Yandex скорее надо хитрить промптами через ICL.

Реальные сценарии обычно:
🔹 Маршрутизация запросов (Query Routing). Иными словами, у вас N поисковых агентов по темам, а T5 решает, кому откинуть запрос.
🔹 Переформулирование запроса (Query Rewriting). Например, юзер пишет запрос обычным языком, а модель переводит в SQL или язык запроса к вашему API.

Хотя LoRA по модели Yandex сделать затруднительно из-за MoE, но благодаря ему модель даёт экстремально низкую нагрузку на кластер из GPU.

UPDATE. У Сбера вроде есть SberDevices FRED-T5. Надо посмотреть.


https://huggingface.co/yandex/AliceAI-T5-35B-A0.6B
https://huggingface.co/google/t5gemma-2-4b-4b
  • ✍ 11
  • ❤ 4
  • 👍 2
Post #5200 4.32K
Яндекс выпустил AliceAI-Foundation-80B-A3B-Base, решив таки начать обучать модели от нуля. Это на деле серьёзный удар всей стратегии Сбера по продвижению GigaChat в «закрытые контуры», которая вся крутится вокруг утверждения в духе: злые враги наверняка при обучении модели заложили в LLM зловредного агента, он, получив сигнал врагов, проснётся и захватит власть в России через правительственные системы. Правда, почему-то в таких мантрах коллеги GigaChat использовали дистилляцию Gemini и ChatGPT, как я уже отмечал по работе Anthropic — дистилляция тоже скрыто передаёт предпочтения учителя, типа либеральных взглядов. Яндекс ранее использовал Qwen для инициализации весов. Получается, в рамках маркетинга Сбера, что правительственного ИИ-агента в России контролирует Трамп, то это лучше, чем Си Цзиньпин. Вот в этом я не уверен. Однако на многих чиновников «суверенное обучение» всё равно производило впечатление, и Яндекс решил разрушить вообще фундамент стратегии продвижения конкурента в госсектор. И надо сказать, что судя по бенчам и архитектуре, Яндексу это уже удалось.

Для начала Яндекс и Сбер стали копировать довольно передовые архитектуры китайцев на гибридах GPT и Delta State, благо что у китайцев всё открытое. Однако Яндекс стал копировать архитектуру Kimi K3 прямо с их Kimi Delta State, что значительно превосходит архитектуру Сбера. Это таки фронтир, который с Fable сражается на равных. Правда, для Яндекса и Сбера проблема в неожиданном асимметричном архитектурном ответе DeepSeek V4.1 Flash, который отказался от модного гибрида и вместо этого фактически переосмыслил понятие трансформера и предложил GPT, где половина слоёв нейросети формирует понимание контекста, а вторая половина совместно ими пользуется — Causal Encoder-Decoder (CED). Фактически CED в нише worker-агентов уже порвал всех на тряпки: в шлюзе Vercel, как я публиковал их статистику ранее, даже американцы более 50% инференса (вообще по всем моделям!) заказывают у DeepSeek. Иными словами, Яндекс и Сбер, побежав копировать «мейнстрим» китайцев, возможно, зашли в технологический тупик, если CED продолжит лидировать как архитектура во Flash-моделях.

Ну да ладно, забавнее совсем другое. Я стал сравнивать, какой же «Истинно Православный ИИ» лучше по бенчмаркам. Всё же даже Президенту России надо выбрать себе агента. Тут оказалось, что поскольку у Яндекса и Сбера не получается, чтобы бенчмарки были хороши везде, то они публикуют только те, где результаты нормальные. В результате получается анекдот, что бенчей много, а сравнить AliceAI-Foundation-80B-A3B-Base и GigaChat3.5-432B-A28B-Reasoning можно только по LiveCodeBench и IMO AnswerBench. Однако после этого русский ИИ-цирк стал ещё веселей.

Вообще-то Сбер раструбил на весь интернет, что у него там теперь взрослый Reinforcement Learning и даже CoT, теперь Reasoning даже есть. Яндекс опубликовал Base-модель, где только обучение по корпусу, классически для Base не ведётся SFT обычно и совсем не ведётся Reinforcement Learning. Однако базовая (!) модель Яндекса оказалась сильнее модели Сбера (на больших весах, с CoT, RL и дистилляцией из Gemini/ChatGPT) в математических задачах — IMO AnswerBench.

По качеству первичной генерации кода на Python модели практически равны в LiveCodeBench.

Давайте прямо скажем, это катастрофа для Сбербанка в госсекторе. Довольно хорошо видно, что GigaChat имеет настолько слабое RL-обучение, что даже не может перебить Base-модель у Yandex. Модель Яндекса меньше и требует меньше ресурса GPU (сразу же на гостендере убивает Сбер просто по цене оборудования). Аргумент Сбера, что у него «истинно православное обучение с нуля», уничтожен Яндексом, т.к. они тоже обучаются теперь с нуля.

На самом деле Грефу уже давно пора делать оргвыводы в команде GigaChat, если он не хочет, чтобы Яндекс его выдавил даже из госсектора. Безусловно, коллеги имеют право не согласится с моими выводами и написать в комментах это.

https://huggingface.co/yandex/AliceAI-Foundation-80B-A3B-Base
https://huggingface.co/ai-sage/GigaChat3.5-432B-A28B-Reasoning
  • 🔥 32
  • ❤ 13
  • ✍ 11
  • 👍 7
  • 🏆 4
Post #5199 3.75K
🖼 Я протестировал новый Qwen-Image-2.1 для редактирования фото. Модель реально неплоха с учётом того, что влезает в бюджетные карты. В блоге Qwen показаны тестовые сценарии с традиционными комбинациями типа «одеть одежду на героя» или «собрать несколько людей с разных фото вместе». Это не сложно для нейросетей-редакторов изображений, куда сложнее «переставлять части тела».

Один из востребованных сценариев — «замена головы» в готовый сюжет. Однако вписаться органично тут сложно моделям. Часто переходы грубые или модель вообще отказывается вписывать голову и придумывает свою. Qwen-Image-2.1 просто так не впишет хорошо, но таким промптом на «четвёрку» точно работает и довольно стабильно:

Replace the face of the person in the first image with the face of the person in the second image.
Replace the skin color of the person in the first image with the skin color of the person in the second image.
Preserve pose of the first image. Use only the identity and facial features of the person from the second image.
Use correct body and head proportions.


По качеству определенно лучше обычных Face-адаптеров Comfy. Несколько уступает Krea2 Identity Edit в качестве, но в части стабильности отработки промптов выигрывает.

Модель кодирует промпт через qwen3_vl_8b, для него есть вариант без цензуры и в NVFP4. Правда удалять цензуру у Qwen особо и не нужно — её и так почти нет, я на примере MiniMax H3 пояснял политику китайцев. Разве что скорость и выигрыш в VRAM.

Для большинства бытовых сценариев и там, где премиум-качество не требуется, можно уже отказаться от облачных вариантов редактирования изображений.

https://qwen.ai/blog?id=qwen-image-2.1

Файлы для скачивания:
https://huggingface.co/Comfy-Org/Qwen-Image-2.1/resolve/main/diffusion_models/qwen_image_2.1_int8_convrot.safetensors, 7.26 ГБ
https://huggingface.co/Comfy-Org/Qwen-Image-2.1/resolve/main/text_encoders/qwen3vl_8b_int8_convrot.safetensors, 9.35 ГБ
https://huggingface.co/Comfy-Org/Qwen-Image-2.1/resolve/main/vae/qwen_image_2.1_vae_bf16.safetensors, 0.68 ГБ

Версия энкодера в качественном NVFP4-квантовании без цензуры:
https://huggingface.co/SergiusFlavius/Qwen3-VL-8B-Instruct-heretic-NVFP4/resolve/main/qwen3_vl_8b_nvfp4_full.safetensors, 6.31 ГБ
qwen.ai Qwen offers comprehensive functionality spanning chatbot, image and video understanding, image generation, document processing, web search integration, tool utilization, and artifacts.
  • 👍 26
  • ❤ 11
  • 🏆 2
Post #5198 4.06K
Давайте покажу вариант китайской ботофермы на ИИ, которая с "пальцем". Пока это для внутреннего китайского рынка больше, т.к. там жестче стали проверять социальные сети "натуральность нажатий" и признаки ПО для эмуляций.

Тут все проверки бесполезные. Тут вообще смартфоны БЕЗ ИЗМЕНЕНИЙ. Манипулятор ИИ робота проходит обучение на нейросети как человек нажимает и листает.

В наше время нужно понимать, что организовать социальные ботофермы вопрос денег и довольно небольших благодаря китайскому лохотрону.
  • 🤯 35
  • 👍 19
  • 🤩 7
  • ❤ 2
Post #5197 3.34K
🤖 Кто не видел, как выглядит китайская ботоферма, которая продаёт подписки и лайки, то вот её средний вариант. Начинали китайцы с того, что покупали просто б/у смартфоны и в подвале подключали их через USB на общую шину. Там ставили ПО для захвата экрана и эмуляции нажатий. Начинали с алгоритмических ботов, потом перевели их на ИИ.

Средняя ботоферма в КНР уже технологичнее, как на видео. Она не покупает старые смартфоны, а покупает тысячи ультрабюджетных смартфонов. Их сразу же в подвале разбирают, выкидывают экран и аккумулятор, оставляют только плату для эмуляции Android.

С этим борются в социальных сетях, но больше сами китайцы как основные поставщики лохотрона. Они смотрят, нет ли странных таймингов нажатий, пытаются понять «физику человеческого нажатия». Поэтому сейчас китайские ботофермы постепенно мигрируют на своём рынке уже на роботизированный вариант. Там не гуманоид, конечно, но специальный манипулятор с одним пальцем бегает и листает/лайкает. Обычно один "палец" обслуживает порядка 25-50 смартфонов.

Просто китайцы сейчас больше продают ботофермы «дуракам европейцам и американцам».
  • 🤯 27
  • 🔥 12
  • 👍 5
  • ❤ 3
  • 💯 3
Post #5196 2.97K
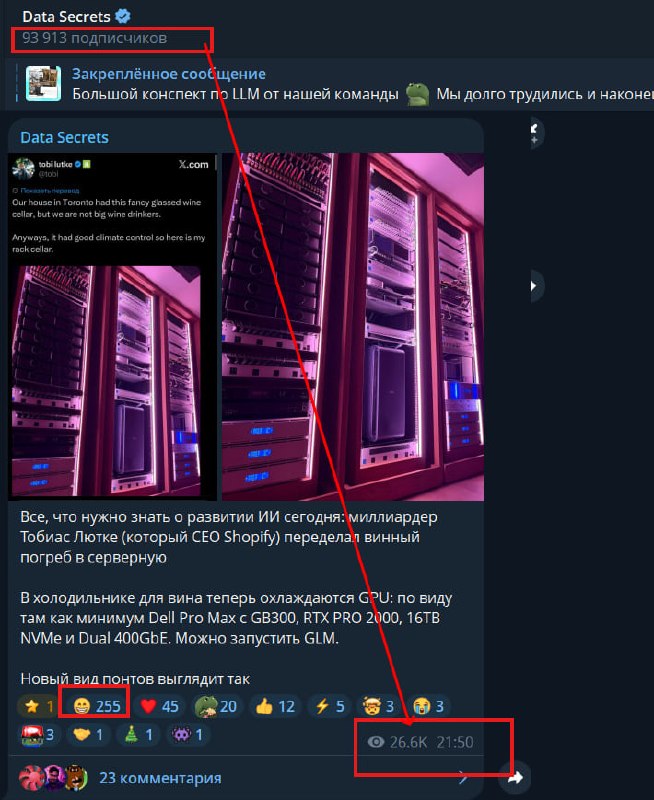
📊 Сделаю пост скорее для маркетологов, которые размещают рекламу в Telegram-каналах по тематике ИИ и становятся жертвами мошенников, создавших ИИ-каналы на ботах. Как раз пример такого мошеннического ИИ-канала у нас в чате обсуждается. Ботоферма была создана специально, чтобы обмануть персонал отдела маркетинга для размещения рекламы. Фактически, разместив там рекламу, вы оплачиваете содержание роя ботов. Опознать мошенников с ботами можно через нарушение ratio-метрик каналов, т.к. здоровых соотношений между разными социальными метриками. Если они нарушены, то вы платите за стойки со смартфонами в китайском подвале, где боты эмулируют нажатия в интерфейсе Telegram. Я не раз постил видео, как выглядят эти китайские ботофермы для накрутки подписок, просмотров и лайков.

Первое, за чем вам нужно следить — это ratio «просмотры поста / подписчики». Возьмём мой канал или пример канала Data Secrets, где здоровая аудитория и владелец не накручивает просмотры. Хорошо видно, что в ИИ-тематике примерно 20% просмотров должны быть от числа подписчиков. Если вы видите канал на 2,5 миллиона подписчиков (ха-ха), но там только 2% ratio просмотры/подписчики — это мошенники. Просто тут вопрос денег на содержание ботов. Боты для подписок самые дешёвые, их можно сделать вообще алгоритмически, и они делают действие один раз. Поскольку владелец ботофермы исходит из того, что маркетологи — идиоты, то накручивает подписчиков для пыли в глаза нереалистично.

Однако «боты активности» стоят намного дороже "ботов-подписоты". Все социальные сети тут имеют механизмы защиты от них, поэтому требуется уже чаще ИИ-бот, чтобы он сам кнопочку нажимал на смартфоне с помойки в стойке в китайском подвале, плюс более-менее осмысленно к посту. Такие боты дорогие, и за них надо платить постоянно. Поэтому и рушится ratio просмотры/подписчики или лайки/подписчики.

Второй аспект — следите за активностью в комментариях. Если их много и там много реакций, как у меня или у Data Secrets, то это настоящие живые сообщества. Если комментариев очень мало и мало реакций на них — вы на ботоферме. Просто боты для лайков на посте и для просмотров уже владельцу ботофермы «в копеечку» влетели, а платить за активность ещё в комментариях у него денег не хватает. Плюс боты для комментариев ещё дороже ботов-лайкателей или ботов-смотрунов, т.к. LLM требуют и довольно качественную.

Дорогие маркетологи, вас некоторые ботоводы считают дебилами, которых можно развести на деньги. Используйте контрольные ratio-метрики до того, как размещать рекламу в Telegram-каналах.

Передайте своим маркетологам, чтобы они не жгли ваши деньги на рекламу на ботах.
  • ✍ 20
  • 👍 15
  • 💯 6
  • ❤ 4
Post #5195 2.99K
Вероятно, у меня в данный момент самый крупный охват социального канала по ИИ-тематике в России за счёт мощного буста новой нейросети рекомендаций VK.

Хотя каналы в Telegram по ИИ, которые ведутся давно, имеют около 100К подписчиков, но просмотр постов не поднимается выше 20К даже на лояльной аудитории обычно. У меня сейчас VK даёт 4,4 миллиона просмотров в месяц с охватом почти 560 тысяч человек, что делает старые каналы по ИИ в Telegram гномами на моём охвате. Дело в том, что подписчики сейчас в VK не основные читатели канала: нейросеть VK, если признаёт контент ценным и замечает ещё положительные реакции (длинное чтение, обсуждение и т.п.), то сразу же переходит в turbo-режим его распространения. Поэтому у меня также средний просмотр поста около 20К, но виральные обычно намного больше — в 50–100К просмотров.

Это без учёта Telegram, LinkedIn и YouTube.

У меня основная миссия — продвижение ИИ-компетенций в массы, продвижение моих услуг и продуктов вторично. Если заметили, я на них даже особо не акцентируюсь. Поэтому если у вас есть ценный кейс ВНЕДРЕНИЯ ИИ в известной компании, то я расскажу о нём бесплатно. Не интересны продукты без внедрений — это моя позиция. Сначала докажите, что это работает на примере клиента. Если у вас есть хороший кейс продукта в ИИ, напишите в личку.

https://vk.ru/turboplanner
  • 🏆 40
  • 👍 19
  • ❤ 11
  • 🔥 2
Post #5194 2.95K
Многие эксперты считают, что данные AI Gateway от Vercel более репрезентативно показывают состояние рынка ИИ сейчас, чем OpenRouter. Видно, что китайцы выигрывают в плане контроля над рынком в токенах, а американцы — в деньгах.

Сейчас модели с открытыми весами составляют 78,4% от объёма токенов, по сравнению с всего 21,6% для закрытых моделей, в то время как открытые модели представляли примерно 40% объёма токенов в июне, что означает, что их доля почти удвоилась всего за три месяца.

DeepSeek V4.1 Flash в одиночку генерирует 59,3% токенов, проходящих через шлюз, а в сравнении с Claude его Opus 4.8 генерирует всего 1,7% объёма токенов.

Однако данные о расходах рассказывают совсем другую историю. Закрытые модели всё ещё захватывают непропорционально большую сумму денег за свои токены. Claude Opus 4.8 составляет 13,7% расходов, несмотря на то что представляет всего 1,7% объёма токенов, в то время как пять перечисленных моделей Claude от Anthropic в совокупности захватывают 36,9% общих расходов. DeepSeek V4.1 Flash имеет противоположный профиль: он обрабатывает большинство токенов на шлюзе, но составляет всего 5,1% расходов.

Важный момент: китайские модели не работают в убыток. Уровень маржинальности китайских моделей выше американских. The Information указывает, что маржа DeepSeek 70–80%. Для сравнения у Claude — 50%. Причём если вычесть затраты на обучение, как указывает Дарио. Однако тут тоже сильно изменён спектр расходов. Известно, что китайским моделям нужно всего несколько миллионов долларов на обучение их LLM на готовых датасетах. Последний пример — обучение новой модели Xiaomi в прямом эфире, которое я публиковал ранее (https://mimo.xiaomi.com/rl/). Там хорошо видно, что Pro-модель по аренде GPU обучается за несколько миллионов долларов всего. Это немыслимая для американцев эффективность обучения и инференса моделей.

Тем не менее OpenAI и Anthropic смогли создать устойчивый бизнес «тяжёлых фронтиров», которые принимают самые сложные проектные решения. Многие эксперты в X сейчас уже отказались от американских моделей для worker-агентов, но пишут что-то в духе: «DeepSeek у меня 90% потребления токенов, а Claude только 10%, но 90% реальных решений, которые мне принесли деньги, делает Claude».

Важный аспект: китайцы, оккупировав уже массовый рынок «рабочих агентов», уже успешно проникли даже в ключевых клиентов Anthropic и OpenAI. Корпоративу ещё важно поставить LLM локально, чтобы Альману и Дарио не сливать все свои секреты.

Однако вряд ли китайцы дадут возможность американцам спокойно чувствовать себя в сегменте тяжёлых моделей после разгрома американцев в бюджетных LLM. Скорее всего, мы сейчас увидим снова набеги тяжёлых китайских LLM в духе Kimi K3 или Qwen 3.8 Max, которые будут оспаривать самые топовые модели OpenAI и Anthropic.

Из ближайших тяжёлых моделей ожидается выход DeepSeek V5. По слухам в X Лян Вэньфэн решил назвать DeepSeek V4.1 с пересмотренной концепцией трансформеров лишь «4.1», чтобы не портить имидж «пятёрки», которая должна побороться с Astra и Fable. Посмотрим, что у него выйдет.
  • ❤ 25
  • 👍 12
  • 🔥 1
Older posts →

About this channel

How can I read @turboproject without a Telegram account?
TGViewer shows the public web preview Telegram publishes for AI Projects: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does AI Projects have?
AI Projects (@turboproject) has 11.2K subscribers on Telegram, refreshed roughly every 30 minutes.
Does AI Projects know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →