TGViewer
Channel Public Channel
CV Time

CV Time

@timeforcv

Канал о компьютерном зрении от ml-специалистов Яндекса: разбор актуальных статей, горячие обсуждения и личный опыт из первых рук. Присоединяйтесь!

Вопросы и предложения > @yandex_ml_brand
Subscribers
3.48K
Photos
262
Videos
6
Links
142

Showing posts older than #257 · Back to latest

Older Posts 13 shown
Post #256 1.47K
Enabling Disaggregated Multi-Stage MLLM Inference via GPU-Internal Scheduling and Resource Sharing

Сегодня разбираем статью, о том, как ускорить мультимодальный инференс, особенно когда на вход подаётся длинное видео.

Проблема складывается из нескольких факторов. MLLM становятся всё популярнее, мы хотим обрабатывать текст, картинки, видео, — но сервинг таких моделей очень дорогой. Нужно одновременно хорошо утилизировать GPU и быстро отдавать пользователю ответ. А с видео всё становится ещё хуже — препроцессинг долгий, особенно для длинных роликов. В итоге страдают TTFT (time to first token) и TBT (time between tokens).

Если в обычных LLM у нас есть prefill и decode, то в MLLM добавляются ещё две тяжёлые стадии до генерации:

- decoding видео и изображений,
- vision encoding (ViT / SigLip).

Отсюда две ключевые проблемы.

1) Видеодекодирование сильно увеличивает TTFT. CPU-декодинг плохо масштабируется, а GPU-декодеры обычно оптимизированы под throughput, а не под latency одного запроса, нам важно чтобы пользователь быстро получил ответ на свой запрос.

2) Vision encoder. Это отдельная compute-heavy-стадия, которая конкурирует за GPU с decode-частью и из-за этого увеличивается TBT. Просто вставить её в обычный пайплайн нельзя, так как начинаются конфликты за ресурсы.

В статье авторы по очереди решают эти проблемы.

FlashCodec

Главная идея — распараллелить одно видео на несколько GPU, а не просто обрабатывать разные видео параллельно. Видео хранится не как набор независимых кадров, а как compressed bitstream, разбитый на GOPs (Group of Pictures). Внутри такой группы кадры зависят друг от друга, но сами они между собой независимы.

Отсюда решение FlashCodec: видео делим на GOPs, распределяем их по GPU, внутри группы картинок декодируем последовательно, а между ними получаем параллелизм.

Дополнительно вводят stall-free scheduling — видео больше не рассматривается как одна задача. Планирование идёт на уровне GOP, и как только NVDEC освобождается, ему сразу отдаётся следующий GOP.

Ещё важный момент — память. В обычных системах при асинхронном декодировании память под кадры резервируют заранее, из-за чего легко можно упереться в OOM. Здесь же запрос принимают, ставят в очередь, декодируют и только после декодинга на ранке аллоцируют GPU-память под результат.

В итоге FlashCodec ускоряет обработку длинного видео и снижает TTFT.

UnifiedServe

Вторая проблема — конкуренция encode/prefill и decode за GPU. Тут есть два стандартных подхода.

1) Monolithic, когда все GPU в находятся одном runtime. Утилизация высокая, но encode начинает мешать decode, из-за этого растёт TBT.

2) Split, когда GPU жёстко делятся между encode/prefill и decode. Decode защищён, но ухудшается утилизация и появляются дополнительные оверхэды, например KV-cache transfer.

Авторы объединяют лучшее из подходов в UnifiedServe. Пайплайн бьют на три независимых воркера — preprocessing, encode/prefill и decode — связывают их через буферы и передают данные не целиком, а чанками. Каждый воркер забирает их по мере готовности. Можно удобно передавать информацию при асинхронной работе.

Но остаётся конкуренция за GPU, поэтому добавляют оркестрацию: encode и prefill получают ограниченный «бюджет токенов» и не могут занять весь компьют, за счёт чего decode остаётся изолированным и при этом сохраняется общий пул GPU. Так одновременно улучшаются TTFT, TBT и утилизация.

На экспериментах решения выигрывают по latency и throughput по сравнению с существующими.

Разбор подготовил ❣ Андрей Теплов
CV Time
  • 👍 13
  • ❤ 9
  • 🔥 7
  • 🥰 1
Post #255 1.77K
VIBE: Visual Instruction Based Editor [1/2]

Сегодня приступим к разбору статьи об эдитинг-модели от коллег из Сбера. Вторая часть уже опубликована в канале @c_research, который ведёт Сергей Кастрюлин из Yandex Research.

Ключевая цель авторов — сделать небольшую и эффективную модель, которая будет быстро инфериться, дёшево учиться и решать задачу instruction-based image editing. То есть выполнять только указанное в инструкции действие (например, добавить шарф), не делая ничего лишнего (не меняя цвет лица, фон и так далее).

Модель выложена в опенсорс. Она быстрая и при этом действительно компактная, поскольку основана на эффективных базовых блоках — Qwen3-VL-2B-Instruct в качестве текстово-картиночного энкодера и Sana-1.5-1.6B в качестве диффузионного генератора.

Что касается качества генерации, мы провели внутренние замеры, по которым VIBE показала качество примерно на уровне опенсорсной Bagel.

Архитектура

Самое интересное в статье — это внутреннее устройство и обучение системы. Архитектура состоит из двух блоков:

- небольшой энкодер — Qwen3-VL на 2 миллиарда параметров;
- базовая диффузионка — Sana 1.5 на 1,6 миллиарда параметров.

Напомним, что Sana 1.5 — это работа Nvidia начала прошлого года, где авторы пытаются максимально дёшево обучить быструю диффузионку разумного качества. Нам она запомнилась стратегией переиспользования ранее обученной Sana 1 и тем, как реализован inference-time compute scaling. Авторы генерируют очень много изображений (до 2000 за время обычной генерации), после чего VLM выбирает лучшие — таким образом они «хакают» бенчмарки.

Как всё работает

1) VLM обрабатывает входное изображение и промпт. Это стандартная практика, но авторы отдельно подчёркивают, что считают важным выучивание связи между картинкой и промптом именно внутри VLM.

2) Отдельно для подачи в VLM обучаются MetaQueries — полезные добавки-суффиксы к исходному промпту, обогащающие входное представление без модификации весов VLM.

3) Для задачи редактирования в диффузионку важно как-то подать текстовый кондишен. В работе рассматриваются два способа.

Первый — трансформерный: изображение разбивается на патчи, получаются картиночные эмбеддинги, которые конкатенируются с текстовыми и подаются одной последовательностью.

Второй — более классический: поканальная конкатенация. Кондишен-картинка конкатенируется с шумом, из которого генерируется изображение. После этого всё подаётся в свёрточный слой увеличенной размерности.

С одной стороны, авторы пишут, что вариант с единой последовательностью работает лучше. Такой вывод не вызывает удивление, поскольку возможность одинаково обрабатывать картинки и тексты на входе — очень полезная фишка трансформерных моделей. Но в финальной системе авторы используют именно конкатенацию, потому что она не увеличивает длину последовательности и экономит время инференса.

То есть, имея диффузионный трансформер, авторы всё равно делают поканальную конкатенацию со свёрткой, а затем работают с патч-эмбеддингами свёрточных представлений. Это решение — довольно нестандартное.

Во второй части разобрали, как устроено обучение модели, зачем используются Meta Queries и какие данные применяются для тренировки.

Разбор подготовил ❣ Сергей Кастрюлин
CV Time
  • 🔥 9
  • ❤ 6
  • 👍 6
  • 👌 2
Post #254 1.38K
Xray-Visual Models: Scaling Vision models on Industry Scale Data

Сегодня разбираем статью, название которой может запутать — посвящена она не медицине, а новой vision-модели Meta*. Работа представляет собой не цельную историю, а набор экспериментов, местами слабо связанных между собой. Но зато даёт практический взгляд на то, как реально собирается большая модель.

Начинают авторы с данных. Основной источник — их собственные сервисы (Facebook*, Instagram*). Используются пользовательские изображения и всё, что к ним прилагается: хэштеги, эмоджи, тексты. Очевидная проблема такого источника — сильный перекос распределения. Популярные концепты встречаются намного чаще редких, и модель начинает переобучаться на них. Поэтому данные отдельно выравнивают по концептам и получают заметный прирост качества. Дополнительно фильтруют датасет через CLIP-подобную модель по порогу схожести.

Модель обучается не только на картинках, но и на видео. Теги пользователей приводят к каноническому виду и отображают в фиксированный набор классов (десятки тысяч концептов WordNet). Причём учитывают не только объекты, но и действия. Сэмплинг подбирают так, чтобы за одну эпоху полностью проходить и картиночный датасет, и видеодатасет. Оба имеют внушительные размеры: более 15 млрд изображений и 10 млрд видео.

Текстовые описания к изображениям генерируют своей моделью, но качество не идеальное — есть повторы, шум. Поэтому их просто переписывают с помощью Llama, что даёт небольшой, но стабильный выигрыш. К своим данным авторы добавляют данные с изображениями из интернета, собранными в рамках работы MetaCLIP.

Архитектурно модель представляет собой стандартный трансформер, адаптированный под видео с 3D-сверткой на входе. Любопытный момент: авторы активно выкидывают ненужные токены по аттеншну (ссылаются на статью EViT), и это экономит вычисления без существенной потери качества.

Обучение разбито на три стадии: сначала masked image modeling, затем классификация по тегам, и только потом CLIP-постановка. На финальном этапе добавляют self-supervised-компонент (SLIP), притягиваются разные аугментации одного изображения или кадры из одного видео.

Также в статье описано много мелких «бантиков»: регуляризация эмбедов через добавление шума и восстановление, Gaussian blur как аугментация, переход на Lion вместо AdamW. Каждый из них даёт доли процента — но таких улучшений много.

Интересен текстовый энкодер. Вместо классического BERT берут LLM и модифицируют её под задачу retrieval: переходят на full attention вместо казуального и дообучают на задачу предсказания близости текстов. Этот подход позволяет перенимать сильные стороны языковых моделей, такие как учет деталей и возможность работы с длинными текстами.

Результаты на академических бенчмарках выглядят хорошо: на уровне или выше SigLIP и DINO при более быстром инференсе, хотя сравнения местами не идеально выровнены. В продакшне прирост существенно больше — авторы отмечают, что стандартные бенчмарки не всегда информативны.

Есть и неожиданные наблюдения. Attention pooling и rotary embeddings не помогли. Сжатие эмбеддингов в предложенном авторами виде сильно портит качество (~4%), но ради скорости поиска они идут на это. Авторы отмечают, что их пайплайн не оптимален, если использовать эмбеды для поиска дубликатов: в таком случае лучше убрать тексты из обучения и использовать self-supervised-постановку.

В конце упоминается ещё один трюк — представление изображений через семантические ID, что уже ближе к рекомендательным системам.

В итоге можно сказать, что эта статья — о масштабировании данных и множестве маленьких инженерных улучшений, каждое из которых даёт небольшой прирост, а в сумме позволяет получить SotA-результат.

Разбор подготовил ❣ Артём Конев
CV Time
___
Компания Meta, владеющая Facebook и Instagram, признана экстремистской; её деятельность в России запрещена.
  • ❤ 9
  • 👍 9
  • 🔥 8
Post #253 1.76K
EMMA: Efficient Multimodal Understanding, Generation, and Editing with a Unified Architecture

Сегодня разбираем статью Huawei под названием EMMA. Это мультимодальная модель, которая одной архитектурой пытается решать задачи понимания изображений, генерации и редактирования. То есть объединяет image-to-text, text-to-image и image-to-image.

На вход подаются тексты и изображения. Картинки проходят через два энкодера.

Первый — это DCAE (Deep Compression Autoencoder). Он используется в генеративной ветке и сильно сжимает изображение.

Второй — SigLIP2 (конкретно SigLIP2-so400m), используется для семантического высокоуровневого представления изображений.

Важно, что оба энкодера дают одинаковый уровень сжатия х32. За счёт этого они могут объединять признаки не по токенам, а по каналам, не увеличивая длину последовательности.

После SigLIP2 применяют pixel shuffle, чтобы дополнительно уменьшить число токенов, а после DCAE — адаптер (MLP), чтобы привести размерности.

Для задачи понимания добавляют интересный механизм — mixture-of-experts в энкодере. Есть два эксперта: универсальный (versatile) и специализированный под STEM-задачи (графики, математика и прочее). Отдельный роутер решает, какому эксперту отправлять изображение. Если это STEM-домены – идём к специализированному, остальное — к универсальному.

Причём STEM-эксперт инициализируется из обычного и дообучается только на финальной стадии и только на соответствующих данных.

Архитектура включает две ветки:
- Und (understanding) – для понимания,
- Gen (generation) – для генерации.

На ранних слоях параметры QK-матриц шарятся, а потом ветки становятся полностью независимыми.

При этом взаимодействие между ветками происходит через глобальный self-attention.

Модель инициализируется из Qwen3-4B.

По лоссам всё стандартно: для понимания используют next-token prediction, для генерации — flow matching с velocity prediction.

В качестве данных используют смесь трёх типов:
- I2T (image-to-text) — для анализа изображений,
- T2I (text-to-image) — для генерации,
- IT2I (image editing) — для редактирования.

Глобально данные — комбинация открытых датасетов, внутренних данных и синтетики. Последняя активно используется для генерации и редактирования. Датасет GPT-Image-Edit-1.5M авторы исключили, сославшись на то, что он ухудшает subject consistency.

Обучение состоит из шести стадий:

1. Alignment — обучается только адаптер анализа изображений (Und), энкодеры заморожены.
2. Pre-training — обучаются всё, кроме DCAE.
3. Supervised fine-tuning — добавляются более качественные данные, плюс подключается editing.
4. Quality tuning (QT) — дообучение на отфильтрованных данных высокого качества.
5. STEM expert tuning (ET) — обучается только STEM-эксперт.
6. Router tuning (RT) — отдельно дообучается роутер.

На задачах стандартных VLM-бенчмарков модель примерно на уровне Qwen3-VL. Есть просадка на MMMU и рост на MathVista, вероятно, за счёт STEM-эксперта. НаGenEval модель демонстрирует более высокий prompt following, чем у Qwen-Image.

Пара интересных наблюдений.

- Модель умеет работать с китайскими инструкциями в генерации и редактировании, даже без T2I-данных на китайском — вероятно, это эффект knowledge transfer из I2T-данных.
- Хотя editing обучался на одношаговых инструкциях, модель обобщается на многошаговые инструкции (типа «замени очки, поменяй одежду, измени фон»).
В целом довольно аккуратная попытка собрать unified multimodal-модель.

Разбор подготовил ❣ Сергей Овчаренко
CV Time
  • 🔥 15
  • ❤ 8
  • ❤‍🔥 6
  • 👌 3
Post #252 1.73K
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [3/3]

Продолжаем разбирать большую статью о новой генеративной модели Z-Image. В первой части поговорили о пайплайне подготовки данных, во второй — о тонкостях обучения. А сегодня обсудим архитектуру модели и её обучение.

Авторы используют два картиночных энкодера: SigLIP2 и Flux-VAE и один текстовый — Qwen3-4B. Трансформер мультимодальный, диффузионный, Single-Stream. 3D-RoPE стандартное, не такое хитрое, как в Qwen Image.

Рассмотреть архитектуру модели во всех подробностях можно на схеме. Она довольно стандартная: состоит из Attention- и FFN-блоков c Gate и Scale. В кондишн из Scale-/ Gate-слоёв прокидывается только время.

На вход в диффузионную модель как обычно поступают латентны и эмбеддинги промпта. Эмбеддинги конкатенируются вдоль длины последовательности. В editing-режиме на вход также попадают эмбеддинги исходных изображений, полученные из двух картиночных энкодеров, — они также конкатенируются со всем остальным. То есть, на вход Z-Image подаётся вся информация, которая есть в запросе.

Говоря об обучении, хочется отметить несколько интересных особенностей. Претрейн начинается с text-to-image на изображениях низкого разрешения — 256х256. Так модель учат в общих чертах понимать, как устроены картинки. Авторы утверждают, что на эту стадию уходит почти половина времени: скорее всего, именно это сделало маленькую модель такой эффективной.

Далее следует omni-часть предобучения: к исходному датасету добавляют изображения произвольного разрешения, editing-данные и различные виды caption’ов.

После этого — SFT-стадия, где авторы стараются сбалансировать концепты. В процессе обучения для каждого из концептов фиксируется статистика его появлений в батчах. Веса картинок, представляющих разные концепты, перевзвешиваются при сборе следующего батча. Так модель изучает концепты более равномерно.

Для стабилизации модели ей устраивают несколько SFT-стадий, во время каждой из которых перебалансируют концепты в датасетах. Потом веса полученных моделей усредняют.

Потом модель дистиллируют при помощи модифицированного DMD, который авторы называют decoupled DMD. От оригинального он отличается тем, что стадии CFG-Augmentation и Distribution matching’а разделяют и оптимизируют отдельно.

В конце модель дообучают при помощи DPO и GRPO для максимального соответствия человеческим ожиданиям.

Проверенные решения в нетипичных комбинациях позволяют Z-Image показывать хорошие результаты при небольших затратах вычислительных мощностей. Познакомиться с моделью поближе можно на GitHub или HuggingFace.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
  • 🔥 10
  • ❤ 4
  • 👍 4
Post #250 2.04K
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [2/3]

Продолжаем разбирать большую статью о новой генеративной модели Z-Image. В первой части серии поговорили об инфраструктуре для обработки данных, а сегодня обсудим ошибки модели.

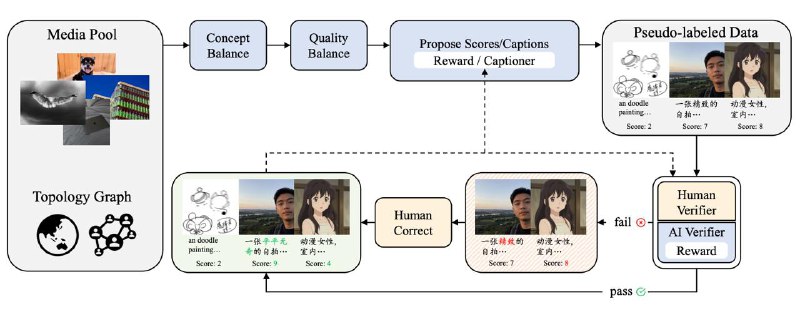
Во время обучения Z-Image авторы статьи столкнулись с тем, что модель некорректно выучивает сложные концепты. В качестве примера (первая схема) они приводят выражение 松鼠鳜鱼 — название блюда китайской кухни «рыба-белка»: когда модель пытается сгенерировать изображение рыбы-белки, она может решить что ей нужно нарисовать 松鼠(рыбу) и 鳜鱼(белку).

Чтобы бороться с такими случаями, авторы используют сложную систему курирования данных с vector engine и деревом концептов. После того как граф концептов подтверждает, что рыб-белок в датасете не хватает, надо найти хорошие примеры и показать их модели. Для этого в части датасета — например, той, что соответствует концепту «китайская еда», — ищут наиболее подходящие изображения с помощью vector engine и добавляют их в текущий батч обучения. А потом регулярно повторяют эту операцию во время обучения.

Подробнее рассмотреть общий алгоритм обогащения датасетов можно на второй схеме:

1. Из всего датасета выделяют подмножество изображений, соответствующих непредставленным концептам.
2. При помощи VLM модели присваивают им caption’ы.
3. Люди и VLM оценивают качество полученных семплов.
4. Отвергнутые семплы с некорректными подписями к картинкам правят люди.
5. VLM дообучается на результатах такой разметки на каждой крупной стадии обучения модели. После каждой итерации дообучения доля картинок, оцениваемых VLM, растёт. Условно, если на первой стадии модель проверяла всего 20% семплов, на последней — уже 50%.

Комбинация обоих описанных механизмов постепенно улучшает датасет.

Кроме классической text-to-image-задачи, авторы также обучают модель редактировать изображения. Чтобы подготовить данные для этого, используют несколько стратегий:

- Произвольно переставляют и комбинируют различные версии одного и того же входного изображения, отредактированные другими моделями: например, инпейнтинг или смена ракурса.

- Собирают пары изображений из видеокадров: берут два похожих и описывают разницу между ними в виде инструкции. Например, «перемести машину из города в деревню» для кадров с одной и той же машиной в разных локациях.

Генерируют синтетические данные с текстами — подбирают изображения, пишут на них разные тексты и генерируют инструкции вида «поменяй текст на картинке с "котик" на "собачка"».

Подробнее о том, как устроена архитектура Z-Image, расскажем в третьем посте.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
  • ❤ 9
  • 👍 5
  • 🔥 5
Post #249 1.77K
Z-Image: An Efficient Image Generation Foundation Model with Single-Stream Diffusion Transformer [1/3]

Сегодня начнём разбирать большую статью о новой генеративной модели Z-Image. В первом посте серии поговорим об инфраструктуре для обработки данных, во втором — об ошибках модели, в третьем — о её архитектуре.

Z-Image знаменита двумя вещами. Она:

- небольшая по современным меркам — около 6B параметров;
- весьма эффективно обучена: для тренировки использовали всего 314К GPU-часов на H800 GPU.

Пока авторы зарелизили только text-to-image-модель, но скоро обещают выкатить editing. Текущая версия уже впечатляет: иногда она ошибается в генерации текстов на изображении, но в среднем отлично справляется с этими и другими визуальными эффектами.

Таких результатов удалось добиться благодаря продуманному обучению и хорошей подготовке данных. Для того чтобы собрать качественный датасет, хорошо покрывающий разные домены, авторы настроили пайплайн из четырёх компонент:

1. Data Profiling Engine. Базовая фильтрация по качеству изображений — отсеиваются картинки со слишком высоким уровнем шума или чрезмерным объёмом фона, с артефактами компрессии и т. д.

Эстетичность картинки оценивает отдельная модель: она создаёт дополнительный атрибут aesthetic score.

Что касается caption:

- Пары «изображение + текст» с низкой похожестью фильтрует специально дообученный CLIP. Он возвращает коэффициент того, насколько картинка соответствует тексту (по шкале от 0 до 1). Таким образом датасет очищается от самых не подходящих друг другу пар.

- Чтобы обогатить caption, генерируют три его версии: очень подробную, детальную и короткую. Все три получают с помощью простой VLM. Далее их используют для прогрессивного обучения: постепенно повышают разрешение изображений и длину caption, чтобы модель познакомилась с миром изображений, поняла, как их генерировать, и усовершенствовала свои навыки.

2. Cross-modal Vector Engine. Нестандартный механизм, который проверяет, насколько хорошо датасет покрывает всё множество реальных пар «картинка + текст».

Верхнеуровнево это работает так: пары «картинка + текст» пропускают через энкодеры, получают их векторное представление. На всём множестве векторов строят индекс — далее его используют для дедупликации пар и аналитики.

3. World Knowledge Topological Graph. Для того чтобы оценить, насколько концепты реального мира представлены в датасете, используют необычный механизм. Строят граф: вершины — концепты, рёбра — их ссылки друг на друга. От маловажных концептов избавляются алгоритмом PageRank. Оставшимся точкам присваивают теги и группируют их в иерархические деревья. Такой граф позволяет балансировать датасет во время обучения, повышая вероятность у семплов, представляющих слаборепрезентованные концепты.

4. Active Curation Engine. Люди и VLM поочерёдно проверяют датасет, пока он не окажется достаточно хорошим.

Подробнее об ошибках Z-Image и том, как она устроена, расскажем в следующих постах.

Разбор подготовил ❣ Илларион Дмитриев
CV Time
  • ❤ 14
  • 🔥 7
  • 👍 4
  • ❤‍🔥 1
  • 🤩 1
Post #246 1.81K
OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference [2/2]

В первой части разбора рассказали о ключевых проблемах алайнмента VLM и гипотезах авторов. Дальше статья сводится к сбору данных. Вопросы и ответы генерируются через проприетарные модели, в основном GPT-4o. Самое интересное — как отбирают изображения и какие срезы задач выделяют.

Авторы хотят собирать open-ended-вопросы, не подразумевающие односложный ответ. Этим пытаются перенести в мультимодальный сеттинг часть навыков, которые обычно хорошо выучиваются из text-only-данных: креативность, генеративные запросы, более развёрнутые ответы.

По типам задач выделяют два основных среза:
1) общий (знания, ризонинг, генеративные сценарии),
2) инфографика.

У каждого среза — свой пайплайн. Сначала идёт фильтрация изображений: убирают самые простые картинки, оценивают визуальную сложность и стараются оставить те, где много объектов. Для этого используют внешние модели.

Дальше генерация стандартная: few-shot + промптинг GPT-4o для вопросов и ответов. Но на некоторых задачах few-shot работает хуже — там добавляют дополнительные приёмы, чтобы сохранить разнообразие.

Отдельно описана стадия рефайнмента. QA-пары усложняют и переписывают с помощью LLM, добавляя более строгие требования к форме ответа: ограничения длины, стиль, структура.

Ещё одна стадия — фильтрация QA-пар. На некоторых срезах, например в графиках, авторы считают, что даже GPT-4o недостаточно надёжна. Тогда используют ансамбль нескольких проприетарных и опенсорсных моделей, сравнивают ответы и либо мёржат, либо фильтруют, чтобы получить более качественную финальную пару.

В итоге удалось собрать около 200 тысяч QA-пар.

Бенчмарк MM-AlignBench

Существующие бенчмарки обычно проверяют только правильность ответа, когда есть ground truth, но не его качество в смысле human preference. Поэтому собирается отдельный небольшой бенчмарк — MM-AlignBench.

В качестве референса вспоминают попытки сделать VLM-арену, например, WildVision. И используют похожую идею оценки: сравнивают ответы моделей попарно и просят GPT-4o выступить судьёй. Получают вердикт по шкале из нескольких категорий (A лучше B, немного лучше или равны и в обратную сторону). Из этого считают win rate и reward.

Эксперименты и результаты

Дальше авторы проводят эксперимент на базе LLaVA-Next: заменяют часть исходных данных на свои новые данные OmniAlign-V и смотрят, что будет с метриками. На прокси-бенчмарках под human preference (WildVision и MM-AlignBench) метрики заметно растут. При этом классические мультимодальные бенчмарки не проседают критично. То есть human preference получилось улучшить, не убив привычные VLM-метрики.

На текстовых бенчмарках деградация всё ещё остаётся, но становится меньше. Если раньше просадка была около 50 пунктов, теперь стало около 30. Это всё ещё много, но разрушение LLM-навыков VLM стало слабее.

В итоге получился неплохой бенчмарк, который отражает другие аспекты качества по сравнению с тем, что обычно замеряют в мире VLM. Причём его не просто собрали, но и вывели на лидерборд — вопрос теперь в том, будут ли остальные игроки им пользоваться. Но сам интент двигать оценку в сторону human preference выглядит интересным и полезным.

Разбор подготовил ❣ Алексей Григорьев
CV Time
  • ❤ 10
  • 🔥 10
  • 👍 7
Post #245 1.84K
OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference [1/2]

Сегодня разбираем статью об алайнменте VLM, которую можно воспринимать как срез главных проблем в области и их решений. В первой части поговорим об основных узких местах, которые выделяют авторы.

1) Автометрики не отражают качество алайнмента полностью. Обычно для VLM его измеряют с помощью бенчмарков, где предполагается один правильный ответ: посчитать число объектов на картинке, ответить на простой вопрос в одно слово и прочее. Такие автометрики удобно считать, и они действительно проверяют базовые навыки модели, но многие аспекты качества VLM с их помощью не оценить.

2) Для VLM долгое время не было общепринятой «арены». Если для LLM была арена, которую знали, смотрели и репортили почти все, то для VLM она появилась не так давно.

3) Мультимодальный SFT портит текстовые способности LLM. Главное утверждение авторов: именно на этой стадии LLM внутри VLM сильно деградирует. Для проверки берут исходную LLM, измеряют на текстовых бенчмарках, затем делают мультимодальный SFT и снова измеряют получившуюся модель на тех же бенчмарках. В результате метрики заметно ухудшаются. Выдвигаются две гипотезы, почему это происходит.

Первая гипотеза: в мультимодальном SFT слишком мало text-only-данных. Если добавить их, возможно, просадка уменьшится. Для проверки берут датасет LLaVA-Next SFT с 40 тысячами текстовых примеров, многие из которых старые и некачественные. Эти примеры заменяют на более качественные, а затем масштабируют долю текстовых данных.

Результат получается контринтуитивный: текстовые метрики алайнмента действительно растут, но мультимодальные метрики падают как на арене, так и для базовых навыков. Таким образом, качество текстового алайнмента плохо обобщается на мультимодальный срез.

Вторая гипотеза: сами по себе мультимодальные данные слишком простые по сравнению с тем, на чём обучают LLM. Они плохо проучивают instruction following и качество ответа в разрезе human preference. Авторы приходят к идее собирать мультимодальные данные, которые по качеству и сложности ближе к задачам алайнмента под human preference.

Во второй части разбора поговорим о том, как происходил сбор данных, подробнее рассмотрим полученный бенчмарк и результаты.

Разбор подготовил ❣ Алексей Григорьев
CV Time
  • 🔥 18
  • 👍 12
  • ❤ 9
Post #242 2.52K
DeepSeek-OCR 2: Casual Visual Flow

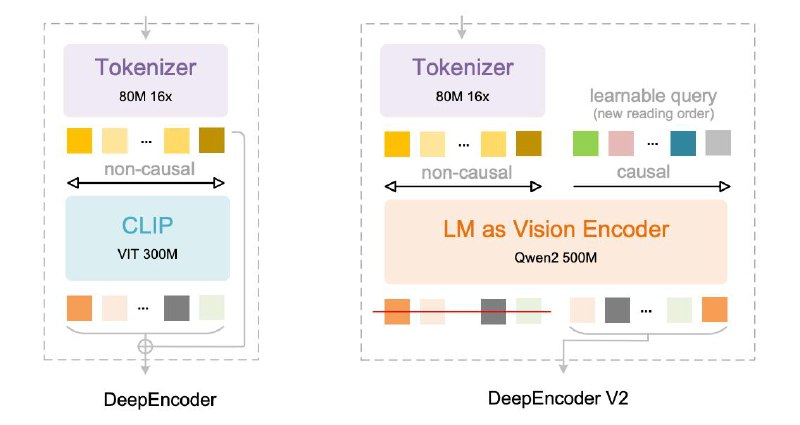
Сегодня разбираем статью, которая продолжает идею DeepSeek-OCR. Суть первой версии была в том, чтобы использовать глубокий энкодер на базе SAM и CLIP, а затем подавать токены в небольшой decoder-like-блок. Посмотрим, что нового предложили авторы.

Архитектура

Главное отличие от DeepSeek-OCR v1 в том, что вместо CLIP берут LLM (decoder-like-модель), а также добавляют обучаемые queries. Декодер при этом остаётся тем же.

В качестве визуального токенизатора используется SAM-base на 80M параметров. Дальше идут две свёртки, которые дают сжатие в 16 раз (каждая уменьшает размерность в два раза по каждой из осей). Сжатое представление подаётся в LLM. Токенизатор получается довольно компактным.

Авторы говорят, что теоретически можно было взять encoder-decoder-схему, как в mBART, но это плохо сходилось. И если не объединять всё в одну последовательность, не хватает взаимодействия между токенами, поэтому decoder-like-архитектура работает лучше.

Используются два режима подачи: 1024×1024 (256 токенов) у всего изображения целиком либо 768×768 для локальных кропов. Если документ небольшой, подают только целое изображение. Если документ большой, нарезают на локальные кропы и добавляют сжатое целое изображение.

Идея с обучаемыми queries

Авторы вдохновлялись двумя работами. Первая — DETR (2020) на тему детекции объектов. В ней картинку сначала прогоняют через ResNet и получают визуальные признаки, а затем делают кросс-аттеншн с набором object queries. Каждая query отвечает за потенциальный объект, и decoder-like-модель выдаёт предсказания по этим queries.

Вторая работа — BLIP-2. Это captioning-модель, в которой используется Q-former с обучаемыми queries. Они делают кросс-аттеншн к визуальным токенам из CLIP и передают уже агрегированное представление в LLM. В результате вместо сотен визуальных токенов в LLM передаётся компактное представление через queries.

Подход DeepSeek-OCR 2 во многом похож на Q-former, но здесь число query соответствует числу визуальных токенов.

LLM применяют, потому что они уже хорошо показали себя в инициализации для мультимодальных задач.

Данные

Авторы используют те же данные, что и для предыдущей версии. Чтобы модель не забывала общие визуальные представления, добавляют и обычную зрительную информациию, но распознавание текста преобладает. Распределение немного перебалансируют и делают небольшую доработку меток.

Обучение

Процесс обучения состоит из трёх стадий.

1) Encoder training: обучают только энкодер, а декодер заморожен. Смысл стадии — научить токенизатор и LLM работать как энкодер: извлекать признаки, сжимать токены и собирать представление.

2) Query enhancement: обучают энкодер и декодер вместе. Происходит донастройка их совместной работы.

3) Decoder specialization: замораживают энкодер и финально доучивают только декодер.

Результаты

Авторы замеряются на большом двуязычном (английский и китайский) бенчмарке OmniDocBench v1.5. Он содержит примерно 1400 документов разных категорий, включая журналы, академические статьи и отчёты.

В сравнении с бейзлайнами в новой версии чуть меньше токенов, то есть модель дешевле, но при этом общее качество выросло примерно на 4%. Больше всего улучшились срезы по формулам и таблицам. Также уменьшилась метрика Edit Distance, которая показывает, насколько распознанный текст отличается от эталона в документе.

Сравнение идёт с InternVL, Miner и другими OCR-специфичными подходами. По цифрам PaddleOCR-VL всё ещё выглядит чуть лучше.

В некоторых аспектах DeepSeek-OCR v2 есть куда расти — например, в задаче распознавания текста на газетах. Объясняют это тем, что на очень насыщенных текстом документах выбранные разрешения и степень сжатия могут мешать точному распознаванию, и для улучшения, возможно, нужно обучаться на большем количестве кропов.

В итоге авторам удалось получить решение, которое быстро, недорого и с хорошим качеством обрабатывает документы. Код и модель выложены в публичный доступ.

Разбор подготовил ❣ Денис Кузнеделев
CV Time
  • 🔥 13
  • ❤ 7
  • 👍 7
  • 🥰 1
Post #240 2.28K
When and why vision-language models behave like bags-of-words, and what to do about it?

Сегодня разбираем не новую, но актуальную статью об одной неприятной штуке: bags-of-words-ности CLIP. Другими словами, разберём ситуацию, когда VLM вроде бы должна понимать смысл, порядок и отношения между объектам, но на деле ведёт себя так, будто текст — просто набор слов без структуры. Авторы пытаются выяснить, когда и почему VLM начинают работать как BoW, и можно ли это исправить.

Для этих целей собрали специальный бенчмарк ARO (Attribution, Relation, and Order), который тестирует три вещи:

1) понимает ли модель отношения между объектами (“horse eats grass” vs “grass eats horse”);
2) различает ли она атрибуты (“paved road” vs “white road”);
3) чувствительна ли к порядку слов.

На примерах из Visual Genome делают простой тест: берут картинку и две подписи — правильную и с переставленными словами. Модели должны выбрать корректный вариант, но на графиках видно, что не все уверенно проходят даже порог случайного угадывания — 0,5. Например, Flava в некоторых настройках вообще чаще выбирает неправильные подписи.

Чтобы расширить тесты, добавляют данные из COCO Order и Flickr Order. Там уже не просто меняют местами два слова, а делают несколько видов искажений:
перемешивают существительные и прилагательные, перемешивают почти все слова, перемешивают слова внутри триграмм. Получается набор, где рядом стоит оригинальный текст и несколько сломанных вариантов. И снова видно, что многим моделям всё равно, в каком порядке стоят слова.

Можно ли обучить CLIP как BoW?

Дальше проверяют, что будет, если обучить CLIP так, чтобы текстовый энкодер вообще не видел порядок слов. Текст подают как bag-of-words и смотрят retrieval-метрики. Результат печальный: качество падает совсем немного. То есть модель можно обучить на беспорядочных текстах, и она всё равно будет работать почти так же. Это подтверждает идею, что CLIP-подобные модели часто не используют синтаксис и порядок, а просто ловят совпадения слов.

Эксперимент с картинками

Авторы делают похожий тест и для визуального энкодера: режут изображение на патчи 3×3 и перемешивают. Качество падает сильнее, но всё равно остаётся приемлемым. То есть даже порядок визуальных частей модели часто не критичен.

NegCLIP как решение

В качестве способа исправления авторы предлагают NegCLIP. Идея в том, что стандартный contrastive learning слишком легко проходит на поверхностных совпадениях, поэтому нужно добавлять более жёсткие негативы.

Вводят два типа таких негативов:

1) srong alternative images — самые похожие картинки по эмбеддингам CLIP, которые добавляются как сильные негативы;
2) targeted negative captions — подписи, где слова специально переставлены или подменены.

По итоговой диаграмме видно, что NegCLIP заметно улучшает результаты на VG-Relation, VG-Attribution, COCO-Order и Flickr-Order, то есть там, где проверяется не просто совпадение слов, а структура.

В итоге работа показывает, что многие VLM действительно ведут себя как BoW: им часто всё равно, кто кого ест и в каком порядке стоят слова. Но этот эффект можно ослабить, если в обучении использовать сложные негативные примеры, как в NegCLIP.

Разбор подготовил ❣ Фёдор Притула
CV Time
  • 🔥 18
  • 👍 10
  • ❤ 7
Post #238 1.94K
Emu3.5: Native Multimodal Models are World Learners

Сегодня разбираем работу от команды китайского Института искусственного интеллекта, которая продолжает гнуть свою линию и выкатывает очередную модель семейства Emu. На этот раз — Emu3.5. В отличие от предыдущих работ, здесь авторы прямо говорят, что пытаются построить не просто мультимодальную модель, а некую world model. Ниже разберёмся, что под этим понимают.

Сразу о путанице в названиях. Есть Emu от Meta* — text-image-модель, важная в своё время как ранний пример качественного SFT на небольших датасетах. И есть отдельная серия работ Emu от авторов этой статьи.

Например, год назад, у них была работа под названием Emu3: Next-Token Prediction is All You Need. Тогда идея была довольно простой: свести текст, картинки и видео к единой задаче next-token prediction. Генерации выглядели сочными, но при внимательном рассмотрении страдали от типичных артефактов дискретизации — текстуры «плыли», мелкие детали разваливались.

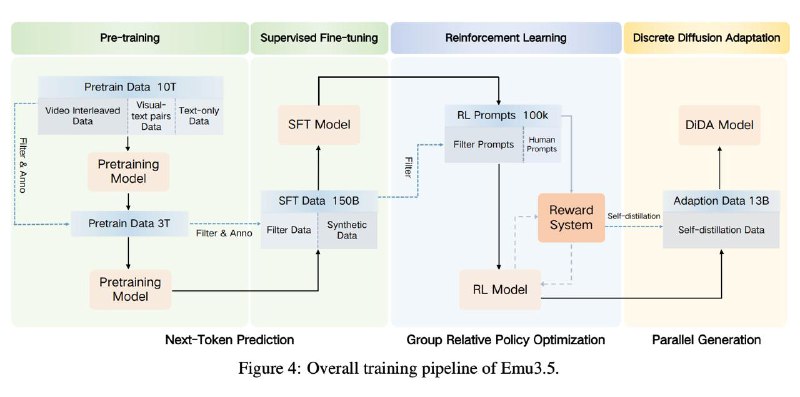
В Emu3.5 амбиции заметно выросли. Архитектурно всё по-прежнему прямолинейно: один decoder-only-трансформер на 34B параметров, обучаемый чисто авторегрессионно. Самое интересное — в данных. Вместо того чтобы опираться в основном на пары картинка-текст, модель обучают преимущественно на чередующихся (interleaved) видео-текстовых последовательностях из интернета. Видео нарезают на ключевые кадры, аудио транскрибируют с помощью ASR с таймстемпами, а затем всё это склеивают в одну длинную последовательность: в сумме — больше 10 триллионов токенов.

Так модель учится не отдельным сценам, а событиям во времени: динамике, переходам, причинно-следственным связям. Это и есть их практическое определение «world learning». Кроме видео используют обычные image-text-данные и большой объём text-only-данных.

И это ещё не финал: после претрейна модель доучивают — сначала на гигантском SFT (150 млрд сэмплов), а потом через RL-алайнмент, чтобы она вела себя адекватно и по тексту, и по картинкам.

Все модальности токенизируются в общее дискретное пространство. Словарь модели — около 280k токенов, из которых ~150k приходятся на текст, а остальная часть — на визуальные токены. Для визуальной части используется собственный токенизатор с REPA-подобной стабилизацией через SigLIP. Авторы честно признают, что дискретизация всё равно даёт артефакты, поэтому опционально добавляют диффузионный декодер поверх авторегрессионной генерации.

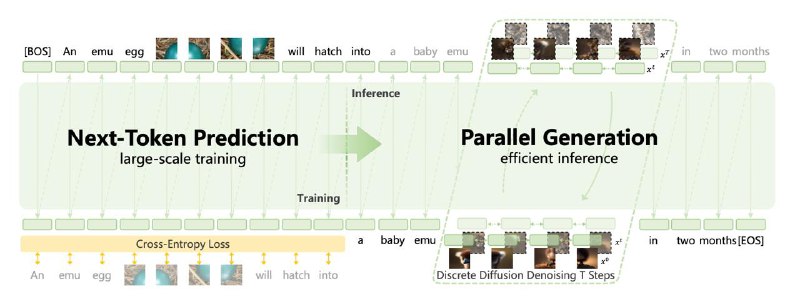
Отдельная важная часть — DiDA (Discrete Diffusion Adaptation). Так пробуют решить главную боль авторегрессии: медленную генерацию изображений. На этапе инференса модель временно переводится в режим дискретной диффузии: визуальные токены зашумляются и затем восстанавливаются за несколько итераций. За счёт этого генерация картинок ускоряется примерно в 20 раз без заметной потери качества.

На выходе Emu3.5 умеет довольно широкий спектр вещей: выдаёт длинные согласованные визуальные нарративы, генерацию историй с картинками, пошаговые визуальные инструкции и даже навигацию по сцене по текстовым командам — как будто внутри есть некоторое представление пространства. В классических задачах text-to-image и image editing модель на уровне сильных закрытых мультимодальных моделей.

В итоге, даже если с громким термином world model можно поспорить, сама траектория развития Emu выглядит любопытно — продолжим следить за ними.

Разбор подготовил ❣ Сергей Кастрюлин
CV Time
___
Компания Meta признана экстремистской; её деятельность в России запрещена.
  • 👍 15
  • ❤ 8
  • 🔥 8
  • 🥰 2
Post #237 2.23K
Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking [2/2]

Продолжаем разбирать техрепорт, описывающий новые модели Qwen.

Обучение моделей и результаты

Обучение моделей делается в несколько этапов, причём довольно нетривиальным образом: модели с этапа X используются для последующей фильтрации данных для этапа X+1, а Embedding и Reranker на разных этапах выступают учителями друг для друга.

— На всех этапах модели обучаются как LoRA к Qwen3-VL, чтобы с большей вероятностью не испортить возможности сильного бэкбона.

— На первом этапе (s0) на всём датасете обучается Embedding, используя контрастивный InfoNCE-лосс.

— На следующем этапе Embedding:s0 используется для фильтрации датасета — и на этом фильтре обучается Embedder:s1 и Reranker.

— На последнем этапе снова фильтруется уже Reranker, и скоры Reranker используются как таргет для дистилляции Embedding:s2.

— Наконец, веса полученной модели усредняются (точнее, сферически интерполируются) с Embedding:s1, порождая финальную модель Embedding:s3, которая и пошла в релиз.

По замерам авторов, их модели опережают все существующие открытые и закрытые модели на мультимодальных бенчмарках. При этом на текстовых задачах есть и более сильные модели — в основном существенно большего размера.

Использование моделей

Авторы явно постарались сделать модели production-ready, позаботившись не только о качестве метрик, но и об удобстве использования.

Во-первых, в модель заложены несколько очень важных свойств для производительности (помимо инференса в один prefill-этап).

Тренировка проводилась в quantization-aware-режиме — при вычислении лоссов для эмбеддингов, авторы одновременно вычисляли их для квантизованных в int8-эмбеддингов. В результате, полученные эмбеддинги можно квантизовать в int8 (отмасштабировать в интервал [-127, 128] и округлить), хранить и использовать практически потери качества.

Также в тренировке эмбеддингов использовался подход матрёшки, при котором лоссы применяются не только к эмбеддингам целиком, но и по частям к их первым 32, 64, 128, 256 и 512 элементам. Благодаря этому каждый кратный степени двойки «подсрез» эмбеддинга — тоже эмбеддинг (хоть и худшего качества). При работе с большой базой документов можно, например, брать только первые 128 элементов эмбеддинга вместо 1024 и хранить только их. Суммарно можно сократить размер эмбеддингов базы документов в 10–50 раз.

Во-вторых, в силу архитектуры модель очень гибка в применении. И документ, и запрос могут быть не только одним изображением или текстом, но и их произвольной последовательностью. Довольно большое окно контекста (32К) токенов позволяет обрабатывать 10–20 страниц изображений вместе с текстом.

Также интересная фича таких моделей как класса — наличие инструкции. Мультимодальные семантические эмбеддинги доступны всем и каждому как минимум с момента релиза CLIP (5 лет назад!), но способ вычисления эмбеддинга почти всегда был «зашит» в модель. Для эмбеддеров на основе LLM/VLM можно в инструкции указать, что важно в «кодировании» документов и запросов. Например, в случае поиска по картинкам можно инструктировать модель фокусироваться на стиле изображения или, наоборот, на содержимом — и получить эмбеддинги, поиск по которым будет давать разные результаты.

В итоге у авторов получилась гибкая и эффективная опенсорсная модель для мультимодального поиска. В отчёте приведено много деталей обучения, а в cookbook — примеров использования. Модели такого класса определённо имеют множество применений как в продуктах, так и в рутинных ML-задачах по работе с данными.

Разбор подготовил ❣ Борис Зимка
CV Time
  • ❤ 19
  • 👍 11
  • 🔥 10
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →