
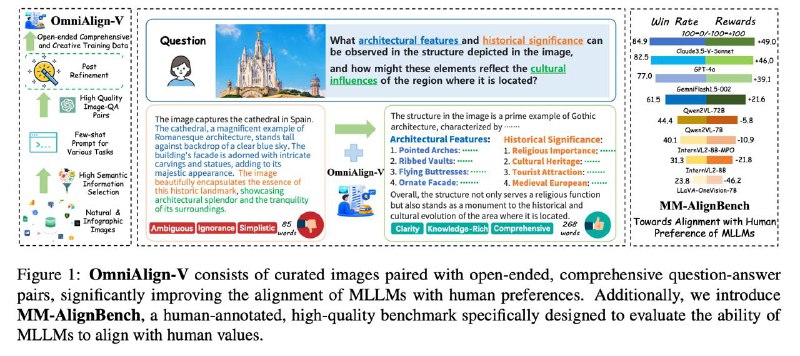
OmniAlign-V: Towards Enhanced Alignment of MLLMs with Human Preference [1/2]
Сегодня разбираем статью об алайнменте VLM, которую можно воспринимать как срез главных проблем в области и их решений. В первой части поговорим об основных узких местах, которые выделяют авторы.
1) Автометрики не отражают качество алайнмента полностью. Обычно для VLM его измеряют с помощью бенчмарков, где предполагается один правильный ответ: посчитать число объектов на картинке, ответить на простой вопрос в одно слово и прочее. Такие автометрики удобно считать, и они действительно проверяют базовые навыки модели, но многие аспекты качества VLM с их помощью не оценить.
2) Для VLM долгое время не было общепринятой «арены». Если для LLM была арена, которую знали, смотрели и репортили почти все, то для VLM она появилась не так давно.
3) Мультимодальный SFT портит текстовые способности LLM. Главное утверждение авторов: именно на этой стадии LLM внутри VLM сильно деградирует. Для проверки берут исходную LLM, измеряют на текстовых бенчмарках, затем делают мультимодальный SFT и снова измеряют получившуюся модель на тех же бенчмарках. В результате метрики заметно ухудшаются. Выдвигаются две гипотезы, почему это происходит.
Первая гипотеза: в мультимодальном SFT слишком мало text-only-данных. Если добавить их, возможно, просадка уменьшится. Для проверки берут датасет LLaVA-Next SFT с 40 тысячами текстовых примеров, многие из которых старые и некачественные. Эти примеры заменяют на более качественные, а затем масштабируют долю текстовых данных.
Результат получается контринтуитивный: текстовые метрики алайнмента действительно растут, но мультимодальные метрики падают как на арене, так и для базовых навыков. Таким образом, качество текстового алайнмента плохо обобщается на мультимодальный срез.
Вторая гипотеза: сами по себе мультимодальные данные слишком простые по сравнению с тем, на чём обучают LLM. Они плохо проучивают instruction following и качество ответа в разрезе human preference. Авторы приходят к идее собирать мультимодальные данные, которые по качеству и сложности ближе к задачам алайнмента под human preference.
Во второй части разбора поговорим о том, как происходил сбор данных, подробнее рассмотрим полученный бенчмарк и результаты.
Разбор подготовил ❣ Алексей Григорьев
CV Time
Post #245
1.84K
- 🔥 18
- 👍 12
- ❤ 9