Сегодня разберем основные
методы оценки ИИ-моделей, которые применяются в генеративных и retrieval-сценариях.
Многие из них пересекаются по сути, поэтому ниже упрощённая и объединённая структура методов.
1. Семантические методыОценивают смысловую близость между вопросом, контекстом и ответом.
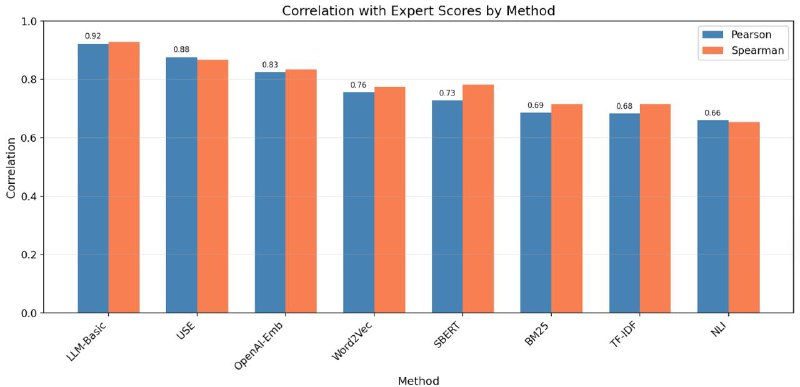
Используются эмбеддинги и косинусное сходство (например, sentence-transformers, OpenAI text-embedding-3-small, MiniLM).
Чем выше значение, тем сильнее совпадение по смыслу.
Применяется для оценки релевантности найденных фрагментов, совпадения с эталонным ответом, фильтрации нерелевантных контекстов.
2. Лексические методыБолее простые и интерпретируемые.
Основаны на анализе пересечения ключевых слов (Keyword Overlap).
Считается доля совпадений между словами в вопросе и ответе или контексте.
Метод быстрый, но чувствителен к перефразировкам, обычно используется как базовая проверка ответов ИИ решения.
3. Фрагментарная (chunk-based) оценкаВместо анализа документа целиком проверяется каждый фрагмент (chunk).
Это дает возможность точнее понять, какие куски текста действительно релевантны запросу, а какие просто шум.
Метод активно применяется в RAG-системах, где контекст разбивается на блоки.
4. LLM-based верификация (LLM as a Judge)Оценка проводится самой языковой моделью, которая получает пару вопрос–контекст или вопрос–ответ и выносит суждение (например, по шкале от 1 до 5).
Используется для проверки релевантности, полноты, соответствия ответа запросу и многих дургих метриках
5. NLI-подход (Natural Language Inference)Метод логической проверки, который смотрит действительно ли ответ вытекает из данных.
Внешняя модель (например, RoBERTa-large-MNLI или DeBERTa-v3-large-mnli) классифицирует связь между контекстом и утверждением как подтверждение, противоречие или несвязанные, после чего считается финальный скор.
Применяется для контроля достоверности и выявления галлюцинаций.
6. Verdict / смысловая декомпозицияМетод делит ответ от ИИ решения по смысловым блокам (тезисам).
Каждый блок проверяется на уместность (или соответствии критериям метрики) относительно вопроса.
7. Reverse QuestioningИнверсный метод, модель оценщик (LLM) получает готовый ответ и должна восстановить вопрос.
Если восстановленный вопрос близок к исходному, то значит, ответ действительно отражает суть запроса.
Используется как дополнительная проверка релевантности и смысловой согласованности.
Полезная информация:
Курс по evaluation AI |
Мой фремворк для оценки AI |
С чего начать изучение AI |
Инструменты для оценки AI |
Инструменты для оценки AI (ч.2)
 ТЕ