
Недавно завершил свое небольшое исследование в части коррелляции подходов к оценке ИИ с человеческой оценкой в части метрики релеватность ответа. Для этого я сделал датасет из 500 вопросов, разделенный на 5 групп по 100 вопросов (Факты, Процедуры, Объяснения, Поддержка пользователей, Креатив) и на каждый из которых было сформировано 3 ответа, хороший, удовлетворительный и плохой. После чего, все эти 3 ответа для каждого запроса были оценены разными методами оценки, что в итоге в результате дало 1500 оценок для каждого метода.
Какие в итоге получились результаты.
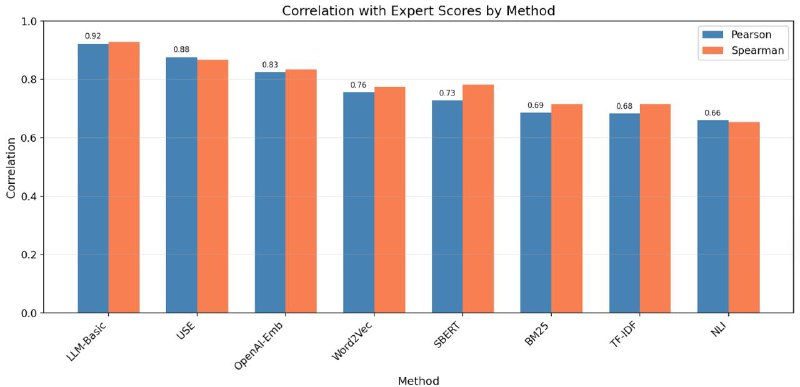
Как и ожидалось, наилучшим подходом оказался LLM as a Judge, который получил 92% корреляции по коэфициентам Пирсона и Спирмана, что в целом достаточно неплохой результат, большинство оценок совпадает с человеческой экспертизой, но другим для меня открытием стал метод векторного сравнения USE, который показал 88% корреляции, но при этом в отличии от LLM as a Judge выполняется в разы быстрее и не требуется затрат на использование модели. Более того, методе USE показал аналогичные абсолютно примерно коэфициенты корреляции для группы вопросов, связанными с фактами, процедурами и объяснениями, что позволяет рассматривать его как полноценную альтернативу LLM as a Judge подходу. На третьем месте оказался подход с использованием эмбеддингов от OpenAI.
Полные результаты исследования я планируют попробовать опубликовать в научном журнале, а пока можете посмотреть пару графиков по результатам оценки.
Полезная информация:
Курс по evaluation AI |
Мой фреймворк для оценки AI |
С чего начать изучение AI | Инструменты для оценки AI |
Инструменты для оценки AI (ч.2)
Post #74
805

- 🔥 9
- 👍 2