
Почему мой фреймворк eval-ai-library лучше чем DeepEval или RAGAS?
Последний год я исследовал, как существующие фреймворки (RAGAS, DeepEval) оценивают качество AI-систем, и почему их результаты часто расходятся с человеческой оценкой. Результатом данного исследования стал мой opensource фрейморв eval=ai-lib, внутри которого присутствует мой собственный метод TCVA (Temperature-Controlled Verdict Aggregation).
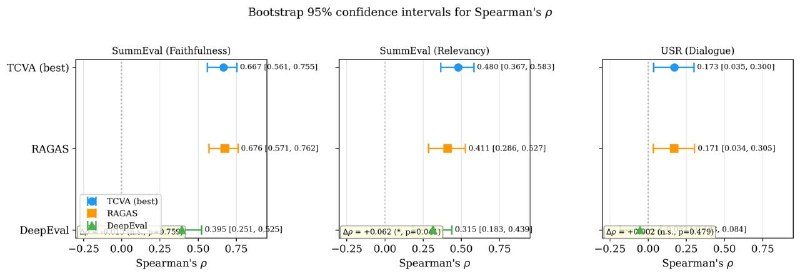
Что видно на графиках:
График 1 — сравнение корреляции с человеческими оценками на трех бенчмарках:
• На faithfulness TCVA и RAGAS идут практически вровень (0.667 vs 0.676)
• На relevancy TCVA обходит RAGAS: 0.480 vs 0.411 (+17%)
• DeepEval стабильно отстает на всех датасетах
График 2 — bootstrap-анализ с доверительными интервалами:
• На faithfulness разница между TCVA и RAGAS статистически незначима (p = 0.759), что говорит о том, что методы реально сопоставимы
• На relevancy TCVA значимо лучше (p = 0.041), и это не случайность, а системное преимущество
Почему так происходит?
Ключевая проблема RAGAS - это бинарные вердикты. Каждое утверждение либо да, либо нет, но реальность не бинарна. Когда AI-система дает ответ, который на 80% корректен, бинарная оценка теряет нюансы.
TCVA использует 5-уровневую шкалу вердиктов и агрегирует их через обобщённое степенное среднее с параметром температуры:
• Низкая температура → строгая оценка (для медицины, финансов)
• Высокая температура → мягкая оценка (для чат-ботов, креативных задач)
И самое важное, что переключение между режимами не требует дополнительных вызовов LLM.
Один раз получили вердикты, дальше агрегируем как нужно.
Когда мы оцениваем AI-систему, уровень строгости должен зависеть от домена применения. Один и тот же ответ может быть отличным для чат-бота и недопустимым для медицинского ассистента. Универсальный бинарный подход этого не учитывает.
Исходный код метода доступен в open source https://github.com/meshkovQA/Eval-ai-library
Полезная информация:
Курс по evaluation AI |
Мой фреймворк для оценки AI |
С чего начать изучение AI | Инструменты для оценки AI |
Инструменты для оценки AI (ч.2)
Post #130
621

- 🔥 9
- ❤ 2