TGViewer
Channel Public Channel
10 минут до кода

10 минут до кода

@ten_minutes_to_code

Твой ежедневный контекст в мире веб-разработки.

Без скучных уроков и академической нагрузки.
Читаешь канал 10 минут в день — убираешь кашу в голове и становишься программистом.

Просто. Понятно. Каждый день.
Subscribers
228
Photos
98
Videos
0
Links
90
Recent Posts 20 shown
Post #147 354
Первый сезон получился про путь “от пользователя к инженеру”.

Именно эту картину мы весь сезон постепенно и собирали.

👇Ниже я упорядочил посты первого сезона в понятный маршрут:

1. Как веб-приложение вообще “дышит”

- Почему страница не моргает?
- Путь запроса: почему твой сервер превращается в «монстра»?
- API — это договор
- Где на самом деле «живут» ваши данные

Чтобы перестать видеть в вебе магию, нужно понять базовый цикл: пользователь делает действие → фронтенд отправляет запрос → сервер обрабатывает логику → данные меняются → интерфейс обновляется.


2. Как думать данными, сущностями и состояниями

- CRUD: Атомарная логика любой системы
- Стейт-машина головного мозга
- Призраки в базе: Почему «удалить» не значит стереть
- Целостность данных против иллюзии атомарности
- Почему нормализация БД — это чистая логика, а не бюрократия

Инженер видит не кнопки и формы, а жизненный цикл данных: создание, изменение, удаление, состояния, ограничения и последствия.


3. Архитектура и границы ответственности

- Слепое проектирование: Бэкэнд не должен знать о кнопках
- Почему унитаз на кухне — это плохая архитектура
- Почему фронтенд должен оставаться «тупым»
- MVC: Разделение ответственности вместо наведения порядка в папках
- Изоляция контекста: Почему код не должен знать лишнего
- Хирургия кода: Почему швейцарский нож убивает архитектуру

Хорошая архитектура — это не красивые папки, а правильно проведенные границы: кто за что отвечает, кто о чем знает и где должна жить логика.


4. Ошибки, дебаг и наблюдаемость

- HTTP-статусы: Почему 200 OK при ошибке — это путь в ад
- Stack Trace: Карта преступления, а не просто красный текст
- Инструментарий инженера: Вкладка Network как рентген для системы
- Timing в DevTools: Как увидеть, где именно тормозит система
- Почему ваш «рабочий» код — это баг
- Черный ящик продакшена: Почему console.log — это не логирование
- Почему пустой Catch — это технический суицид

Инженер не гадает. Он умеет смотреть на факты: запросы, статусы, логи, стек вызовов, тайминги и состояние системы.


5. Инфраструктура, продакшен и взрослая разработка

- Проклятие локалхоста: почему ваш код — это только 30% системы
- CI/CD: Почему зеленые галочки в GitHub Actions не делают вас инженером
- Железо vs Софт: Веб-сервер как точка входа в систему
- Миграции: Как перестать молиться на дампы баз данных
- Feature Flags: Консистентный раскат без боли и деплоев
- Ретрай-политики: Как не превратить обработку ошибок в DDoS-атаку

Продакшен — это не место, где “код просто работает”. Это среда, где важны раскатка, откаты, миграции, сетевые сбои, повторы, сервера и последствия каждого изменения.


6. Протоколы, API и способы общения систем

- REST: Манипуляция ресурсами вместо вызова функций
- GraphQL: Свобода фронтенда и ловушка производительности
- gRPC: Когда вызов метода важнее, чем манипуляция ресурсом
- Протоколы общения: Почему шкаф из IKEA не возят целиком
- Оверхед на пустом месте: Когда WebSockets превращаются в обузу
- Скорость света как ограничение: зачем на самом деле нужна CDN

Разные способы общения систем существуют не потому, что программисты любят усложнять, а потому что разные задачи требуют разных компромиссов.


10МДК | ВЕБМастер
  • 🔥 7
  • ❤ 2
  • ❤‍🔥 2
Post #146 520
Когда я запускал этот канал,
у меня была довольно простая идея:

писать каждый день короткий пост на 5–10 минут чтения, чтобы вы постоянно оставались в контексте разработки.


Мне казалось, что мыслей хватит надолго, но довольно быстро выяснилось, что это так не работает. 🤷‍♂️

Когда каждый день нужно придумывать тему “из воздуха”, канал быстро превращается в поток отдельных мыслей. Сегодня про API, завтра про ошибки, послезавтра про базы данных — вроде всё полезно, но не всегда понятно, как это складывается в одну картину. 😩

Да и постоянно спрашивать “что вам интересно?” — тоже не вариант. Человек не всегда знает, чего именно он не знает. 😉

👌 Поэтому я решил немного поменять формат.

⚡️Теперь в канале будут сезоны.⚡️

Каждый сезон — это одна тема, которая идет красной линией через все посты. Мы будем строить целую картину мира, вместо подсвечивания отдельных пазлов.

Но прежде чем начать новый сезон, давайте красиво закроем первый. 👇

10МДК | ВЕБМастер
  • 🔥 7
  • 👏 4
  • ❤‍🔥 3
Post #145 306
Почему нормализация БД — это чистая логика, а не бюрократия

На любом ongoing-проекте требования меняются постоянно. Сегодня вы добавили одну колонку, завтра еще две, а через месяц обнаружили в базе «божественную таблицу». Это такой огромный монстр, в котором хранится вообще всё: от данных заказа до цвета шнурков в выбранном товаре и домашнего адреса троюродной тети клиента.

Такой накопленный технический долг кажется удобным только на первый взгляд — ведь «всё под рукой». На деле это превращается в архитектурный ад.

Шкаф из IKEA и лишний оверхед

Когда данные свалены в одну кучу, поиск превращается в перебор хлама. Представь огромный шкаф, где одежда просто набросана горой. Вроде бы всё в одном месте, но найти конкретные носки невозможно. Чтобы достать одну вещь, тебе приходится вываливать всё содержимое на пол.

В разработке это работает так же: вместо того чтобы сходить в компактную таблицу и забрать нужный лог или профиль, бэкэнд вытягивает из базы гигантскую сущность со всеми потрохами. Вы нагружаете память, гоняете по сети лишние мегабайты и потом мучительно фильтруете этот мусор в коде.

Правильная архитектура — это когда внутри шкафа есть отдельные ящики: для маек, для носков, для белья. Ты точно знаешь, куда постучаться, чтобы получить конкретный тип данных.

Принцип Single Source of Truth

Вторая беда денормализованных данных — «раздвоение личности» системы. Это происходит, когда одна и та же смысловая единица (например, имя пользователя) хранится строкой в разных местах: в профиле, в заказах, в тикетах поддержки.

Проблема всплывает в тот момент, когда юзер меняет имя. В профиле вы его обновили, а в тикетах остался старый слепок. Поддержка обращается к клиенту по старому имени, юзер злится, вы получаете плохой отзыв.

Нормализация внедряет принцип Single Source of Truth (SSoT). Истина должна жить строго в одном месте. Если у тебя одни и те же данные размазаны по разным таблицам, будь уверен — рано или поздно один из источников начнет врать.

Экономия на масштабе

Помимо логического порядка, нормализация — это вопрос стоимости инфраструктуры. Представь адрес доставки. Это строка символов на 200. Если ты пишешь её в каждую строку каждого заказа, то при миллионе заказов ты хранишь гигабайты дублирующихся букв.

Если же вынести адрес в отдельную таблицу и ссылаться на него через компактный ID-шник, на жестком диске освобождаются сотни гигабайт. Нормализация — это не просто наведение красоты в схеме, это эволюционный процесс, который делает систему производительной и дешевой в поддержке.

Ставь 🔥, если хочешь чтобы я на пальцах объяснил как делать нормализацию базы данных.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 9
  • ❤ 1
Post #144 268
🤔 А где новые посты?

Сори что вот так пропал без предупреждения, но я думал что справлюсь вести паблик во время переезда, а по факту переезд оказался не так прост 😅

Я вернусь в прежний ритм буквально через пару дней, а пока у вас есть возможность повлиять на будущие публикации!

💡 Накидайте в комментах какие темы вам интересны, что мне стоит разобрать и объяснить?

Пишите что угодно, не стесняйтесь, любые вопросы и темы будут мне максимально полезны 🫶

10МДК | ВЕБМастер
Post #143 260
Почему HTTPS не спасет ваши секреты

Замочек в адресной строке браузера — это мощное успокоительное для обывателя, но для инженера это лишь индикатор того, что данные не украдут прямо из кабеля.

Большинство считает: раз есть HTTPS, значит, информация в безопасности. Но это опасное заблуждение. Трафик действительно шифруется, но только в узком коридоре «клиент — сервер».

Иллюзия бронированного сейфа

Представьте, что вы отправляете сверхважное письмо в бронированном сейфе. Пока курьер везет его до почтового отделения, всё отлично — вскрыть его на ходу невозможно. Но как только посылка попадает на склад (наш сервер), сотрудники почты достают письмо из сейфа и кладут его на полку в открытом виде.

Под капотом HTTPS работает именно так: пакет данных зашифрован, пока летит по сети, но в конечной точке, на сервере, происходит терминация SSL/TLS. Сервер получает чистый текст, который затем улетает в базу данных или оседает в логах. Если админ или злоумышленник получит доступ к серверу, ваша «защита» превращается в тыкву.

Механика End-to-End: Исключаем посредника

Чтобы данные оставались приватными, мы должны убрать у сервера саму техническую возможность их прочитать. Здесь в игру вступает сквозное шифрование (E2E). Основная задача — сделать так, чтобы в цепочке не было третьей точки, способной расшифровать payload.

Логика строится на асимметричном шифровании и паре ключей:

1. Public Key (Публичный): Отдается миру. Нужен только для того, чтобы зашифровать сообщение для конкретного получателя.
2. Private Key (Приватный): Хранится строго на устройстве пользователя. Только он может расшифровать то, что было зашифрованно его публичным ключом.

В момент «рукопожатия» (инициации секретного чата) клиенты обмениваются публичными ключами. И когда вы пишете сообщение, ваше приложение шифрует его публичным ключом собеседника. Сервер же получает запертый сейф, к которому у него нет и не может быть отмычек. Поэтому роль бэкенда здесь сводится к примитивной пересылке зашифрованного байт-кода от клиента А к клиенту Б. И когда сообщение получит клиент Б, он сможет расшифровать его своим приватным ключом.

Инженерный профит: Безопасность через неведение

Для разработчика E2E — это лучший способ снять с себя ответственность за чужие данные. Если вы как провайдер физически не можете прочитать переписку, вы не станете источником утечки при взломе базы.

Правда, есть нюанс: если у пользователя утечет приватный ключ, вся история сообщений в базе (если вы её храните и она тоже утекла) мгновенно станет доступна злоумышленнику. Поэтому архитектура E2E часто подразумевает, что хранить зашифрованный мусор на сервере вообще нет смысла — разве что для синхронизации истории, но и это требует ювелирной работы с ключами.

Если хотите глубже разобраться в этой теме, то приглашаю вас в ВЕБМастер. Мы будем по косточкам разбирать реализацию таких систем в рамках проекта, который будем делать в Мае. Будем пилить мессенджер с групповыми чатами и полноценным E2E, чтобы на практике понять, как управлять ключами и не превратить архитектуру в решето. Подробнее про проект я расскажу совсем скоро 👌

Ставь 🔥, если не знал как работает E2E шифрование, а теперь все понятно

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 2
Post #142 157
Целостность данных против иллюзии атомарности

Начинающий разработчик видит базу данных как набор последовательных «атомарных» команд: проверил остаток, списал баланс, обновил ордер, добавил запись. И в условиях локальной разработки, где в системе один пользователь, этот подход кажется логичным. Но в продакшене, где внешние факторы, от сетевых таймаутов до сбоев питания, работают против вас, этот путь ведет к деградации данных.

Представьте, что вы пишите банковское приложение. И вот один из пользователей хочет перевести некую сумму другому пользователю. Если в процессе перевода что-то упадет, то мы рискуем оказаться в ситуации, когда с первого счета деньги уже списали, а на второй еще не начислили.

Система оказывается в состоянии «зомби-данных». Деньги по факту зависли в пространстве между счетами, а консистентность базы нарушена.

Транзакция как механизм восстановления

Транзакции в SQL решают проблему непредсказуемости среды, объединяя набор запросов в единый неделимый блок. Логика тут простая: либо система достигает целевого состояния (все запросы выполнены), либо возвращается к исходному (в случае ошибки любого элемента пачки выполняется ROLLBACK). Но самое приятное, что движок базы данных сам за этим следит и вам не нужно вручную откатывать изменения. Это перекладывает ответственность за целостность с вашего прикладного кода на движок базы данных.

MySQL отслеживает состояние системы во время выполнения транзакции и гарантирует, что «битые» данные не будут зафиксированы. Использование транзакций — это индикатор перехода от написания скриптов к проектированию надежных систем.

Давайте все обернем в транзакции?

Транзакции — инструмент мощный, но затратный. Оборачивание всего подряд в одну транзакцию превращает базу данных в «бутылочное горлышко» из-за блокировок и нагрузки на журнал транзакций.

Во всем нужна золотая середина. Группируйте запросы в транзакцию только тогда, когда логика бизнес-процесса требует исполнения цепочки операций как единого целого. Если вы понимаете, что части операции не могут существовать в отрыве друг от друга — это ваш случай. Если же данные независимы — не создавайте избыточную нагрузку на систему ради призрачного спокойствия.

🔥 — если пост был понятен и полезен.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 11
Post #141 125
Почему «сделай за меня» убивает в тебе инженера

Распространение LLM вскрыло глобальный баг, который в айтишке игнорировали годами: люди не умеют формулировать мысли в понятный поток.

Разработчики часто думают, что понимают, как работает их код, но на деле это часто оказывается «иллюзией глубины объяснения». Человек понимает 10% в начале, 10% в конце, а посередине — 80% «жира» и магии, которые скрыты в тумане.

Метод утки: Переключение из Деятеля в Архитектора

Когда ты сидишь в IDE и пытаешься пофиксить назойливый баг, твой мозг работает в режиме «деятеля». Ты сфокусирован на конкретной строке, ты зарыт в деталях и часто не видишь системы целиком. Чтобы выйти из этого режима существует старый добрый метод резиновой уточки.

Суть этого метода не в том, чтобы поговорить с игрушкой, а в том, чтобы собрать максимально полный контекст. Когда ты сидишь над кодом, твой мозг работает в режиме «деятеля» — он зациклен на конкретной строке, ошибке или блоке кода. Но чтобы объяснить проблему уточке (или нейронке), тебе нужно переключиться в режим «архитектора».

В этот момент происходит линеаризация мышления. Речь — процесс последовательный. Ты не можешь сказать: «Ну, тут вызывается метод, потом происходит магия, и на выход падает JSON». Точнее, можешь, но даже твой собственный мозг зафиксирует, что на этапе «магии» у него пробел. Описывая задачу, ты вынужден восстанавливать логические связи, которые в обычном состоянии просто принимал на веру. Именно в процессе этого «пересказа» системы целиком ты и находишь несостыковку.

LLM как прокачанная утка

LLM — это та же уточка, но на стероидах. Она может ответить, направить или подсказать. Но здесь кроется ловушка, в которую залетает большинство разработчиков.

Когда ты пишешь промпт в стиле «у меня тут падает ошибка, вот лог, пофикси», ты совершаешь критическую ошибку. Ты делегируешь нейронке не просто рутину, а саму возможность понять систему.

Если ты просишь LLM «сделай за меня», ты пропускаешь процесс линеаризации. Ты остаешься в том самом тумане, где 80% логики тебе непонятны. Код будет доставлен, но ты не вырастешь как инженер, потому что не прогнал эту задачу через свой внутренний компилятор.

Ответственность за «подкапотку»

В моей практике был период, когда я просил джунов в комментариях к задачам описывать обычными словами, что именно они сделали. Не переменные перечислять, а объяснять взаимодействие модулей. Это помогало и им самим реально разбираться в том, что они написали, и команде оставаться в контексте изменений.

Нейронка — это всего лишь продвинутый автокомплит. Ответственность за систему всегда лежит на тебе. Если ты не можешь описать нейронке логику своими словами, значит, ты её не понимаешь. А если ты её не понимаешь, ты не контролируешь процесс.

Инженер начинается там, где заканчивается слепое копирование и начинается дотошное понимание окружения, в котором запускается его код. Используй LLM, чтобы подсветить свои пробелы, а не для того, чтобы их спрятать.

Как часто вы ловите себя на мысли, что не можете объяснить логику своего же метода без фразы «ну, оно как-то там само работает»?

🔥 — если используешь уточку (или ChatGPT) на постоянной основе.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 4
  • ❤ 1
Post #137 94
🥳 День квизов!

Если хотите дополнительный 4-ый вопрос, ставьте 🔥 этому посту.

Наберем 20 — опубликую бонусный квиз 😉

10МДК | ВЕБМастер
  • 🔥 6
Post #136 108
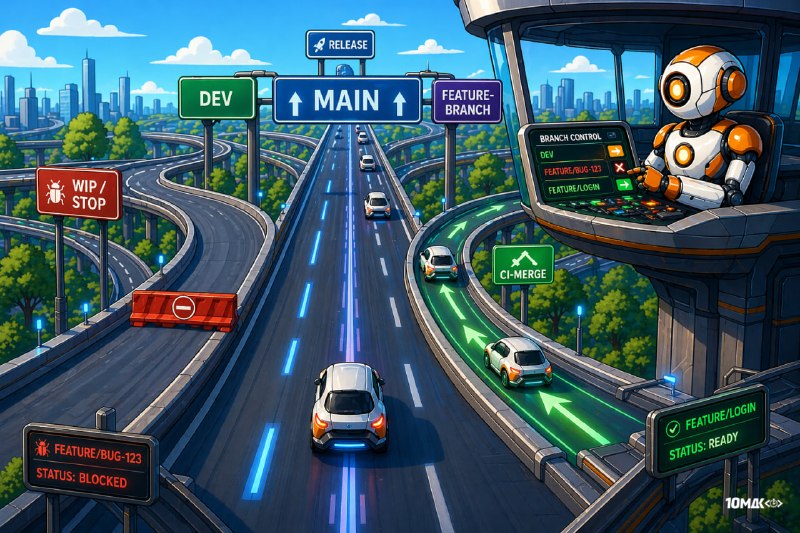
Ветвление в Git

Гит под капотом — это просто хранилище версий, база данных, которая фиксирует дельту изменений. Благодаря этому, мы можем откатиться к любому сохраненному состоянию нашего проекта.

Но ценность гита не только в «машине времени», но и в концепции веток. Ветка — это виртуальная копия состояния системы, которая позволяет работать изолированно.

В командной разработке без веток наступает коллапс. Если три разработчика пилят разные фичи в одном потоке, любой баг блокирует работу остальных разработчиков, кто занимается этим же проектом. Разработка превращается в очередь: все ждут, пока один пофиксит свои ошибки, чтобы просто продолжить работать.

Ветки решают проблему параллелизма. Вы работаете в своей «песочнице», а когда функционал готов — схлопываете изменения в основную ветку (main или master) одним мерж-коммитом.

Git Flow: Когда релиз превращается в бутылочное горлышко

Методологий использования git и веток масса. Самый распространенный подход — Git Flow. У вас есть main (стабильный код в продакшене) и dev (черновик, где собираются все новые фичи). dev всегда на шаг впереди, там тестируются новые фичи и копится код для будущего релиза.

И вот когда релиз готов, мы сливаем ветку dev в ветку main и пользователи получаю новые фичи, а разработчики начинают работать над новым релизом.

Проблема Git Flow в его линейности. Если на релиз запланировано 10 фич, и одна из них готова только на 90% (разработчик заболел или задача оказалась сложнее), весь релиз парализован. Пользователи не получают готовые 90% функционала, потому что они «заперты» в одной ветке dev вместе с недоделками.

Continuous Integration: Отмена релизных циклов

В философии CI (Continuous Integration) мы не ждем «дня релиза». Код улетает в лайв по 10-20 раз в день, как только фича готова и прошла все тесты.

Стандартная схема main + dev здесь рассыпается: вы не можете подлить в прод одну конкретную фичу из dev, не зацепив при этом весь остальной «мусор», который еще не готов к деплою.

Для решения этой задачи архитектура веток усложняется. Под каждую задачу создается не одна, а две ветки: одна для интеграции в dev (чтобы проверить совместимость), вторая — изолированная — для мерджа напрямую в main, когда тесты пройдены. Именно такой подход позволяет нам доставлять фичи изолированно и независимо от других задач.

На крупных проектах стейджей может быть еще больше: master, pre-master, integration, development. Каждая ветка соответствует конкретному окружению (серверу), где живет код.

Гит дает гибкость. Вы можете выстраивать цепочки любой сложности, чтобы разносить состояния системы и не зависеть от чужих багов. Это механизм, который превращает хаотичное написание кода в управляемый инженерный процесс.

🔥 — если за минимализм и две ветки.
🚀 — если плодите ветки под каждый стейдж.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 3
Post #135 91
Почему ваша оптимизация стоит бизнесу миллионы

На старте карьеры главная задача — заставить код просто работать. Но с опытом, как только приходят первые лаги и баги, просыпается страх. Из-за этого страха разработчики попадают в ловушку преждевременной оптимизации и начинают «вылизывать» систему еще до того, как она столкнулась с реальной нагрузкой.

Это критическая ошибка.

Преждевременная оптимизация вредит всем, и в первую очередь — бизнесу. Суть бизнеса в быстрой генерации денег и проверке гипотез. Пока вы тратите месяц на ускорение базы данных, которая и так справляется, проект простаивает. История знает десятки стартапов, которые год полировали архитектуру до блеска, а после релиза выясняли, что продукт вообще никому не нужен.

Представьте, что вам нужно пробраться через густые джунгли. Вместо того чтобы взять мачете и прорубить тропинку, вы начинаете строить суперобтекаемый гоночный болид. Он быстрый, технологичный, но абсолютно бесполезный в этом environment. Он просто не приспособлен для текущего окружения. И проблема здесь не в качестве болида, а в том, что вместо движения вперед вы занимались инженерным самолюбованием.

Любая «дикая» оптимизация неизбежно бьет по читаемости. Вместо понятного if-else в проекте появляются абстрактные фабрики, сложные паттерны наследования и автоматические подстановки. Когда через две недели бизнес попросит изменить логику, ваша оптимизированная конструкция станет бетонной стеной. Вам придется «оптимизировать оптимизацию», чтобы просто внедрить одну фичу. В итоге изменения обходятся в десятки раз дороже, потому что вы решили бороться за миллисекунды там, где они не имели значения.

Синьорская мудрость проста: Don't guess, measure (не угадывай — измеряй).

Если вы идете в оптимизацию просто потому, что вам так захотелось, — это пустая трата ресурсов. Сигналом к действию должны быть метрики. Если сервер едва вывозит нагрузку, если логи забиты ошибками таймаута, если база данных «отваливается» — вот тогда мы садимся и думаем, как это исправить. Метрики позволяют экономить деньги бизнеса и фокусировать ваши усилия на реальных бутылочных горлышках, а не на воображаемых.

Инженерный подход выглядит так:

1. Пишите максимально просто, даже если это «тупой» if-else.
2. Навешивайте метрики и логирование на все ключевые узлы.
3. Оставляйте ивенты для код-ревью в тех частях системы, где логика уже устаканилась и не менялась месяцами.

Когда мы тратим время на ускорение того, что и так работает, мы не просто сжигаем зарплату — мы не выпускаем фичу, которая могла бы принести прибыль. Оптимизируйте только то, что мешает системе расти прямо сейчас.

🔥 — если тоже считаете, что читаемость кода важнее микро-оптимизаций на старте.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 6
Post #134 103
Проектирование без боли: Как заложить фундамент базы данных

Смиритесь сразу: архитектуры «на века», которую никогда не придется трогать, не существует. Приложения растут, требования меняются, база данных неизбежно эволюционирует.

Это не значит, что на этап проектирования архитектуры БД можно забить. Это значит, что цель этого проектирования не предсказать будущее, а сделать так, чтобы не пришлось менять таблицы по 20 раз за день в разгаре разработки.

От юзкейсов к сущностям

Чтобы минимизировать трение, используем подход, близкий к DDD (Domain-Driven Development). Сначала нужно выявить сущности и связи. Для этого нужны Use Cases: четкий список того, как именно люди будут пользоваться системой. Что происходит после клика на кнопку? Какой объект создается или меняется?

Возьмем файловое хранилище. Юзер взаимодействует с папками и файлами. Это очевидные сущности которые будут у нас в системе. Но если пользователь делится доступом — появляется третья сущность «шаринг», потому что нам нужно где-то хранить уникальные URL и метаданные этого действия.

Или вот пример с типичным блогом: есть юзеры, которые пишут комментарии к постам, а у постов есть категории. Каждая такая логическая единица — это потенциальная таблица.

Механика связей и визуализация

Когда сущности нарезаны, нам нужно определить тип связей. Для этого можно задать простой вопрос: «Как много объектов привязано друг к другу?».

Один автор может написать пачку постов, но у конкретного поста автор всегда один — это связь один ко многим (1:N). В базе это решается просто: нужно добавить колонку user_id в таблицу постов. Если связь «многие ко многим» (M:N), то мы сразу проектируем pivot-таблицы.

Весь этот граф нужно сначала отрисовать в Miro или на бумаге. Просто квадраты сущностей и стрелки с подписями типов связей. Когда схема готова, «прогоните» через неё глазами каждый юзкейс. Данных для ответа API хватает и не нужно городить костыли? Значит, структура жизнеспособна. Здесь, к сожалению, нет универсального уравнения, только декомпозиция и проверка.

Принцип единственной ответственности в данных

Главный маркер плохой архитектуры — нарушение Single Responsibility. Таблица должна отвечать за одну логическую область. В моем проекте EduMixBot я сначала допустил ошибку: запихал настройки самого обучающего курса и настройки Telegram-бота того же курса в одну сущность courses. В итоге таблица стала multi-responsibility.

В итоге пришлось проводить рефакторинг и разносить их, потому что логика курса и логика транспорта (бота) — это разные вещи. Если ваша таблица начинает «знать» слишком много о разных аспектах системы, она превратится в свалку, которую сложно поддерживать.

Ставь 🔥, если хочешь пост про все возможные связи между сущностями/таблицами с примерами.

А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 7
Post #133 167
«Redis — это скорость, сейчас быстро ускорим приложение».

Когда разработчик приходит с таким аргументом, становится ясно: человек не понимает механику инструмента. Redis — это не магический патч, который вы ставите на сервер, и всё начинает летать. Это всего лишь база данных.

Под капотом здесь предельная простота: хранилище типа «ключ-значение». В Redis нет сложных связей, как в SQL, нет тяжелых джойнов и ветвистых структур. Главная особенность — данные живут в оперативной памяти (RAM). Это делает доступ к ним сверхбыстрым, но само по себе наличие Redis в инфраструктуре не дает вашему бэкенду никакого ускорения.

Инженерный подход требует понимания, куда именно мы втыкаем этот слой.

В стандартной схеме «клиент — бэкенд — база» Redis обычно появляется как дополнительная прослойка для работы с временными данными. Когда летит запрос, бэкенду нужно не просто отдать контент, а сначала раздуплиться: кто этот юзер? Авторизован ли он? Жива ли его сессия? Если каждый раз за этими проверками ходить в основную базу на диск, вы получите тормоза и задержку на ровном месте.

Redis идеально вписывается как кэшер или хранилище сессий. Мы вытаскиваем данные из оперативки мгновенно, проверяем валидность и работаем дальше.

То же самое с очередями: список фоновых задач вроде отправки e-mail или обработки видео лучше складывать в Redis. Мы разгружаем основную БД от мусорных операций и за счет скорости ин-мемори хранилища быстрее разгребаем пачку задач.

Использовать Redis для Rate Limit — еще один классический кейс. Проверить, не долбится ли юзер в API слишком часто, и обновить счетчик попыток за миллисекунды.

Выбирать Redis только потому, что это модно или «так написано в статье» — плохая практика. Если в коде не прописана логика взаимодействия с этим слоем, если вы не используете его для кэширования или очередей, вы просто сжигаете ресурсы. Оперативная память сегодня стоит дорого. Плюс вы ловите усложнение архитектуры: как минимум нужно думать об инвалидизации кэша. Если данные в Redis «протухли», а в основной базе обновились, пользователи будут недовольны.

На маленьких проектах без реальной нагрузки Redis чаще всего излишен. Это инструмент для решения конкретных узких мест. Пока у вас ничего не тормозит и нагрузка не плавит ваши сервера, лишний узел в системе будет только мешать. Инженерная зрелость — это умение не плодить сущности без необходимости.

Используете Redis для чего-то кроме кэша и сессий?

Жмите 🔥, если согласны, что оперативку надо беречь. А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • ❤ 3
  • 🔥 2
Post #132 125
Энтропия и налог на скорость: Почему софт гниет без движения

Попробуйте запустить проект, который вы не трогали пять лет. Скорее всего, вместо работающего приложения вы получите пачку ошибок в консоли. Хотя тогда, 5 лет назад, всё летало идеально. Это не случайность и не магия, а энтропия кода или «гниение бита». Софт, который не меняется, со временем неизбежно умирает.

Эффект разбитых окон в кодовой базе

Всё начинается с человеческого фактора. Когда проект свежий, все стараются держать архитектуру чистой, следовать паттернам и писать тесты. Но как только прилетает давление со стороны бизнеса или дедлайн начинает гореть, в коде появляется первый «костыль». Мысль стандартная: «Сейчас по-быстрому поправлю, потом переделаю, никто не заметит».

Здесь включается теория разбитых окон: если в заброшенном здании разбито одно стекло и его не заменили, скоро выбьют все остальные. Один забытый костыль легитимизирует халтуру для всей команды. Через полгода проект обрастает подпорками настолько, что любая правка превращается в разминирование.

Окружение как агрессивная среда

Код не существует в вакууме. Он крутится в среде, которая постоянно мутирует. Выходят новые версии Node.js или Python, обновляются сторонние API, в старых библиотеках находят критические уязвимости.

Если ваш стек максимально статичен и вы не трогали его годами — проект мертв. Старая библиотека в зависимостях — это открытая дверь для взлома. Даже если вы умудритесь запустить это окружение сегодня, вы получите продукт с дырами в безопасности, которые были обнаружены и закрыты в индустрии еще несколько лет назад. Поддерживать жизнеспособность софта — это как уборка в квартире: если перестать выносить мусор, через месяц в ней нельзя будет жить.

Налог на скорость

Энтропию нужно воспринимать как налог. Сегодня вы экономите пару часов, отказываясь от тестов или обновлений, чтобы быстрее доставить фичу в продакшн. Через два месяца вы будете платить уже десятки часов — либо за каждую новую задачу, которую стало сложно внедрять, либо за экстренный разбор завалов, когда всё окончательно упадет.

Это и есть механика технического долга. Костыли замедляют разработку по экспоненте, пока стоимость поддержки не превысит стоимость переписывания с нуля.

Как с этим работать инженеру:

1. Для своих проектов: раз в пару месяцев делайте чекап. Проверяйте актуальность пакетов, мигрируйте на стабильные версии рантайма, чистите зависимости.
2. Для клиентских проектов: не просите отдельное время на «причесывание» кода — бизнес этого не поймет. Жонглируйте оценками. Закладывайте рефакторинг и обновление либ в эстимейт новых фич. Привносить новое в гнилую структуру в разы сложнее и дороже, чем в чистую.

🔥 — если пост был понятен и полезен. А если остались вопросы или что-то звучит слишком абстрактно — пиши в комменты, обязательно разберем!

10МДК | ВЕБМастер
  • 🔥 6
Post #128 87
🥳 День квизов!

Если хотите дополнительный 4-ый вопрос, ставьте 🔥 этому посту.

Наберем 20 — опубликую бонусный квиз 😉

10МДК | ВЕБМастер
  • 🔥 4
Older posts →

About this channel

How can I read @ten_minutes_to_code without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 10 минут до кода: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 10 минут до кода have?
10 минут до кода (@ten_minutes_to_code) has 228 subscribers on Telegram, refreshed roughly every 30 minutes.
Does 10 минут до кода know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →