
Выложили с коллегами новый препринт, "Unveiling Intrinsic Dimension of Texts: from Academic Abstract to Creative Story": https://arxiv.org/abs/2511.15210
В этой работе мы продолжаем изучать внутреннюю размерность (Intrinsic Dimension, сокращенно ID) эмбеддингов текстов на последнем слое трансформеров и её связь со свойствами этих текстов (подробно про то, что такое эта внутренняя размерность, можно прочитать в моей статье на Хабре - https://habr.com/ru/articles/820531/ ). В частности, мы нашли следующие закономерности для ID эмбеддингов (активаций) последнего слоя моделей Qwen-2.5-1.5B, Gemma-2-2B и RoBERTa:
➡️ Чем выше лексическое разнообразие текста, тем в среднем выше и его внутренняя размерность (лексическое разнообразие оценивалось с помощью различных вариаций Type-to-Token Ratio (TTR)). Обратная картина наблюдается с повторениями внутри текста: чем больше в тексте повторяющихся словосочетаний или фраз, тем ниже его ID. Эти закономерности проявляются в разной степени в зависимости от модели, из которой извлекли активации. Наиболее чётко они видны на эмбеддингах RoBERTa - там модуль коэффициента корреляции |r| с соответствующими метриками достигает ~ 0.6-0.85. На Qwen и Gemma связь тоже прослеживается, но выражена слабее (|r| ~ 0.35-0.5).
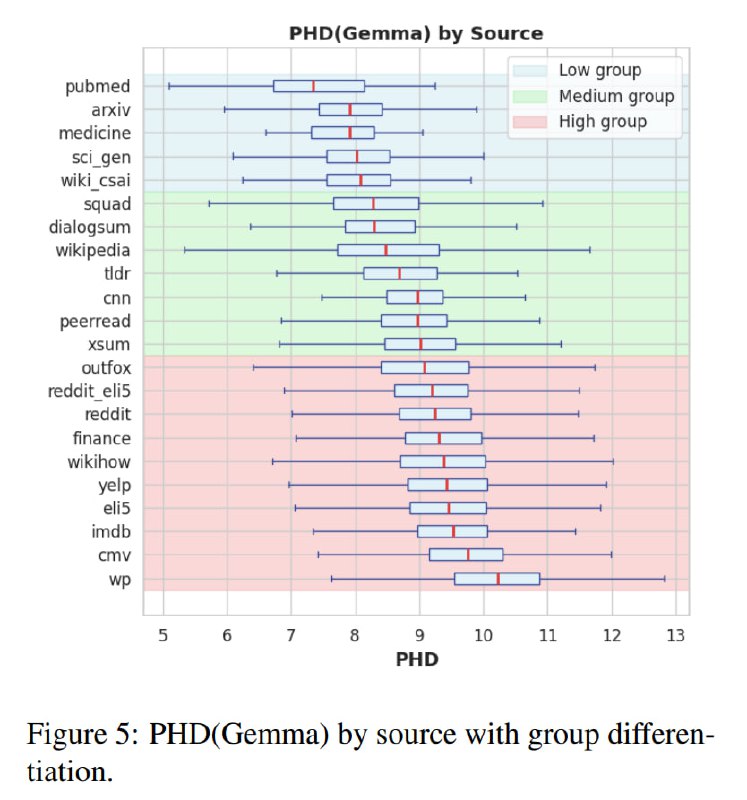
➡️ В среднем ID (измеренный методом Persistent Homology Dimension, PHD) выше у художественных текстов (∼10.5) и ниже у формальной и сухой научной литературы (∼8) (см. рис. 1). Интересно сопоставить эти значения с краевыми случаями, упомянутыми в нашей работе 2023 года ( https://arxiv.org/abs/2306.04723 ): если текст состоит из случайных, не связанных между собой токенов, его ID в среднем равен ~25. Средний ID текста, состоящего из одного и того же повторяющегося токена, напротив, минимален ( ~2-3).
➡️ Это наблюдение подтвердилось и с помощью анализа фичей Sparse AutoEncoder-а ( то, как работает эта техника interpretability, хорошо объяснено в видосе: https://www.youtube.com/watch?v=UGO_Ehywuxc ). Мы проследили, какие именно фичи SAE активируются сильнее всего на текстах разных жанров и как они скоррелированы с PHD. Результат анализа представлен на рис. 2.
➡️ ID также коррелирует со сжимаемостью текста алгоритмом gzip: чем выше ID, тем хуже текст сжимается, и наоборот (рис. 3). И неудивительно, ведь gzip хорошо сжимает повторяющиеся паттерны, а высокий ID, напротив, указывает на разнообразие и непредсказуемость. Это дополнительно подтверждает интерпретацию ID как меры структурной сложности текста. Интересно, однако, что данное понимание сложности совершенно не совпадает с человеческим: с точки зрения алгоритмов, научные тексты "просты" (низкий ID, хорошо сжимаются), но с точки зрения человека они, напротив, намного более сложны для понимания, чем художественные.
➡️ ID коррелирует с Cross-Entropy Loss (CE Loss) модели, но эта связь объясняется тем, что оба показателя растут с увеличением длины текста. Если нормализовать CE Loss на длину текста, корреляция с ID исчезает (рис. 4). Этот результат показывает, что ID измеряет не то же самое, что энтропия распределения логитов. ID - это независимая характеристика, отражающая сложность текста с другой стороны.
➡️ Разные стохастические методы оценки ID эмбеддингов одной и той же модели показывают довольно согласованные результаты (рис. 5). MLE, TLE и PHD сильно коррелируют друг с другом (r > 0.85), что подтверждает надёжность этих оценок. TwoNN более "шумный", он даёт больший разброс значений, поэтому коррелирует с остальными методами слабее (r ~ 0.55-0.7). Тем не менее, все оценки размерности связаны, и выводы, сделанные из анализа одного способа оценки, можно - в некотором приближении - экстраполировать и на другие.
➡️ Все способы оценки ID (за исключением TwoNN) моделей Qwen и Gemma также сильно скоррелированы между собой (r ~ 0.7-0.9), а ID RoBERTa скоррелированы с ними слабее (r ~ 0.45-0.7). Это может быть связано или с тем, что RoBERTa очень маленькая или с тем, что она использует encoder-архитектуру (в отличие от декодеров Qwen и Gemma). Чтобы уточнить причину, нужно проанализировать больше разных моделей.
#объяснения_статей
Post #2450
5.54K


- ❤ 23
- 🔥 10
- 👍 3
- 🫡 2
- 💩 1
- 🎄 1