TGViewer
Channel Public Channel
Системный анализ | Дмитрий Помаскин

Системный анализ | Дмитрий Помаскин

@system_analysis_school

📍Обучение системному анализу
📍Полезные материалы для развития навыков
📍Разбор практических кейсов по системному анализу и архитектуре
📍Индивидуальные консультации (менторство)

Моя онлайн-школа:
https://system-analysis.skillspace.ru
Subscribers
1.4K
Photos
47
Videos
154
Links
276

Showing posts older than #116 · Back to latest

Older Posts 20 shown
Post #115 735
❓Что такое шардирование в БД?

ℹ️ Шардирование — это метод распределения данных в базе данных между несколькими серверами (шардами) для повышения производительности и масштабируемости системы.

Основные типы шардирования:
✅ Горизонтальное шардирование — данные разделяются по диапазону значений (аналогично партиционированию);
✅ Вертикальное шардирование — разные таблицы или столбцы в них размещаются на разных серверах;
✅ Хэш-шардирование — используется хэш-функция от ключа шардирования для определения места хранения.

⚠️Отличие шардирования от партиционирования — при шардировании данные разделены по серверам, при партиционировании остаются на одном сервере.

⚠️Отличие шардирования от классического кластера — при шардировании данные не реплицируются, а просто распределяются по шардам. В кластере данные реплицируются между нодами.

P.S. В следующих видео на примерах расскажу, какие преимущества можно получить от внедрения шардирования.

Системный анализ | Дмитрий Помаскин
  • 👍 8
  • 🔥 6
  • 👏 1
Post #114 631
❗️Места в группах на первый интенсив закончились❗️

Дату и время проведения следующих интенсивов объявлю позже.
  • 👍 4
  • 🤯 4
Post #113 728
‼️Открыта запись на первый практический интенсив‼️

Так как голоса о днях проведения разделились, запускаю 2 группы:
🔸Воскресенье 20.07 12:00 МСК;
🔸Понедельник 21.07 19:00 МСК.

Тема: Базы данных.
Уровень: С нуля.
Кол-во участников: до 4.
Программа:
✅ Типы баз данных;
✅ Проектирование БД;
✅ Описание БД с помощью ER-диаграммы;
✅ Нормализация;
✅ Базовый SQL для аналитиков.

Практика:
✅ Самостоятельное проектирование БД для сервиса;
✅ Описание этой БД с помощью ER-диаграммы;
✅ Написание SQL-запросов.

Так как обе группы пилотные, цену участия поставил максимально низкую. В будущем цена будет выше.

👉 Для записи переходите по ссылке.

Для тех, кто не понимает, о каких интенсивах речь, подробности тут.

Системный анализ | Дмитрий Помаскин
  • 🔥 7
  • 👍 4
Post #112 650
❗️Собрал все посты про партиционирование в один, чтобы было удобнее искать.

🔸Что такое партиционирование в БД?
🔸Очистка устаревших данных в БД.
🔸Построение отчетов по регионам.
🔸Партиционирование при проведении A/B-тестирования.

P.S. Если вам было бы интересно в таком же формате послушать про шардирование, то ставьте 👍.

Системный анализ | Дмитрий Помаскин
  • 👍 13
  • 🔥 9
Post #111 654
🚩Кейс: Партиционирование при проведении A/B-тестирования.

ℹ️ Для удобной оценки эффективности новых алгоритмов лучше всего создавать партиции по сегментам пользователей. Тех пользователей, которые работают со старыми алгоритмами, относим в сегмент А. Тех, кто работает с новыми, относим в сегмент Б.

Таким образом получим:

✅ Быстрые выборки при агрегации метрик внутри сегмента (исследуемого алгоритма);
✅ Моментальное удаление тестовых данных после завершения тестирования.

Системный анализ | Дмитрий Помаскин
  • 👍 6
  • 🔥 5
Post #110 696
🚩Кейс: Построение отчетов по регионам.

ℹ️ Для решения такой задачи необходимо создавать партиции по ключу региона, это даст вам ряд преимуществ:

✅ Запрос от пользователя из конкретного региона будет сканировать только его партицию, что значительно ускорит построение отчета;
✅ Изоляция ресурсов при получении запросов по разным регионам в одно и тоже время;
✅ Партиция может полностью поместиться в локальный кэш, что существенно ускорит повторные запросы.

P.S. Не забывайте, что база для построения отчетов должна быть изолирована.
Пост на эту тему тут.

Системный анализ | Дмитрий Помаскин
  • 🔥 6
  • 👍 2
Post #109 704
Опять забыл подвести итоги месяца 😳

Перевалили за полсотни 😎🎉
  • 🔥 17
  • 👍 5
Post #108 823
🚩Кейс: Очистка устаревших данных в БД.

❌ Простой запрос на поиск устаревших данных может быть медленным и тяжеловесным на больший объемах.

✅ Удаление целой партиции - почти мгновенная операция, гораздо быстрее, чем DELETE по условию. Вместо удаления каждой записи, СУБД просто "отцепляет" партицию как отдельную таблицу (аналог DROP).

Алгоритм реализации:
1️⃣ Создаем партиции по необходимым периодам, например ежедневно или ежемесячно;
2️⃣ Процедура очистки находит партиции, подходящие по критерий "устаревших";
3️⃣ Партиция удаляется целиком, без поиска записей внутри неё.

P.S. Лучше делать ночью, так как в момент операции таблица блокируется целиком. Это нужно для согласованности метаданных.

P.P.S. Если вы пропустили пост про партиционирование,
жмите сюда :)

Системный анализ | Дмитрий Помаскин
  • 🔥 10
  • 👍 5
Post #107 775
❓Что такое партиционирование в БД?

ℹ️ Партиционирование — это метод разделения больших таблиц в базе данных на меньшие, более управляемые части для повышения производительности и упрощения работы с данными.

Основные типы партиционирования:
✅ По диапазону - данные разделяются по диапазону значений (например, по датам);
✅ По значениям - разделение по конкретным значениям атрибутов (например, по регионам);
✅ По хэшу - равномерное распределение по партициям с помощью хэш-функции.

P.S. Завтра расскажу реальный кейс, основанный на партиционировании.

Системный анализ | Дмитрий Помаскин
  • 🔥 12
  • 👍 6
Post #104 955
❓Есть ли гарантия доставки при использовании брокеров?

⚠️ На самом деле, брокеры не гарантируют нам доставку.
Они гарантируют, что сообщение не потеряется на уровне транспорта.

Для того, чтобы обеспечить гарантию доставки, нужны:
✅ Гарантия отправки сообщения продюсером - паттерн Transactional Outbox;
✅ Гарантия обработки сообщения консьюмером - механизм Back Pressure.

Чтобы не искать, ссылки тут👇
🔸Transactional Outbox;
🔸Back Pressure в RabbitMQ;
🔸Back Pressure в Apache Kafka.

Системный анализ | Дмитрий Помаскин
  • 🔥 8
  • 👍 4
Post #103 943
🚩Кейс: Балансировка нагрузки на консьюмерах (Back Pressure на примере Apache Kafka)

⚠️ Чтобы консьюмер не пытался обработать больше сообщений, чем позволяют его ресурсы, необходимо ограничить количество одновременно получаемых сообщений.

1️⃣ Отключить автоматический коммит оффсета на консьюмере. Коммитить оффсет вручную, только после успешной обработки полученных сообщений.

2️⃣ Установить параметр max.poll.records для ограничения числа сообщений, получаемых консьюмером за один раз — батч.

3️⃣ Убедиться, что консьюмер успевает обработать весь батч за отведённое время, установленное в параметре max.poll.interval.ms (по умолчанию 5 минут).


Системный анализ | Дмитрий Помаскин
  • 🔥 9
  • 👍 6
Post #101 997
🆕Хочу обсудить с вами запуск нового формата обучения — «Практический интенсив».

Как вы смотрите на онлайн-встречу в небольшой группе (от 4 до 6 человек)?

1. Один интенсив — одна тема и необходимый уровень. Например, "Проектирование БД (junior)".
2. Дату и время я объявлю заранее, а также открою запись.
3. Длительность — 3-4 часа.

Как будет проходить онлайн-занятие:
1. Теоретическая часть (20-30 минут).
2. Практическая: разбираем подробно несколько кейсов (20-30 минут).
3. Самостоятельная работа: участники решают практические задания (60-90 минут).
4. Итоги: вместе проверяем решения всех участников с разбором каждого варианта (60-90 минут).

Все материалы (запись конференции, задания с моими исправлениями и презентация) остаются вам.

Системный анализ | Дмитрий Помаскин
  • 🔥 17
  • 👍 8
  • 👏 1
Post #100 945
❓Что выбрать при проектировании: синхронное или асинхронное взаимодействие?

Синхронное:
1️⃣ Клиент не может продолжать работу без ответа от сервера;
2️⃣ Простота разработки и отладки приоритетнее масштабируемости и высокой пропускной способности;
3️⃣ Транзакционность - жесткая последовательность исполняемых операций.

Асинхронное:
1️⃣ Исполнение длительных операций;
2️⃣ Требуется высокая пропускная способность и масштабируемость интеграции;
3️⃣ Необходимость снижения связности компонентов системы;
4️⃣ Исполнение фоновых задач.

Системный анализ | Дмитрий Помаскин
  • 🔥 9
  • 👍 5
Post #99 923
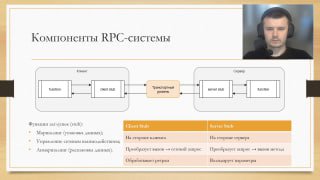
❓Знаете ли вы, как RPC работает на самом деле?

ℹ️ Ловите небольшой фрагмент из модуля, посвящённого интеграциям через RPC, в котором объясняю, как взаимодействуют компоненты и какие функции они выполняют.

Системный анализ | Дмитрий Помаскин
  • 🔥 11
  • 👍 5
  • 👏 1
Post #98 1.11K
Post #97 873
🚩Кейс: Распил монолита на микросервисы (этап 7). Финальный :)

1️⃣ Необходимо провести рефакторинг REST API для взаимодействия микросервисов и фронта.

2️⃣ Минимизировать количество вызовов. Если фронт где-то использует несколько неоптимальных методов, то объединить их в один.

3️⃣ Снизить оверфетчинг. Это ситуация, когда клиент получает больше данных, чем ему действительно нужно для выполнения конкретной задачи.

Предыдущие части:
👉Этап 1;
👉Этап 2;
👉Этап 3;
👉Этап 4;
👉Этап 5;
👉Этап 6.

Системный анализ | Дмитрий Помаскин
  • 👍 7
  • 🔥 7
  • 👏 3
Post #96 810
🚩Кейс: Балансировка нагрузки на консьюмерах (Back Pressure на примере RabbitMQ)

⚠️ Чтобы консьюмер не пытался обработать больше сообщений, чем позволяют его ресурсы, необходимо ограничить количество одновременно получаемых сообщений.

1️⃣ Использовать параметр prefetch_count для ограничения числа поступающих сообщений на консьюмер.

2️⃣ Консьюмер получит указанное число сообщений.

3️⃣ Консьюмер вернёт ack (подтверждение) брокеру только после обработки всех полученных сообщений.

4️⃣ После получения ack брокер отправит следующую партию сообщений, соблюдая заданный prefetch_count.

P.S. В следующих видео расскажу про Back Pressure в Kafka.

Системный анализ | Дмитрий Помаскин
  • 🔥 9
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →