TGViewer
Channel Public Channel
sysadmin.su

sysadmin.su

@sysadminsu

Админам/sre/devops’ам будет интересно!
Subscribers
329
Photos
325
Videos
32
Links
2.2K

Showing posts older than #2562 · Back to latest

Older Posts 18 shown
Post #2561 324

Forwarded from Timur Tukaev

Тут Кирилл опять прошерстил все записи SIGов, поковырялся во всех KEPах и выдал базу про кишки Kubernetes 1.35. Даже если на буржуйском читаете, уверен, тут найдете много подробностей, которых на английском ни в статьях, ни в подкастах нет: https://habr.com/ru/companies/flant/articles/976746/
Хабр В Kubernetes теперь можно совмещать hostNetwork: true и hostUsers: false и планировать поды группами. Обзор фич K8s 1.35 Сегодня официально выпустили новую версию Kubernetes — 1.35. Среди главных нововведений — декларирование поддерживаемых фичей узлами, возможность запускать поды в сети хоста, одновременно...
Post #2560 249

Forwarded from Коробочка хорони

Kubernetes 1.35 — что завезли
⭐️ Стабильно в прод
• In-place Pod Resize — наконец-то GA! Можно менять requests/limits (CPU/RAM) на лету без рестарта пода. Киллер-фича для тяжелых stateful-приложений и AI-инференса (вертикальный автоскейлинг без даунтайма).
• Traffic Distribution — стратегия PreferSameNode теперь stable. Трафик сервиса старается не покидать узел, если эндпоинт есть локально. Минус хоп — ниже latency.
• Job ManagedBy — залочили в true. Упрощает жизнь внешним контроллерам (Kueue и прочим ML-оркестраторам), которые управляют джобами.
🧪 Беты (почти готово)
• Pod Certificates — Kubelet научился сам выпускать и ротировать X.509 сертификаты для подов. Нативный mTLS/Workload Identity без лишних сайдкаров.
• Job Recovery — теперь можно менять ресурсы (CPU/Mem) у Suspended Job’ов. Если ML-обучение упало с OOM через 5 часов — ставим на паузу, накидываем памяти и продолжаем, не пересоздавая объект.
🤖 AI и Альфы (пощупать)
• Gang Scheduling — нативная поддержка "all-or-nothing". Критично для распределенного ML-обучения: запускать группу подов только если есть ресурсы на всех сразу, иначе не запускать ничего. Реализовано через новый Workload API.
• Node Declared Features — ноды сами сообщают планировщику, какие фичи поддерживают. Помогает, когда в кластере зоопарк версий или разное железо.
• Restart Policies — новая логика RestartAllContainersOnContainerExit: если упал основной контейнер (app), куб пристрелит и сайдкары (логи/прокси), чтобы под перезапустился целиком.
🛡️ Ломают/Убирают
• IPVS в kube-proxy — всё, deprecated. Рекомендуют мигрировать на nftables.
• Gogo Protobuf — вычистили из API-типов.

https://kubernetes.io/blog/2025/12/17/kubernetes-v1-35-release/
Post #2559 283

Forwarded from Технологический Болт Генона

Cloudflare выложили разбор вчерашнего инцидента

Cloudflare outage on December 5, 2025
https://blog.cloudflare.com/5-december-2025-outage/

Попробую кратко описать чо там у них случилось, если где-то неправильно понял, то поправьте в комментариях

Как и писал CTO (https://t.me/tech_b0lt_Genona/5926), они катили изменения для того, что бы закрыть свежую и нашумевшую уязвимость React'а (https://t.me/tech_b0lt_Genona/5918, https://t.me/tech_b0lt_Genona/5923)

Для этого они провели два действия:

- Они обнаружили что балалайка, котрая тестирует их WAF не поддерживает нужный размер буфера тела HTTP-запроса, поэтому они её отключили (нужен был 1 MB, а умела только 128 KB)

- Выкатили практически моментально на все сервера изменения. Если я понял правильно, то они так настроили/сделали систему конфигурации после прошлого отвала - https://t.me/tech_b0lt_Genona/5885

Как и в прошлый раз, сейчас тоже упоминаются две реализации их прокси - FL1 (старая, я не помню на чём, но там есть Lua) и FL2 (новая на Rust)

FL1 стало плохо после отключения балалайки, которая тестировала WAF и его правила, и начала "пятисотить". Происходило это из-за того, что поломался кусок, который отвечал за правила (Lua часть)

[lua] Failed to run module rulesets callback late_routing: /usr/local/nginx-fl/lua/modules/init.lua:314: attempt to index field 'execute' (a nil value)


И это объясняет почему у части работало всё нормально, а у части нет. Проблем не было у тех чей трафик шёл через FL2

> Customers that have their web assets served by our older FL1 proxy AND had the Cloudflare Managed Ruleset deployed were impacted

> Customers that did not have the configuration above applied were not impacted. Customer traffic served by our China network was also not impacted.

Когда CF увидели, что всё посыпалось, то вообще должна была отработать система "отката". Но что-то пошло не так 🌝

Правила, когда отрабатывают, то выполняются определённые действия (в том числе и к трафику)

> Typical actions are “block”, “log”, or “skip”. Another type of action is “execute”, which is used to trigger evaluation of another ruleset.

Но как выяснилось они никогда не откатывали аварийно правила с типом execute и при откате сломавшего всё нового правила возникла ошибка в логике

if rule_result.action == "execute" then
rule_result.execute.results = ruleset_results[tonumber(rule_result.execute.results_index)]
end


> This code expects that, if the ruleset has action=”execute”, the “rule_result.execute” object will exist. However, because the rule had been skipped, the rule_result.execute object did not exist, and Lua returned an error due to attempting to look up a value in a nil value.

В FL2 проблемы не существовало такой, потому что, цитирую

> This is a straightforward error in the code, which had existed undetected for many years. This type of code error is prevented by languages with strong type systems.

Как утверждается в посте, что они извлекли уроки от прошлого масштабного падения и начали вносить изменения, но не успели за две недели доделать.

Короче, растпобеда случилась 🗿
Post #2557 321

Forwarded from /usr/bin

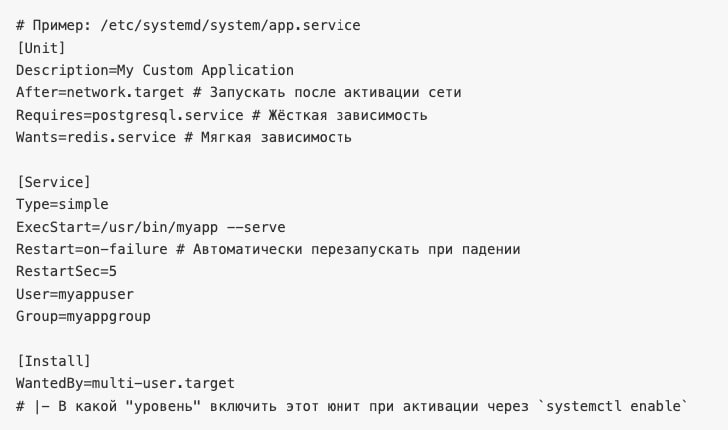
Systemd: полное руководство для админов + примеры

Systemd — скелет современного Linux. Он управляет не только службами, но и таймерами, монтированием, логированием. Понимать его = значительно повысить эффективность администрирования системы. Эта статья — исключительно технические аспекты: архитектура, юниты, cgroups, работа с журналами. Только команды и конфиги.

@usr_bin_linux
Post #2555 365

Forwarded from DevOps

📌 Git Revert vs Git Reset: В чём разница? 🔄

Когда вы делаете ошибку в Git, важно понимать, как правильно её исправить. Два самых популярных способа — git revert и git reset. Но они работают по-разному!

### 🔹 Git Revert
- Создаёт новый коммит, который отменяет изменения из проблемного коммита.
- История сохраняется полностью — всё видно, даже ошибка.
- Безопасный вариант для публичных веток (например, `main`).
- Не удаляет коммиты — просто "откатывает" их эффект.

> 💡 Пример:
> C1 → C2 → C3 (ошибка) → C4: Revert C3
> Результат: ошибка отменена, но история остаётся полной.

🔹 Git Reset
- Удаляет коммит(ы) из истории.
- Изменяет историю репозитория — может быть опасно, если уже был пуш.
- Подходит только для локальных изменений или ещё не опубликованных коммитов.
- Есть три режима: soft, mixed, hard.

> 💡 Пример:
> C1 → C2 → C3 (ошибка) → C3 убрано
> Результат: история обрезана, как будто коммит никогда не был.

💡 Вывод:
revert — безопасный и прозрачный способ отменить изменения.
reset — мощный инструмент, но требует осторожности.

📌 Понимание этих команд — ключ к уверенной работе с Git!

#Git #DevOps #Programming #SoftwareEngineering
Post #2553 305

Forwarded from Человек и машина

#машины_aws

Пожалуй, лучший инцидент, что я когда либо видел.

Если вкратце:
1. Управление DNS записями для DynamoDB отвалилось, в итоге:
2. Эндпоинты DynamoDB (в том числе для внутреннего пользования) отвалились, в итоге:
3. Storage backend, которым выступала DynamoDB, одного из компонентов control plane EC2 отвалился, в итоге:
4. Отвалился NLB, который не мог следить за событиями EC2.

Очень радует, что AWS решил минимальными усилиями решить конкретную проблему, а не сделать отдельный внутренний Kinesis как тогда с инцидентом CloudWatch и Cognito.


Да и не пользуйтесь us-east-1, сколько еще повторять. Новые фичи раньше всех того не стоят.
Post #2550 259

Forwarded from Безумный кот

https://t.me/bezumniy_kot_work/10

🚀 Kubernetes The Hard Way — по-настоящему

Почти два года, тысячи перезапусков, багов, а также сотни пересобранных кластеров и море мата (в голове 😅) — и всё это вылилось в одну, но очень насыщенную статью.
Kubernetes вручную, от и до, без kubeadm и прочих поблажек.

Я собрал: — полный пошаговый гайд по сборке Kuberentes.
— удобные alias’ы, функции и обёртки
— десятки скриптов, которые реально работают в бою
— важные моменты, о которых молчат в туториалах

🔥 Всё это оформлено в удобной документации на MDX структуре, с фокусом на читаемость и практику.

Полную статью можно почитать здесь 👉 Ссылка Тут
Фидбек и звездочки Github приветствуется 🙌
Post #2547 190

Forwarded from Технологический Болт Генона

FlowExporter is a sidecar that runs alongside all Netflix workloads in the AWS Cloud. It uses eBPF and TCP tracepoints to monitor TCP socket state changes. When a TCP socket closes, FlowExporter generates a flow log record that includes the IP addresses, ports, timestamps, and additional socket statistics. On average, 5 million records are produced per second.
. . .

FlowCollector, a backend service, collects flow logs from FlowExporter instances across the fleet, attributes the IP addresses, and sends these attributed flows to Netflix’s Data Mesh for subsequent stream and batch processing.
. . .
As noted in our previous blog post, our initial attribution approach relied on Sonar, an internal IP address tracking service that emits an event whenever an IP address in Netflix’s AWS VPCs is assigned or unassigned to a workload.
. . .
Attributing local IP addresses for container workloads running on Netflix’s container platform, Titus, is more challenging. FlowExporter runs at the container host level, where each host manages multiple container workloads with different identities. When FlowExporter’s eBPF programs receive a socket event from TCP tracepoints in the kernel, the socket may have been created by one of the container workloads or by the host itself. Therefore, FlowExporter must determine which workload to attribute the socket’s local IP address to. To solve this problem, we leveraged IPMan, Netflix’s container IP address assignment service.

How Netflix Accurately Attributes eBPF Flow Logs
https://netflixtechblog.com/how-netflix-accurately-attributes-ebpf-flow-logs-afe6d644a3bc

Предыдущий пост из этой серии
How Netflix uses eBPF flow logs at scale for network insight
https://netflixtechblog.com/how-netflix-uses-ebpf-flow-logs-at-scale-for-network-insight-e3ea997dca96

Спасибо подписчику за наводку
Post #2546 283
"я колеблюсь между двумя состояниями - положить хер на прод и положить прод нахер" (с)

#humor
Post #2544 317

Forwarded from Виталий

#release Собрал и выложил версию 2.3.0

Новые фичи:

- Поддержан новый метод монтирования ядерных блочных устройств - ublk. Самый быстрый по iops, не всегда самый быстрый по МБ/с (vduse иногда быстрее)
- На ядрах, которые это умеют (6.15+), OSD теперь не будут помечаться как поедающие 100% cpu iowait.
- Добавлена возможнось проверки привилегий на стороне VitastorFS NFS-сервера (по умолчанию клиент Linux NFS их не проверяет).
- Добавлена опция qemu_file_mirror_path для обмана Veeam (собрана пока что в версиях для proxmox 8 и 9).
- Ускорен расчёт CRC32C на стороне OSD сначала исправлением многократного вызова cpuid, а потом вообще задействованием версии из ISA-L с поддержкой AVX512. IOPS-ы записи выросли на ~20%. 😊
- Убрана повторная перезапись одних и тех же блоков - без этого, по отчёту с github, происходило повреждение данных на одной специфической модели SSD: Memblaze PBlaze5 910 (#79)
- Добавлена поддержка QEMU 10, Debian 13 Trixie и Proxmox 9.0
- Ликвидирована зависимость от системного liburing, он теперь по умолчанию собирается статически

Исправления тоже прикольные:

- Контрольные суммы, судя по всему, никогда не включались в vitastor-disk, даже когда это запрашивалось явно. Просто не пробрасывалась опция 😊
- Теперь vitastor-nfs использует uid и gid из заголовка NFS AUTH_SYS - до этого при создании файла/каталога под каким-то пользователем он создавался под root и, например, в случае реэкспорта через samba, пользователь не мог его потом поменять
- Исправлена теоретическая возможность повреждения bitmap-ов объектов в редких случаях при использовании EC N+2+ (т.е. N+K где K >= 2)
- Исправлен баг в antietcd, из-за которого при перезапуске всех osd и мониторов в antietcd оставались старые ключи /osd/state (lease не удаляли истекшие ключи корректно)
- Исправлена cookie записи ".." в NFS - она должна быть 1, а не 0
- Снимки не удалялись при удалении ВМ в Proxmox (тоже PR с гитхаба, #85)
- Исправлена некорректная фильтрация OSD для пула по размеру блока монитором

https://git.yourcmc.ru/vitalif/vitastor/releases/tag/v2.3.0
GitHub [vitastor-osd] data inconsistency using certain hardware · Issue #79 · vitalif/vitastor hi, @vitalif We ran into a weird case testing with vitastor-cli dd command, the image data becomes inconsistent after restarting osd. Vitastor Version 2.2.2 OS Version linux 5.10.0-19.el7 Device In...
  • 👍 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →