
Яндекс выложил в опенсорс AliceAI-Foundation-80B-A3B-Base: базовую модель, обученную с нуля
21 сентября Яндекс опубликовал на Hugging Face веса AliceAI-Foundation-80B-A3B-Base под лицензией Apache 2.0. Компания подчёркивает, что модель обучена со случайной инициализации, без весов сторонних опенсорс-моделей, на собственной архитектуре и собственном корпусе данных. Это именно базовая модель, то есть результат претрейна без пост-обучения и выравнивания. Яндекс позиционирует её как основу для исследований и дообучения, а не как готового ассистента. В репозитории есть пример дообучения через LoRA.
Архитектура
Модель построена на смеси экспертов (MoE): всего 80 млрд параметров, но на каждый токен работают только 3 млрд. В каждом из 48 слоёв 512 маршрутизируемых экспертов, из которых выбираются десять, плюс один общий эксперт. Балансировка маршрутизации устроена без вспомогательной функции потерь, по схеме из DeepSeek-V3. Самое интересное здесь в механизме внимания. Он гибридный: на каждые три слоя с линейным вниманием Kimi Delta Attention (KDA) приходится один слой полного внимания с гейтингом. KDA хранит историю в состоянии фиксированного размера вместо растущего KV-кэша, поэтому длинный контекст обходится дешевле. Окно контекста составляет 262 144 токена. Обучали оптимизатором Muon. Архитектурные решения Яндекс предварительно проверял на серии отдельных обучений с нуля, по 2 трлн токенов каждое.
Как обучали
По данным статьи на Хабре, модель прошла около 18 трлн токенов в несколько этапов. Основной претрейн занял 17,5 трлн токенов с контекстом 8K. Затем контекст расширяли до 32K и 256K, а в финале на 280 млрд токенов прогнали данные с рассуждениями при контексте 128K. В корпус входят веб, математика, код, длинные документы, рассуждения и траектории взаимодействия агентов с инструментами. Команда делится и наблюдениями. Одних данных с рассуждениями в претрейне не хватает, чтобы у модели появились агентные навыки. Лосс на валидации плохо предсказывает итоговые метрики на бенчмарках. А расширение контекста до 256K дало меньше, чем ожидали.
Результаты
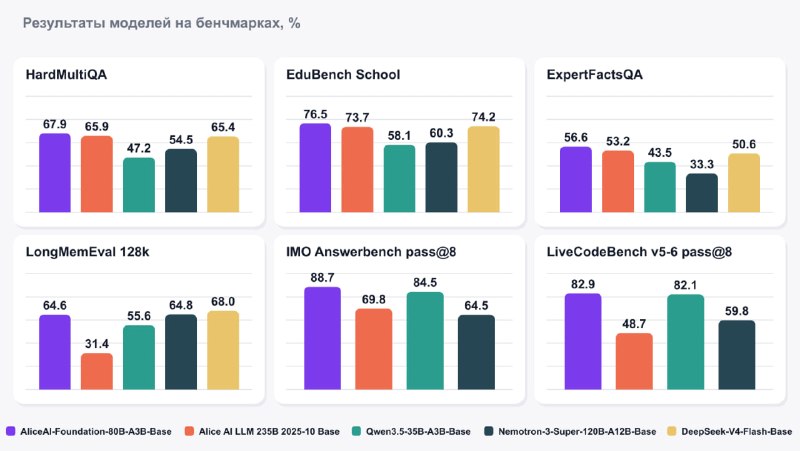
Яндекс сравнивает модель с базовыми версиями Qwen3.5-35B-A3B, GLM-4.5-Air (106B/12B активных), Nemotron-3-Super-120B-A12B и DeepSeek-V4-Flash (284B/13B активных). Все цифры получены самим Яндексом. Сильнее всего модель выглядит на русскоязычных знаниях. На WikiWebFacts у неё 86,5 против 83,2 у DeepSeek-V4-Flash и 62,4 у Qwen3.5. На HardMultiQA 67,9 против 65,4 и 47,2. В экспертных вопросах по праву разрыв ещё больше: 49,6 против 40,5 у DeepSeek. На MATH-500 модель набрала 91,1 при 84,8 у Nemotron и 80,7 у DeepSeek. На LiveCodeBench она фактически вровень с Qwen3.5 и Nemotron (50,5 против 50,4). На англоязычных задачах на знания модель уступает: на TriviaQA у неё 79,0 против 89,8 у Nemotron, а на MMLU-Pro и SuperGPQA она позади Nemotron и DeepSeek. На длинном контексте в LongMemEval 128k лидирует DeepSeek (68,0 против 64,6).
Два новых бенчмарка
Вместе с моделью Яндекс выложил два русскоязычных бенчмарка на фактологию с вопросами, эталонными ответами и протоколом оценки под лицензией CC BY-SA 4.0. WikiWebFacts содержит 1365 вопросов с короткими ответами. Примерно половина вопросов основана на популярных статьях русской Википедии, вторая половина на запросах в Яндекс Поиске, а ответы проверяли эксперты. HardMultiQA включает 670 сложных вопросов, которые эксперты составили по темам пользовательских запросов к Алисе. Там пять форматов: выбор вариантов, открытый ответ, строгие и нестрогие списки, поиск и исправление ошибок. Оба бенчмарка оцениваются по схеме LLM-as-a-judge, судьёй выступает Qwen3.5-35B-A3B. Предусмотрены два режима: few-shot для базовых моделей и инструктивный для выровненных.
Post #1338
166
- ❤ 3