TGViewer
Channel Public Channel
Synaptic Garden

Synaptic Garden

@synaptic_garden

От байтов к бытию — и обратно

Авторский канал об AI, науке и роли человека в быстро трансформирующемся мире. Исследую связи между технологиями, философией и искусством. Делюсь инсайтами из мира ИИ и размышлениями о технологическом будущем.

@darkgenius
Subscribers
534
Photos
420
Videos
193
Links
1K
Recent Posts 20 shown
Post #1336 74
Xiaomi выпустила семейство MiMo-V2.6 из двух моделей: флагманской MiMo-V2.6-Pro и более дешёвой MiMo-V2.6-Flash. Обе нативно работают с текстом, изображениями, видео и аудио и поддерживают контекст до 1 млн токенов. Pro построена на разреженной MoE-архитектуре с 1,02 трлн параметров, из которых при инференсе активируются 42 млрд, а Flash — с 309 млрд и 15 млрд активных параметров соответственно. Веса опубликованы на Hugging Face под лицензией MIT.

Главный акцент релиза Xiaomi делает не на увеличении модели, а на масштабировании обучения с подкреплением. Pro и Flash прошли по 30 крупных RL-шагов примерно на 750 тысячах траекторий каждый. Один шаг включал до 1568 задач с 16 попытками решения и несколько миллиардов токенов. При этом в одном обучающем процессе одновременно смешивались программирование, работа агентов, визуальные задачи и кибербезопасность — вместо отдельных специализированных этапов RL. На весь такой прогон Xiaomi потратила около $2,62 млн для Pro и $0,85 млн для Flash.

Отдельная часть работы посвящена тому, как оценивать уже правильные решения. Обычная награда «прошёл тест / не прошёл» не позволяет модели понять, какое из нескольких успешных решений лучше. Xiaomi поэтому добавила агентного оценщика, который сравнивает траектории между собой и отдаёт преимущество более качественным, коротким и эффективным вариантам. Компания рассматривает эту схему как шаг к циклу самосовершенствования, в котором улучшение самой модели одновременно позволяет получать более точный обучающий сигнал для следующих итераций.

Результаты получились заметными. На закрытом от обучения DeepSWE v1.1 показатель Pro вырос в ходе RL примерно с 58,4 до 72,6, а Flash — с 48,8 до 65,7. В итоговых тестах Pro набирает 71,9 на DeepSWE v1.1 против 74 у Claude Opus 5 и 73 у GPT-5.6 Sol. На Artificial Analysis Intelligence Index модель получила около 46 баллов и на момент релиза стала самой высокооценённой моделью с открытыми весами в этом рейтинге. Независимые результаты Artificial Analysis также показывают скорость около 134 токенов/с через API Xiaomi.

Но Xiaomi позиционирует MiMo-V2.6 уже не просто как языковую или кодовую модель. В демонстрациях она самостоятельно собирает 3D-сцены и игры из текста, изображения или видео, управляет роботизированной рукой по видеопотоку, создаёт интерфейсы и презентации, работает с Figma, генерирует и монтирует видео и даже пишет музыкальные произведения с экспортом в MIDI. В исследовательских примерах Pro помогла подобрать кандидатов новых материалов для связывания PFAS и участвовала в формализации в Lean 4 основной теоремы из классической работы Ли и Йорка «Period Three Implies Chaos» — итоговый проект превысил 6000 строк и был полностью проверен ядром Lean.

API при этом осталось довольно дешёвым: MiMo-V2.6-Flash стоит $0,14 за миллион входных и $0,28 за миллион выходных токенов, Pro — $0,435 и $0,87 соответственно. Для Pro также появился режим UltraSpeed, который Xiaomi заявляет как до 20 раз более быстрый, но токены в нём стоят в десять раз дороже. Модели уже доступны через API Xiaomi, MiMo Desktop, MiMo Code, AI Studio и OpenRouter, а веса, технический отчёт, RL-код и обучающие среды опубликованы для самостоятельного запуска и изучения.
Post #1335 154
SpaceXAI представила Grok 4.7 — флагманскую модель, ориентированную на задачи программирования и сложную интеллектуальную работу. Релиз базируется на увеличенной базовой архитектуре и расширенном цикле обучения с подкреплением, где акцент сделан на многочасовых процессах, глубоком контексте и способности модели самостоятельно верифицировать результат. Кроме того, Grok 4.7 изначально оптимизирован для взаимодействия с инфраструктурой Grok Bot, что улучшило диалоговые навыки и работу с общими базами знаний.

В тестах на написание кода и автоматизацию рутинных офисных процессов (включая бенчмарки CursorBench 4.0, DeepSWE, AA Briefcase и юридические тесты Harvey Legal Agent) модель демонстрирует показатели, сопоставимые с передовыми решениями на рынке, сохраняя высокое соотношение эффективности и стоимости. Grok 4.7 существенно лучше предыдущей версии справляется с созданием аналитических документов, презентаций и решением профильных задач в сфере юриспруденции, финансов и электротехники.

Существенное внимание разработчики уделили безопасности и защите от взлома промптов. В архитектуру внедрен обновленный защитный стек, снизивший долю опасных ответов в кибербезопасности до минимума при сохранении доступа к легитимным исследовательским операциям. Дополнительно запущен закрытый партнерский доступ к возможностям модели в рамках оборонительных red-team сценариев.

Доступ к Grok 4.7 открыт через Cursor, Grok Build, официальный API и облачные платформы. Ценовая политика сохранена на уровне предшественника и составляет два доллара за миллион входных и шесть долларов за миллион выходных токенов, при этом для высоконагруженных задач предлагается ускоренная версия с удвоенной скоростью генерации по двойному тарифу.
  • ❤ 3
Post #1334 164
Появился сайт, на котором приведены ссылки на множество примеров использования Jev: https://jevable.com
  • 🔥 1
Post #1333 185
Команда Qwen опубликовала веса Qwen-Image-2.1 — новой модели, которая объединяет генерацию изображений по тексту и редактирование уже существующих картинок. Непосредственно генеративная часть содержит 7 млрд параметров и состоит из 32 слоёв Single-Stream DiT, а для понимания текста и референсных изображений используется Qwen3-VL 8B. Модель нативно работает с разрешением до 2K.

Одна из главных особенностей Qwen-Image-2.1 — полноценная работа с прозрачностью. Модель умеет сразу генерировать изображения с альфа-каналом в RGBA, редактировать прозрачные изображения и извлекать отдельные объекты из обычных фотографий. То есть для создания стикеров, элементов интерфейса или товарных изображений больше не обязательно отдельно прогонять результат через модель удаления фона. За это отвечает специальный 64-канальный RGBA-VAE с 16-кратным пространственным сжатием.

Сильно расширились и возможности редактирования. В одном запросе можно использовать до десяти референсных изображений, например собрать общую фотографию из отдельных портретов или перенести на человека одежду и аксессуары с нескольких разных картинок. Нужную область можно указать обычным кружком или нарисованной пометкой либо передать отдельную маску. Qwen также отдельно улучшила сохранение внешности людей и вида товаров при изменении сцены. В демонстрациях модель превращает селфи в панораму, строит раскадровки по трём видам персонажа и одновременно меняет несколько отмеченных областей изображения.

В собственном Qwen-Image-Bench модель получила 60,28 балла, несмотря на сравнительно небольшую 7B генеративную часть. Сам бенчмарк создан Qwen совместно с художниками и оценивает качество, эстетику, соответствие промпту, реалистичность и творческие способности.

Весы уже доступны для локального запуска, а поддержку в день релиза получили Diffusers, ComfyUI, vLLM-Omni и SGLang. При этом есть существенное отличие от предыдущих релизов семейства: Qwen-Image-2.1 распространяется не под Apache 2.0, а под Qwen Research License. Она разрешает использование модели только для исследований и оценки; для коммерческого применения необходимо отдельно получить лицензию у Qwen. Поэтому корректнее говорить об открытых весах модели, а не о полностью свободной open-source модели.

🔗 Hugging Face | GitHub | Демо
  • 🔥 1
Post #1332 212
PrismML ужала Qwen3.8 27B до 5,9 ГБ с трёхзначными весами

PrismML выпустила Ternary Bonsai 2 27B — новую версию своей сверхнизкобитной локальной модели на базе Qwen3.8 27B. Вместо обычных 16-битных весов здесь используются всего три значения: −1, 0 и +1, дополненные групповым масштабированием FP16. В результате эффективная точность составляет около 1,76 бита на вес, а языковая часть модели занимает 5,9 ГБ вместо примерно 54 ГБ у FP16-версии. Контекст — до 262 тысяч токенов, модель умеет работать с изображениями и выпущена под Apache 2.0.

Главный результат PrismML — качество при столь агрессивном сжатии. На наборе из 20 тестов по математике, программированию, рассуждениям, следованию инструкциям, зрению и работе с инструментами Bonsai 2 набрала 83,9 балла против 85,4 у исходной Qwen3.8 27B. Компания называет это сохранением 98,2% качества. Особенно небольшой разрыв заявлен в математике и обычных задачах программирования. Для сравнения, традиционная двухбитная квантизация той же модели, по тестам PrismML, деградирует заметно сильнее.

Но у цифры 98,2% есть важная оговорка. Она относится к усреднённому набору тестов и не включает некоторые наиболее тяжёлые агентные сценарии. На Terminal-Bench 2.1 Bonsai 2 получила 52,8 против 69,7 у полной модели, а на SWE-bench Verified — 60,8 против 80,6. То есть в длительных цепочках действий и автономной разработке сохраняется уже около трёх четвертей результата исходной модели. Пока это в основном собственные измерения PrismML, полноценного независимого воспроизведения результатов ещё нет.

Зато требования к железу действительно необычные для модели такого размера. PrismML заявляет до 143 токенов/с на RTX 5090 и около 47 токенов/с на M5 Max. Уже появились и пользовательские тесты: Bonsai 2 удалось запустить даже на 8-гигабайтном M2 Mac mini с сильно ограниченным запасом памяти, а владельцы дискретных GPU сообщают о десятках токенов в секунду. Это пока скорее первые практические наблюдения, чем систематические тесты.

Технически 5,9 ГБ — это только плотно упакованные языковые веса GGUF: для мультимодальности отдельно нужен vision-модуль примерно на 0,6–0,9 ГБ. Есть также более быстрый вариант упаковки на 7,2 ГБ и MLX-версия для Apple Silicon размером 8,6 ГБ вместе с визуальной частью. Кроме того, низкобитные форматы Bonsai 2 пока требуют специальных ядер PrismML и их сборки llama.cpp, так что это ещё не совсем модель из категории «скачал любой GGUF и запустил где угодно».

Если заявленные результаты подтвердятся независимыми тестами, Bonsai 2 интересна прежде всего не как замена облачным фронтирным моделям, а как демонстрация того, насколько далеко можно сжать достаточно сильную 27B-модель. По сути, PrismML пытается получить качество крупной локальной модели в объёме памяти, который ещё недавно был территорией моделей на 7–8 млрд параметров.
  • 👍 1
  • 🔥 1
Post #1330 225
Step 5 Preview — 600 млрд параметров и ставка на долгоживущих агентов

Китайская StepFun представила Step 5 Preview — новую флагманскую модель, которую компания проектировала прежде всего для реальных агентных задач: программирования, разработки ПО, исследований, работы с финансами и других сценариев, где модели нужно долго работать с большим контекстом, вызывать инструменты и самостоятельно выполнять цепочки действий. Step 5 построена на разреженной MoE-архитектуре: всего в ней 600 млрд параметров, но на каждый токен активируются только 27 млрд. Контекстное окно достигает 1 млн токенов, модель принимает текст и изображения. API и StepFun Studio уже открыты, а веса компания обещает опубликовать 15 октября.

В независимом Artificial Analysis модель получила 44 балла в Intelligence Index. Там же измерили скорость примерно в 100 выходных токенов в секунду и цены в $1 за миллион входных и $2,70 за миллион выходных токенов. StepFun делает именно сочетание качества и стоимости центральной частью релиза и называет Step 5 новым шагом на «границе Парето»: идеей в том, что улучшить соотношение интеллекта, скорости и цены одновременно становится всё сложнее.

По официальным тестам Step 5 Preview набрала 93,5% на GPQA Diamond, 85% на Terminal-Bench v2.1, 88,7% на BrowseComp и 76% на MMMU-Pro. Особенно StepFun выделяет агентные и профессиональные задачи: 29,5% на компьютерном ALE-CLI, 66,4% на финансовом FrontierFinance и 83,3% на тесте глубокого исследования DRACO. При этом картина не везде одинаковая: например, на более сложном Terminal-Bench v4 модель получила 33,3%, заметно уступив GPT-6 Astra и Claude Opus 5. Часть опубликованных StepFun тестов, включая StepCodeBench и FinStepBench, разработаны самой компанией, поэтому их результаты разумнее воспринимать как предварительные до независимого воспроизведения.

Самая интересная часть анонса связана не с короткими бенчмарками, а с экспериментами на многочасовых задачах. StepFun дала модели до 24 часов на автономную оптимизацию GPU-ядер: агент самостоятельно менял код, запускал тесты, сравнивал результаты и продолжал итерации. Примерно через 22 часа производительность оптимизированного MLA-ядра достигла 508 TFLOPS против 493 TFLOPS у Claude Opus 5 в эксперименте StepFun. В другом 24-часовом опыте Step 5 самостоятельно проектировала данные для постобучения Qwen3-30B-A3B и подняла результат модели на AIME 2024 с 53,3% до 60%.

Таким образом, Step 5 Preview интересна не столько очередным увеличением числа параметров, сколько инженерной комбинацией из очень разреженной MoE, миллионного контекста и обучения под продолжительную агентную работу. Если результаты многочасовых экспериментов подтвердятся после выхода весов и независимых тестов, это будет ещё одним признаком смещения конкуренции между крупными моделями от «кто лучше отвечает на запрос» к «кто способен часами самостоятельно выполнять настоящую работу».
  • ❤ 2
Post #1329 213
Бесплатный доступ к Jev через лист ожидания можно получить на сайте непосредственно вендора TypeSafe
  • 🔥 2
Post #1328 225
Vercel сообщила, что хайповая Jev – наиболее успешная модель с точки зрения роста числа запросов за 1 день через ее AI Gateway за всю историю сервиса. В честь этого Vercel открывает бесплатный доступ к модели до 25 сентября.
  • 🔥 3
Post #1326 519
MiniMax выложили свой харнесс в опенсорс. Агент с большим отрывом обошёл конкурентов на FrontierHarness Eval.
  • 🔥 3
  • ❤ 1
Post #1325 347
Вышел Bend — язык программирования для создания кода, устойчивого к ошибкам ИИ.

Bend решает проблему «галлюцинаций» и багов математически. Разработчик формулирует инварианты («законы») предметной области (например, «баланс пользователя никогда не может стать отрицательным» или «ни одна последовательность ходов не ломает состояние игры»). Компилятор требует математического доказательства того, что сгенерированная реализация строго соблюдает эти законы (по аналогии с системами верификации математических доказательств Lean, Rocq/Coq, Agda). ​Если ИИ-агент напишет код с багом, нарушающим заявленный закон, компилятор просто отклонит сборку. Выкатить в прод код с нарушением инварианта становится математически невозможно.

Помимо этого язык поддерживает автоматический массовый параллелизм без потоков и блокировок.
  • 🔥 10
  • 👎 1
Post #1324 370
Moonshot AI выпустила десктопную версию Kimi Code. Есть встроенный браузер и remote control. Можно подключить стороннего API-провайдера.
  • ❤ 1
Post #1323 302
Команда Qwen представила Qwen3.8-Omni-Flash — новое поколение нативной оммимодальной модели, ориентированной на переход от пассивного восприятия аудиовизуального контента к автономному планированию задач, вызову внешних инструментов и полному циклу создания медиаматериалов. Модель поддерживает контекстное окно в один миллион токенов для текста, изображений, звука и видео, сохраняя текстовую производительность на уровне специализированных текстовых аналогов того же масштаба и демонстрируя прирост более двадцати пяти процентов по сравнению с Qwen3.5-Omni-Plus по совокупности тестов. При этом стоимость обработки аудио по API снизилась более чем на девяносто восемь процентов, а видео — более чем на девяносто три процента, что сделало мультимодальную работу значительно доступнее и позволило модели обойти Gemini 3.8 Flash по качеству обработки звука при сопоставимой работе с видеорядом.
  • ❤ 1
Post #1322 255
Команда QuiverAI представила Arrow 2.0 — крупное обновление своей платформы для генерации и обработки векторной графики, ключевой философией которой остается создание векторных ассетов через программный код с опорой на фундаментальные правила дизайна.

Главный акцент в новой версии сделан на существенном увеличении скорости генерации, что снижает задержки в рабочих процессах и позволяет быстрее экспериментировать с промптами или пакетной обработкой набросков. Параллельно разработчики повысили эстетическое качество и точность геометрии: генерируемые SVG содержат меньше лишних узлов и перекрывающихся путей, а композиционные параметры — выравнивание, отступы и пропорции — корректно соблюдаются по умолчанию.

Обновленная модель ориентирована на широкий спектр прикладных дизайнерских задач. Она умеет создавать стилистически согласованные вариации иллюстраций по референсу, строить акцентные пояснительные диаграммы и формировать детализированные технические чертежи. Кроме того, Arrow 2.0 качественно векторизует растровые изображения в редактируемые SVG и поддерживает микроанимацию, анимируя существующие векторные слои и группы для интерфейсных иконок, лоадеров и анимированных логотипов.

Вместе с базовой версией анонсирована продвинутая модель Arrow 2 Telos, которая объединяет скорость движка со способностями передовых frontier-моделей к тонкой доработке. Компания позиционирует стандартную Arrow 2.0 как оптимальный инструмент для быстрых и экономичных итераций, тогда как Telos предназначена для решения сложных креативных брифов, требующих глубокой детализации и нестандартной композиции. Arrow 2.0 уже открыта для всех пользователей в веб-приложении Quiver.
  • 👍 1
Post #1321 267
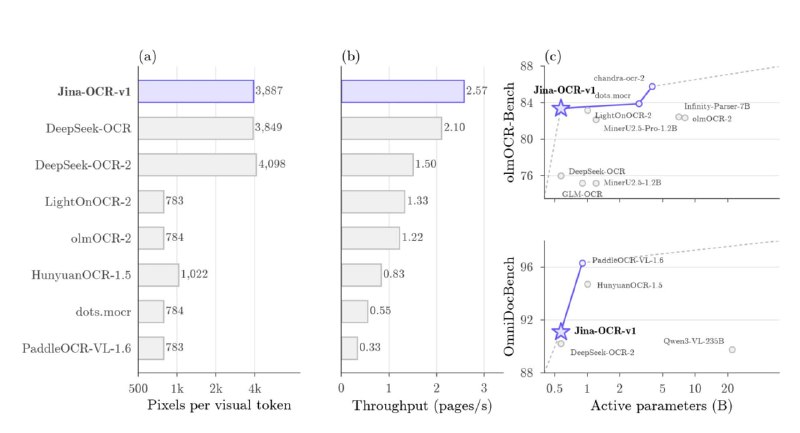
Компания Jina AI представила модель jina-ocr-v1, предназначенную для сквозного преобразования страниц документов и PDF-файлов в структурированный Markdown всего за один проход. Модель распознает текст, сложные таблицы, математические формулы и корректно восстанавливает порядок чтения, делая результат сразу пригодным для использования в пайплайнах больших языковых моделей без дополнительной постобработки.

Архитектура системы построена на базе DeepSeek-OCR с использованием концепции смеси экспертов, насчитывающей 3,4 миллиарда общих параметров, но активирующей лишь порядка 570 миллионов параметров на токен. За визуальную часть отвечает компактный энкодер DeepEncoder, сжимающий изображение страницы с минимальными вычислительными затратами, а поддержка динамического разрешения позволяет эффективно обрабатывать детализированные фрагменты. Для радикального снижения стоимости продакшен-инференса разработчики внедрили спекулятивное декодирование FastMTP, генерирующее до трех черновых токенов за шаг. За счет «жадной» проверки итоговый текст получается строго побайтово идентичным классическому авторегрессионному выводу, при этом скорость генерации на сравнительно доступных ускорителях вроде NVIDIA L4 возрастает практически вдвое.

Обучение и постобучение модели включало методы выравнивания инструкций, адаптацию к поврежденным и историческим архивам, а также обучение с подкреплением GRPO на базе плотных проверяемых наград за структуры таблиц и формул. Благодаря этому jina-ocr-v1 демонстрирует высокие результаты на бенчмарках OmniDocBench и olmOCR-Bench, сохраняя при этом рекордную скорость обработки документов в сравнении с конкурентами схожего качества: на одном чипе A100 производительность достигает более двух с половиной страниц в секунду.

Основным сценарием применения решения выступает массовая и экономичная оцифровка корпоративных документов, сканов и PDF-архивов, где решающим фактором является пропускная способность на единицу затрат. Модель поддерживает свыше сотни языков, транскрибирует колонтитулы для сохранения архивной полноты и распространяется под лицензией CC BY-NC 4.0, будучи доступной как через API Jina AI, так и на Hugging Face.
  • 👍 2
Post #1320 253
В Claude обычный чат, Cowork и Design объединяют в единую поверхность.
  • 👍 1
Post #1319 381
Тут Xiaomi в реальном времени обучают свои новые модели линейки Mimo: https://mimo.xiaomi.com/rl/
Post #1318 444
Новая мультимодальная стелс-модель union-alpha в течение недели доступна бесплатно через OpenRouter и OpenCode.
Older posts →

About this channel

How can I read @synaptic_garden without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Synaptic Garden: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Synaptic Garden have?
Synaptic Garden (@synaptic_garden) has 534 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Synaptic Garden know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →