
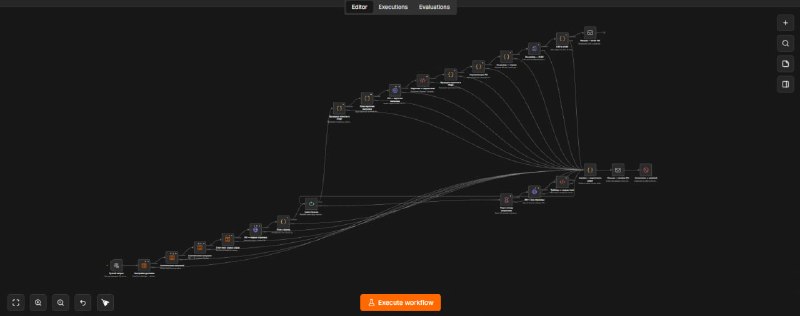
Есть в этом квартале у меня задача — восстановить сбор определенных данных с одного конкретного источника.
Считайте, достаточно простой ETL процесс: собрали сырые данные, отсекли фильтрами ненужное, нормализовали нужное, сформировали финальные данные для заливки в БД.
Все делается сугубо одним флоу. Никаких штатных обработчиков не предусмотрено, которые можно было бы интегрировать по одному запросу.
Ранее на этот источник был штатный скрипт, который сломался. Вот, задача проанализировать причины, причесать фильтры, поставить ТЗ на починку прогеру и потом тестить.
В рядовом потоке эта задача от старта до финала заняла бы минимум месяц, максимум два.
Нет, речь не о 2 месяцах чистой работы. Речь про itшную бюрократию. Спринты, задачи, оценки трудозатрат, тесты (пинг-понг между мной и разработчиком).
Что было сделано: скормил агенту кучу инфы по этому источнику и воркеру. Все прошлые ТЗ, рабочие файлы, сверху грузанул обширным промптом от себя, че хочу, че делаем, че поменялось.
Помимо этого зашил штатные анти-скрапинг вещи: проксирование запросов, делеи между запросами, а также резервный метод парсинга через Jina, а не через стандартный GET url.
И вот за 3 полноценных рабочих дня этот штатный воркер прошел полный рефактор, кучу тестов, доработок, анализ логики сбора, расширение покрытия.
Итог: получен полностью рабочий флоу-прототип версии 1.0, который не стыдно выкатить на prod. А также готова инфрастуктура с общими повторяющимися вещами для будущих автоматизаций подобного рода, так что будущие воркеры будут писаться сильно дешевле и быстрее.
Доволен ли я? Более чем. В рамках задачи квартальной я не только проанализировал и поставил ТЗ на it-отдел, а целиком сделал то, что должно было быть готово только концу октября.
А также получил бесценный опыт в n8n. Пусть сервис спорный, зато он интегрирован на корпоративные рельсы
Вот такая хуйня, собачка.