🔍Anthropic выкатили новую модель. Цифры выглядят слишком хорошо.
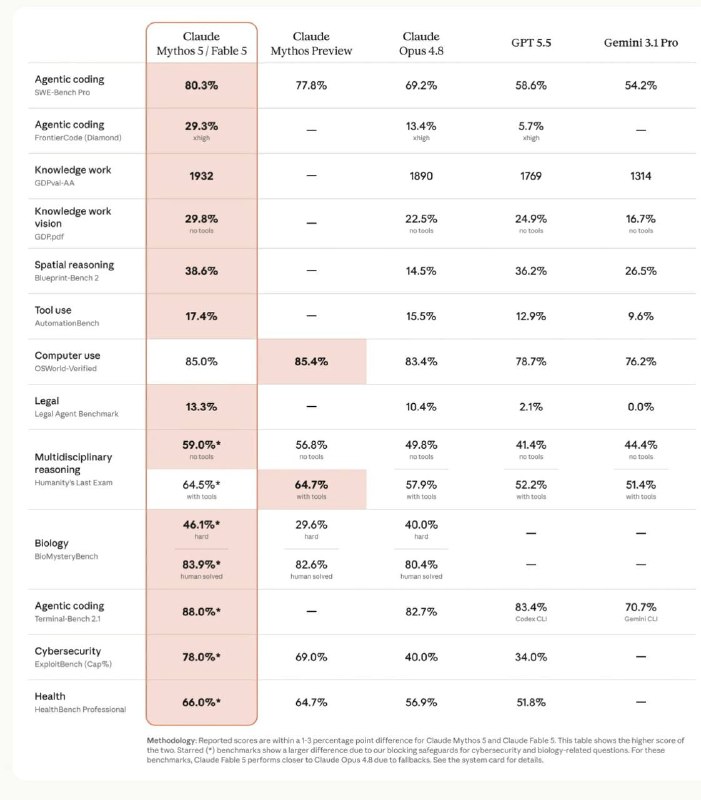
По заявленным бенчмаркам Claude Mythos 5 / Fable 5 обгоняет GPT 5.5 практически везде:
✈️Что важно:
• 80.3% против 58.6% в SWE-Bench Pro
• 29.3% против 5.7% в FrontierCode
• 78% против 34% в кибербезопасности
• 66% против 51.8% в медицинских задачах
• 59% против 41.4% в Humanity’s Last Exam
Если верить этим цифрам, то местами преимущество выглядит не на проценты, а в разы.
Тут возникает вполне логичный вопрос.
Неужели GPT 5.5 настолько отстал?
Или Anthropic себе бенчи в нанабанане нарисовали? 🙂
Впрочем, когда OpenAI, Anthropic, Google и остальные начинают бороться за первое место, выигрывает обычно не лидер рейтинга.
Выигрывают пользователи.
Ждём ответку от OpenAI. 🍿
↗ Ссылка на статью
⚡ via Industrial Ai
Post #287
72