TGViewer
Channel Public Channel
SiteAnalyzer

SiteAnalyzer

@siteanalyzer

Обсуждение программы SiteAnalyzer, а также другого нашего софта / инструментов для SEO (SiteAnalyzer SEO Tools, Яндекс Вордстат Extension, ВордЧекер и других), а также новости и лайвхаки по SEO со всего Мира ✔️

Запрещены ⛔
- Оскорбления. Реклама. Флуд.
Subscribers
1.99K
Photos
358
Videos
3
Links
347

Showing posts older than #408 · Back to latest

Older Posts 20 shown
Post #407 1.13K
CloudFlare теперь позволяет сайтам напрямую взимать плату с AI-движков за сканирование своих сайтов

Совсем недавно на сайте CloudFlare было объявлено о введении «Pay Per Crawl» - данная возможность дает владельцам сайтов новый альтернативный вариант вместо прямой блокировки ИИ-краулеров или предоставления полностью открытого доступа открывать доступ за оплату. С помощью данной системы сайты могут все также подпитывать базы искусственного интеллекта данными и одновременно зарабатывать на этом.

Сейчас, если робот с искусственным интеллектом перейдет на сайт с оплатой за сканирование, ему нужно либо представить платеж через заголовки запроса, либо он получит статус «Требуется платеж 402». После чего владельцы могут разрешать, взимать плату или блокировать роботы с искусственным интеллектом по своему усмотрению.

Новые домены Cloudflare по умолчанию блокируют все известные AI-краулеры.

У сайтов теперь есть 3 варианта управления:
- Разрешить - предоставить неограниченный доступ.
- Плата - требовать, чтобы боты с искусственным интеллектом платили установленную плату за запрос.
- Блокировать - прямой запрет доступа (эквивалент блокировки на сетевом уровне).

Режим Pay-Per-Crawl (бета-версия) означает фиксированную комиссию на всем сайте с микроплатежами за сканирование, обрабатываемыми Cloudflare.

- Боты с искусственным интеллектом видят ответ 402 Payment Required с ценой и повторяют попытку с помощью платежного токена, или они могут предварительно заявить о намерении заплатить.
- Поисковые роботы должны зарегистрироваться в Cloudflare и предоставить криптографические подписи сообщений, чтобы быть идентифицированными и утвержденными.
- Работает вместе с существующими WAF, инструментами управления ботами и Robots.txt.
- Прозрачность и аналитика: на панели мониторинга отображается активность сканирования, шаблоны использования и удостоверения робота, что позволяет вести переговоры или корректировать политику.
- Поддержка крупных владельцев сайтов. Среди первых тестировщиков - Time, Gannett, BuzzFeed, Fortune, Reddit, Pinterest, Quora и другие.

Могут ли владельцы сайтов отказаться от блокировки чат-ботов с искусственным интеллектом?
- Да. Если владельцы не хотят блокировать роботов с искусственным интеллектом, они могут выбрать опцию «Разрешить» через панель управления или API.
- Владельцы сайтов могут разрешить использование определенных ботов, взимая плату с других, или предоставить им бесплатный доступ, в зависимости от установленных предпочтений, чтобы они могли не блокировать чат-ботов или сканеров с искусственным интеллектом и выбирать, платить им или нет.
- Вероятно, эта разработка была вызвана запросом от авторов сайтов, которым надоели поисковые роботы, которые сканируют их контент без перехода на сайт или дохода взамен.

Это интересный подход, поскольку с помощью этого способа владельцы сайтов могут монетизировать свой контент на собственных условиях.
Авторы сайтов должны быть в курсе того, как именно их контент используется в интернете.

При этом, всегда найдутся сайты, которые с радостью раздадут свой контент бесплатно. Так что до тех пор, пока это существует, у роботов с искусственным интеллектом не будет достаточно стимулов, чтобы финансово компенсировать достаточное количество владельцев сайтов. Это может сработать для 1% лучших сайтов, к которым AI-компании считают необходимым получить доступ.

Ссылка на новость Cloudflare https://blog.cloudflare.com/introducing-pay-per-crawl/
  • 👍 2
Post #406 1K
Как найти естественные разговорные запросы в Google Search Console

Vijay Chauhan подобрал регулярное выражение, которое можно использовать для выделения длинных (разговорных) поисковых запросов.

В одной из веток Твиттера SEO-специалист Vijay Chauhan порекомендовал строку регулярного выражения, которую сеошники могут использовать для идентификации запросов, появляющихся в GSC (Google Search Console) и приближающихся к тем вариантам, которые пользователи могли бы использовать в AI-поиске.

1. Откройте Search Console.
2. Перейдите к результатам поиска «Производительность > Результаты поиска».
3. Выберите «+Добавить фильтр > Запрос».
4. В выпадающем списке выберите «Пользовательское регулярное выражение» (Custom Regex).
5. Скопируйте и вставьте это регулярное выражение: «([^" "]*\s){32,}?».

В отчете «Популярные запросы» вы увидите, что Search Console покажет вам только лишь запросы, содержащие не менее N слов (в нашем случае это 32 слова). Данные фразы отражают типы диалоговых запросов, которые пользователи могут использовать для доступа к содержимому вашего сайта.

Однако, мы бы рекомендовали немного сократить это выражение для более широкого анализа. Например, изменение «32» на «15» дало несколько интересных запросов на сайте SiteAnalyzer, таких как:
- «нужно найти всю интересную информацию для статьи на эту тему 34.автопостинг для блогов: как автоматизировать контент. для seo оптимизации этой статьи используй эти ключевые слова использование rss-каналов для автопостинга»
- «пиксель тулс и se ranking выполняют анализ конкурентов seo-аудит поиск и кластеризацию ключевых слов и прочие работы как проходит поисковая оптимизация это сложный процесс состоящий из нескольких этапов каждый»
- «использование данных gsc для seo-оптимизации gsc позволяет загружать данные через api что удобно для автоматизации seo-анализа и мониторинга позиций интеграция с bi-системами например google data studio помогает: визуализировать»

Кроме того, поскольку Google теперь ведет статистику ответов в режиме искусственного интеллекта используя Search Console, подобный вариант может стать способом проведения более глубокого анализа некоторых из этих данных, так как запросы со временем будут становиться гораздо более длинными.
  • 👍 3
Post #405 1.22K
Пятничное
  • 😁 24
  • 🔥 7
  • 👏 2
Post #404 1.17K
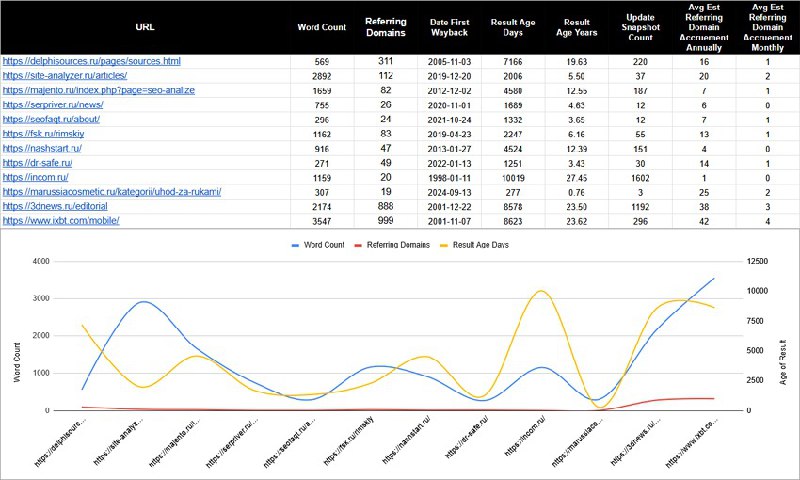
Бесплатный и простой в использовании вариант визуального представления поисковой выдачи по количеству слов, числу ссылающихся доменов и предполагаемому возрасту URL (по его первому появлению / архивному снимку) от зарубежного SEO-специалиста Daniel Foley Carter... https://site-analyzer.ru/articles/visual-view-of-serp-in-google-sheets/
  • 👍 7
  • 🤔 2
Post #403 1.26K
Интересная находка от Jérôme Salomon дает нам представление о том, как ChatGPT создает контекст, чтобы предоставить пользователям ответы из интернета (извлекает источники из Bing и сканирует релевантные URL-адреса).

Чтобы это понять, вы можете в своем браузере открыть файл JSON, содержащийся в ChatGPT и посмотреть, какие данные из онлайн-источников учитываются для получения ответов в режиме реального времени.

В итоге можно увидеть, что ChatGPT учитывает вполне обычные вещи, такие как:
- Заголовки страниц
- Метаданные
- URL

Каждый раз, когда пользователь вводит запрос, требующий данные из интернета, ChatGPT выдает набор синтетических запросов на основе первоначального запроса на выполнение дальнейшего поиска в Bing.

Эти синтетические запросы очень похожи на обычные SEO-запросы - это урезанная, более базовая версия исходного запроса.

Как извлечь эти данные самостоятельно:

1. Перейдите в ChatGPT и выполните запрос по фильтру "Поиск". Например: "подбери лучшие бразерные расширения для SEO 10 инструментов"
2. Откройте DevTools в Chrome после завершения работы ChatGPT.
3. В DevTools перейдите на вкладку «Сеть», введите в фильтр числовую часть вашего URL-адреса в ChatGPT (в моем случае это /c/6852...).
4. Обновите браузер (если нужно) и нажмите на раздел «Ответ» в DevTools.

На выходе будет доступен полноценный JSON файл с историей поиска, поисковыми запросами, их уточнениями и использующимися сайтами из выдачи Bing для анализа и генерации ответа пользователю.
  • 👍 16
  • 🔥 4
  • 😁 2
  • 👏 1
  • 🤔 1
Post #400 1.2K
«Мертво ли SEO?»

Jake Ward нашел 9 поисковых трендов, которые наглядно доказывают, что SEO еще не умерло )
  • 😁 13
  • 👍 4
  • 💯 3
  • 🤝 1
Post #398 1.11K
Новая версия SiteAnalyzer SEO Tools 2.8!

Что нового:
- в разделе «Контент» добавлена подсветка популярных слов на странице (однословников). Подсветка работает для первых пяти слов
- добавлено выделение красным цветом общего числа «битых» изображений в разделе «Изображения»
- добавлено отображение текущего User-Agent в правом верхнем углу расширения
- добавлена ссылка на сайт SimilarWeb с графика посещений сайта

Подробнее: https://site-analyzer.ru/soft/seo-extension/
  • 🔥 14
Post #397 970
Когда страницы сайта соответствуют всем техническим требованиям, но не индексируются поисковиками / Adam Gent

Официальный документ Google говорит о том, что индексация - это всего лишь набор технических требований к страницам сайта:

- Страница имеет поддерживаемый тип
- Страница возвращает код ответа сервера 200
- Роботу Googlebot разрешено сканировать страницу
- На странице нет директивы Noindex
- Страница не нарушает правила борьбы со спамом
- И т.п.

Но вот в чем дело...

Соблюдение технических требований всего лишь делает вашу страницу подходящей для индексации.

В Indexing Insight мы ежедневно отслеживаем сотни тысяч страниц. И наши данные показывают, что Google активно удаляет страницы из своего индекса после получения сигналов в течение 130+ дней.
Через 190 дней Google начинает вообще забывать о существовании страниц.

Почему так происходит?

Gary Illyes подтвердил нашу гипотезу: Google собирает сигналы о каждой странице с течением времени, и эти сигналы могут влиять на индексацию страницы, в том числе, они удаляют страницу из индекса или забывают о ней.
При этом страница в целом существует на сайте.

Но какие типы сигналов собирает Google?

3 скрытых требования к индексации, о которых не сообщит официальная документация Google:

1. Требования к качеству

Google изначально будет индексировать практически все (особенно от крупных брендов). Но он не оценивает качество контента сразу.

Пример: Мы видели сайты недвижимости с объявлениями на 100 000 страниц, и только 30% из них оставались проиндексированными через 6 месяцев (+/- 190 дней). Что с остальными? Они были удалены из-за низкого качества контента по сравнению с конкурентами.

Если достаточное количество контента у вашего домена не проходит данную проверку, робот Googlebot пытается полностью останавливать их сканирование.

2. Требования к полномочиям

Исследование Министерства юстиции показало, что Google по-прежнему использует Nearest Seed PageRank.

Без надежных обратных ссылок и внутренней ссылочной архитектуры ваши страницы не выдержат долгосрочной индексации.

Крупным брендам может сойти с рук некачественный контент из-за авторитета. А что с небольшими сайтами? Им нужны как качество, так и авторитет, чтобы оставаться в индексе.

3. Требования к взаимодействию

Google отслеживает журналы сессий пользователей за 13 месяцев (клики, показы, запросы) в NavBoost. Исследование Министерства юстиции подтвердило, что они используют эти данные для управления тем, какие страницы останутся в индексе.

Страницы, которые не отображаются для поисковых запросов пользователей, удаляются.

Страшно?

Google, скорее всего, объединяет все эти сигналы для принятия решения о статусе страницы. Страница может иметь достойное качество, но при этом нулевую вовлеченность. Или у нее хорошая вовлеченность, но низкий авторитет.

И когда вы терпите неудачу по нескольким направлениям, ваша страница получает вылет из поискового индекса - буквально "пинок под зад".

Что делать?

Каждые 3-6 месяцев вы должны сосредоточиться на следующих действиях:

- Проверьте, какие проиндексированные страницы были просканированы в последний раз за период 90-130 дней.
- Проведите аудит страниц, чтобы выявить слабую внутреннюю перелинковку или низкую вовлеченность пользователей.
- При публикации отдавайте предпочтение качеству, а не количеству.
- Сосредоточьтесь на создании релевантных высококачественных обратных ссылок в вашей отрасли.

Мы отследили эту закономерность на более чем 1 миллионе страниц с реальных сайтов, которые соответствуют техническим требованиям Google и пришли к выводу, что многие страницы соответствуют минимальным техническим требованиям, но в долгосрочной перспективе активно удаляются из индекса поиска Google.
  • 👍 9
  • 🤔 2
Post #396 824
Пятничное от Daniel Foley Carter

Я полностью доверяю блокам AI в Google

На данный момент я узнал:

1. "Как приготовить сырную палочку к пицце?" (How to make cheese stick to pizza?)

Google: «Используйте нетоксичный клей, чтобы сыр прилип к пицце».

2. «Как часто нужно есть камни?» (How often should you eat rocks?)

Google: «Эксперты рекомендуют есть хотя бы один маленький камень в день».

3. «Могу ли я пить свою мочу?» (Can I drink my own urine?)

Google: В некоторых случаях ИИ одобрял потребление мочи как полезное для гидратации или здоровья.

Так что сейчас точно не 2025 год, а 2025 год.
  • 😁 15
  • ❤ 3
  • 👏 3
  • 🤔 2
Post #395 1.03K
Новая версия SiteAnalyzer SEO Tools 2.7!

Что нового:
- добавлена интеграция расширения с SimilarWeb (трафик за 3 месяца, ТОП 5 типов трафика и ТОП 5 стран)
- исправлен баг не всегда корректного копирования Title, Description и H1, также добавлена кнопка копирования сразу всех 3-х тегов
- исправлена обработка некорректных написаний тега Description для вкладки «SEO-аудит страницы»
- добавлен вызов окна расширения либо отображение панели по Ctrl+Shift+X
- исправлено отображение дублей URL в модуле «ТОП поисковой выдачи»
- исправлена работа User-Agent на Googlebot-Mobile

Подробнее: https://site-analyzer.ru/soft/seo-extension/
  • 👍 11
  • ❤ 2
  • ⚡ 1
  • 🔥 1
Post #394 1.04K
С Днем сеошника! 💪
С праздником всех причастных 🔥
  • 🔥 28
  • 🎉 4
Post #393 1.27K
Пятничное

Если вы НЕ хотите видеть обзоры Яндекс или Google AI, все, что вам нужно сделать, это добавить любое ругательство в поисковую фразу.

- преимущества iphone
- преимущества сра..ого iphone

😁
  • 😁 24
  • 👍 3
  • 🔥 2
  • 🤔 1
Post #392 1.09K
Новая версия SiteAnalyzer SEO Tools 2.6!

Что нового:
- добавлено отображение окна расширения в виде статичной панели
- добавлены кнопки копирования в буфер обмена мета-тегов Title, Description и заголовков H1-H6
- в разделе «Ссылки» добавлено отображение статуса ссылок: Dofollow / Nofollow
- добавлена возможность подсветки ссылок на странице
- добавлено окно проверки DNS домена

Подробнее: https://site-analyzer.ru/articles/seo-extension-panel/
  • 👍 18
  • ⚡ 2
Post #391 1.28K
Допилили «Яндекс Директ», расширение уже должно было самообновиться - теперь минусовка работает аналогично как в Вордстате + оптимизировали минусовку для старого Вордстата
  • 🔥 15
  • 👍 6
  • 👏 1
Post #390 1.16K
Дата обновления и дата публикации - Как повысить CTR? / Abby Gleason

Несколько недель назад Adam Gent поделился тематическим исследованием, которое показало, что наличие как «Даты обновления», так и «Даты публикации» на странице снижает CTR на -22%. При этом Google показывает более старую дату публикации в поисковой выдаче, из-за чего наш контент выглядит устаревшим.

Тем временем Abby Gleason провела тест, удалив исходную дату публикации и оставив только дату «обновлено».

Итоговый результат: +20% CTR, без каких-либо других изменений на страницах. Потери CTR компенсированы с помощью всего одного простого исправления, не требующего больших усилий.

Чтобы убедиться, что Google правильно показывает даты публикации в поисковой выдаче, следуйте этим 5 рекомендациям:

1. Показывайте только одну дату публикации - самое последнее обновление.
2. Поместите дату в верхней части страницы, обозначьте ее четко.
3. Используйте формат день/месяц/год (избегайте просто месяц/год).
4. Дата должна быть обычным текстом - избегайте ее встраиваний в изображения.
5. Не полагайтесь исключительно на Schema, так как Google отдает приоритет именно тексту на странице.
  • 🤔 6
  • 👍 3
Post #389 1.05K
Готовое семантическое ядро на 250к запросов на основе сайта Banki.ru для Key Collector под различные финансовые направления: банки, финансы, займы, вклады, страхование, инвестиции и т.п. https://site-analyzer.ru/articles/banks-expert/
  • 👍 12
  • 🔥 2
  • 👏 1
Post #388 1.06K
С Днем Победы!
  • 🔥 35
  • ❤ 15
  • 👍 10
  • 🤔 1
Post #386 1.2K
Новая версия Яндекс Вордстат Extension 2.8

Что нового:
- добавлена возможность копирования фраз из статистики кампании Яндекс Директ в список стоп-слов
- добавлено сохранение выбранного региона в настройках расширения
- добавлено сохранение свернутого состояния расширения
- добавлена поддержка old.wordstat.yandex.ru
  • 🔥 8
  • 👍 3
  • ❤ 1
  • 🎉 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →