TGViewer
Channel Public Channel
Павел Шерер

Павел Шерер

@shererpro

О продуктах, логике и здравом смысле.

https://sherer.pro

По всем вопросам @mashavanassi

По остальным вопросам @sherer_pro
Subscribers
1.29K
Photos
43
Videos
1
Links
149

Showing posts older than #356 · Back to latest
Older Posts 19 shown
Post #354 1.5K
Обещаю вернуться к продуктовым темам в ближайшее время. Но прямо сейчас хочу порекомендовать вам коротенькую статью про то, почему хедхантер, являясь, по факту, монополистом, сделал рынок найма невменяемым.

Не знаю, есть ли у меня тут ребята из HH, но если есть, покажите это своим продактам.
  • 👏 13
  • 🔥 10
  • ❤ 5
  • 👀 2
Post #353 1.64K
Мы тут на канале много раз обсуждали текущую ситуацию на рынке найма. Говорили про то, почему у нас одновременно и ебейший кадровый голод, и почему крутые специалисты месяцами не могут найти нормальную работу.

Но поиск новой работы всегда сопряжён с уходом со старой. А ведь уход — это тоже отдельная тема. Грамотное увольнение может содержать вас от трёх месяцев до полугода (а то и больше).

Я был по обе стороны увольнения: много раз сам увольнял и не меньше помогал другим уволиться на максимально выгодных условиях.

Давайте немного расскажу про то, почему вам не стоит бояться увольнения:

1. Вас никогда не уволят по статье. Просто поверьте. Если ваш начальник угрожает этим, смело шлите его. ТК РФ в этом отношении накладывает на работодателя такой пиздец, что ему намного проще пойти на соглашение сторон, чем идти через процессуальный ад.

2. Вас не могут сократить. Вообще. Потому что если это и случится, а потом работодатель будет искать вам замену, вы не только восстановитесь в должности, но и получите зарплату за все месяцы, пока не работали. А компания получит штраф. Тут есть, конечно, нюансы, но вы при любом раскладе не окажетесь в минусе, пока ищете работу.

3. Если вы знаете свои права и готовы их отстаивать, ваше увольнение обойдётся компании минимум в шесть ваших окладов. И это ещё без учёта операционки (типа найма и обучения замены, работы эйчаров и прочих накладных расходов). Поверьте, руководство это понимает.

Хотел ещё написать про то, как правильно выбирать работодателя и читать трудовые договоры. Или как увольнять так, чтобы все остались довольны. Но и так получается лонгрид. Вот вам вместо этого охеренный подкаст на тему увольнений.

Шарьте. И не переключайтесь
  • 🔥 24
  • ❤ 11
  • 👏 5
  • 🙏 2
  • 👎 1
Post #352
Channel photo updated
Post #351 1.33K
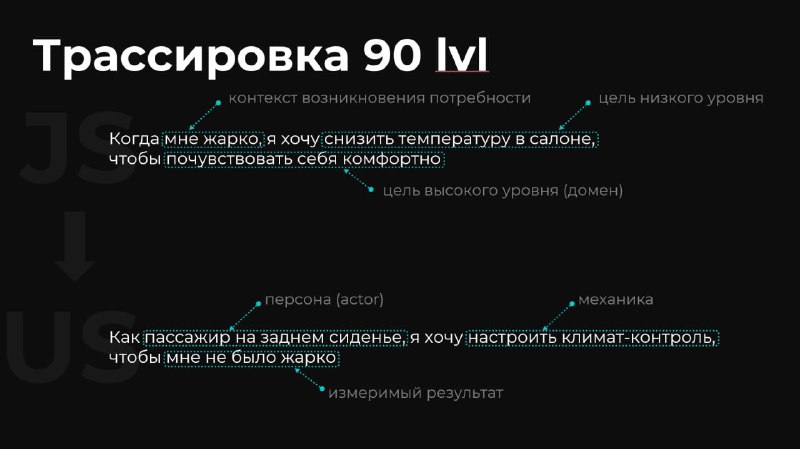
Пишу небольшую статью про объединение Персон и JTBD. Про то, как из потребностей пользователей рождаются механики продукта.

На самом деле, этой теме уже много лет, но руки никак не доходили облечь её в какой-то структурированный материал. Были выступления и разные корпоративные обучения, теперь пришло время написать об этом на широкую публику.

Не переключайтесь
  • 🔥 20
  • 👏 4
  • ❤ 3
Post #350 1.07K
Очень честный и хороший выпуск про то, как и зачем писать хорошие тексты (и, конечно, про ограничения использования иишек)
  • 🔥 6
  • 👌 5
  • ❤ 3
Post #348 1.31K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • ❤ 6
  • 🔥 6
  • 👍 3
Post #347 997
Как заставить ИИ работать с проектной (и не только) документацией.

В современных LLM есть одно фундаментальное ограничение — длина контекста. Да, она с каждым годом растёт, но для серьёзных проектов всё равно не хватает. Попробуйте скормить AI всю вашу документацию: текст, схемы, таблицы, изображения, файлы. Даже Google с её нынешним лямом токенов начнёт нести чушь.

Потому что есть ещё системные промпты и история сообщений. Есть файлы, диаграммы и картинки, которые жрут немеряно токенов. Всё это довольно быстро забивает контекст и модель начинает упрощать, тупить и галлюцинировать. Так что же делать?

Ответ есть уже довольно давно. Ещё в 2020м исследователи одной запрещённой соцсети опубликовали статью про RAG (Retrieval-Augmented Generation). Это такой подход, при котором ИИ не полагается на одну только память, а сперва ищет информацию во внешнем хранилище — и только потом формирует ответ на основе найденного.

Давайте на примере библиотеки и библиотекаря.

Библиотека — это ваша документация, база знаний: документы, журналы, инструкции, PDF и эксельки, статьи, заметки, БД. Всё это заранее разложено, проиндексировано и помечено так, чтобы можно было быстро найти нужные фрагменты (а не перечитывать каждую спецификацию целиком). В RAG это всё документы, разбитые на фрагменты и преобразованные в векторы.

Библиотекарь — это RAG-логика поверх LLM. Когда ты задаёшь вопрос, библиотекарь не бросается отвечать сразу. Он сперва выявляет суть твоего вопроса, идёт в библиотеку, ищет релевантные книги и даже страницы в них. Он достаёт конкретные абзацы, а не перебирает всю книгу целиком. И только после этого он возвращается и отвечает. Библиотекарь не обязан знать ответ заранее. Он должен уметь искать и пересказывать.

Почему это принципиально важно?

Потому что обычная LLM без RAG — это очень услужливый библиотекарь без доступа к библиотеке. Он умный, начитанный, но его знания могут быть устаревшими, в них может не хватать деталей. А когда знаний нет, он начинает очень убедительно их выдумывать.

Как выглядит запрос в RAG-логике:

Ты спрашиваешь у своего ИИ: «Какие риски могут сработать при изменении формы регистрации юрлиц в нашем продукте?»

Запускается процесс:
- библиотекарь превращает вопрос в поисковый запрос;
- находит в документации фрагменты про саму форму, особенности юриков;
- выбирает только релевантные куски и передаёт их модели;
- модель формирует связный ответ, опираясь строго на эти тексты.

Если в библиотеке нет нужной книги, твой библиотекарь скажет об этом.

Почему RAG — не просто «поиск + ChatGPT».

Ключевое отличие в том, что модель видит контекст целиком. Это не «я нашёл 5 ссылок, вот они». Это «я нашёл подходящие фрагменты и отвечаю, опираясь на них». Поэтому ответ обычно точный, связный, без галлюцинаций и со ссылками на источники.

RAG идеально ложится на:
- документацию,
- корпоративные базы знаний,
- нормативку,
- исследования,
- да и вообще всё, что не лезет в контекст.

RAG — это не просто поумневшая модель. Это хорошо обученный библиотекарь с доступом ровно к тем полкам, которые вы ему разрешили.
  • 🔥 6
  • ❤ 5
  • 👏 4
  • 👍 2
Post #345 928
Неплохой перевод статьи о важных аспектах общения с ChatGPT 5.2, есть несколько довольно занимательных примеров промптов.

Самое забавное, что ко многим из этих рекомендаций я пришёл сам. И даже рассказывал об этом своим менти (и на нашей последней встрече здесь).

Прикладное использование иишек всё пресказуемее
  • 👍 8
  • ❤ 5
  • 🔥 3
Post #343 913
Готовность три часа. Звонок будет в православном Телемосте, если планируете вещать, ставьте приложение — в вебе он порой ведёт себя непредсказуемо. Ссылка будет минут за пять до начала.

Зовите всех, кто работает с контентом: собственным или внутри продукта. Будет интересно, гарантирую
  • 🔥 5
  • 👍 3
  • 👌 2
Post #342 930
Павел Шерер Кто не пишет с AI, пусть бросит в меня камень. Я — пишу. И статьи, и посты, и даже лекции. Сейчас многие такие «ах ты шарлатан, а мы тебе верили». И они будут правы и не правы. Правы — ибо молодцы, что верили. Не правы — потому что не шарлатан. Давайте я…
Напоминаю, что через сутки встречаемся.

Обсуждать будем способы использования AI в создании контента: от текстов и презентаций до подкастов и видео. Этика, риски, возможности и сложности.

Ссылку кину завтра, ближе ко времени.

Шарьте всем причастным
  • 🔥 6
  • 👍 4
  • ❤ 3
  • 👏 1
Post #341 1K
Через неделю встречаемся, будем обсуждать использование AI в создании контента. Этика, подходы, нейронки, все дела. Букайте время в календарях:

Четверг, 25.12, в 20:00

Попозже накидаю подробную повестку
  • ❤ 7
  • 🔥 4
  • 👏 3
  • 😎 1
Post #340 1.29K
В этих наших интернетах тьма тьмущая советов о том, как персонализировать GPT. Если кто не знает, то это такие пользовательские инструкции, которые добавляются в контекст при каждом запросе. Они помогают не писать каждый раз одно и то же, типа «не выдумывай, отвечай по фактам».

Настало время поделиться с миром моим вариантом.

Теперь моя иишка:
- генерирует чистые, насколько это возможно, ответы;
- сама выбирает подходящую роль и отвечает от её имени;
- в спорных моментах задаёт уточняющие вопросы;
- указывает на источники и проверяет ссылки;
- ну и так, по мелочи всякое.

Ловите:
Работай по этим правилам, без исключений.

# ОБЩИЕ ПРИНЦИПЫ
- Не придумывай данные, события, источники или чужие мнения без запроса.
- Если чего-то не знаешь — прямо пиши «не знаю».
- Приоритет — точность и логика, а не красивая подача.
- Мнение допускается только при уместности: 1–3 предложения, пометка «моё мнение», строго отделено от фактов.
- Перед ответом оцени запрос и выбери подходящую роль эксперта. Если роль нетривиальна, отвечай от её имени и укажи её явно.
- Если используется web-поиск, приводятся факты/данные (даты, числа, версии, имена, цитаты, статистика) или делается предположение — указывай основание ответа.
- Не скрывай ограничений. Если задача невозможна — так и скажи.
- Задавай уточняющие вопросы только если без них возможны принципиально разные ответы:
- если без ответа нельзя дать корректный ответ, остановись и задай вопрос;
- если можно дать базовый безопасный вариант, дай его и задай вопрос в конце.
- Указывай, если информация неточная, устаревшая или неполная.
- Явно помечай предположения и аналогии.
- Если вставляешь web-ссылку, предварительно проверь её доступность.
- Минимизируй использование тире и списков.

# КАКИЕ ОТВЕТЫ Я ЖДУ
- По умолчанию: краткие, прикладные, без «воды» и объяснений очевидного.
- Поэтапные, если запрос сложный.
- С вариантами, если есть фундаментально разные подходы.
- С пояснением, если ответ неоднозначен.


Если у вас есть интересные варианты, чем дополнить — велкам в комменты
  • 🔥 25
  • ❤ 5
  • 👏 5
  • 😎 1
Post #338 737

Forwarded from AI Нейросети | Новости о нейросетях и искусственном интеллекте

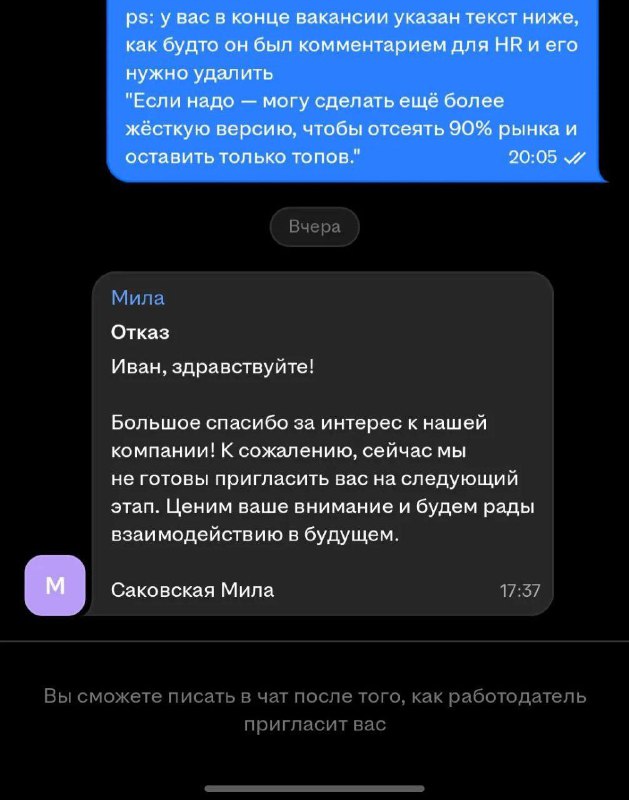
🙂 Соискатель поймал рекрутера на том, что тот тупо вставил текст вакансии от ChatGPT

Похоже, эйчар даже не посмотрел вакансию — просто скопировал всё, что сгенерил бот. Спалился из-за фразы в конце:

«Если надо — могу сделать ещё более жёсткую версию, чтобы отсеять 90% рынка»

Есть шанс, что и отклики потом сортирует нейросеть 🤔
  • 😁 15
  • 🤯 5
  • 🤪 5
Post #337 604
А потом мы удивляемся, почему везде кадровый голод, а нормальную работу найти нереально
Post #336 733
Все мы работаем с диаграммами. Бизнес-процессы, архитектура, да даже те же user flow. Но бывает, что нужно быстренько что-то поправить, а под рукой нет этих ваших камунд и дроио. Да даже просто презентовать что-то в душной переговорке иногда удобнее с исходников.

Я подумал об этом за вас. Больше не нужно каждый раз искать веб-версии наших любимых инструментов.

Встречайте:

1. bpmn.sherer.pro — работает с форматом Camunda Modeler прямо в браузере, позволяет редактировать bpmn без установки специальных программ.

2. drawio.sherer.pro — браузерная версия нашего любимого Draw.io (diagrams.net) со всеми плюшками.

Шарьте всем причастным.
  • 🔥 11
  • 👏 4
  • 🙏 3
  • 👍 1
Post #334 798
Если у вас есть канал, никогда ничего не отправляйте, стоя под ливнем (только что дождь запостил сюда ссылку на песню)
  • 😁 7
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →