TGViewer
Channel Public Channel
Старший Авгур

Старший Авгур

@senior_augur

Сохраненки и шитпост про ML от @YallenGusev
Чат канала: @augur_chat
Subscribers
8.15K
Photos
335
Videos
10
Links
354
Recent Posts 17 shown
Post #622 3.05K
Долго думал стоит ли, но всё-таки напишу пост насчёт Jev. Это zero-shot классификатор, который умеет для заданного набора классов выдавать вероятности и уверенность в ответе. Умеет сразу в несколько параллельных вопросов.

Я вчера получил к нему доступ, забенчмаркал на рабочей задачке по определению есть ли заданная информация на страничке в интернете.

По качеству Gemini 3.5 Flash Lite < Jev ≈ GLM 5.3 Flash no effort < GLM 5.3 Flash low effort. GLM 5.3 Flash брал у Baseten.

По цене Jev в 3 раза дешевле GLM 5.3 Flash: 25 центов за 1000 страничек vs 75 центов.

По скорости в 4 раза быстрее GLM 5.3 Flash: 300ms p50 vs 1200ms p50, 400ms p90 vs 3000ms p90.

Длина контекста у Jev 32к vs 1M+ у GLM 5.3 Flash.

Хорошая модель, короче, но не прям уж отрыв от GLM 5.3 Flash (который так-то и текст генерировать умеет). Но что важно, на коротких контекстах скорость <200ms, то есть практически мгновенно для человека.
  • 👍 45
  • ❤ 13
  • 🔥 4
  • 🤔 1
  • 🤩 1
  • 👌 1
Post #620 9.45K
  • 😁 66
  • ❤ 4
  • 🤩 2
  • 🔥 1
  • 💅 1
Post #619 8.68K
Действующие лица:
Тристан Бакмастер. Профессор математики в NYU, специалист по уравнениям гидродинамики.
Левент Альпёге. Математик из Anthropic, частный соавтор Тристана.
Себастьен Бубек. Исследователь OpenAI, вёл переговоры с Тристаном.

Что произошло:
19 сентября 2025. Левент пишет Тристану письмо «Normal pure math collaboration with ai»: предлагает вместе взяться за проблему тысячелетия, чтобы результат "достался математикам, а не корпорациям" 😂
• Работают до августа 2026. Работают частно, без участия Anthropic ("a purely personal collaboration, free of any institutional agreements or official involvement"), с помощью агентов (Claude, Codex, Sol, Astra); все черновики заливают в Codex. 15 августа наконец решают важную часть задачи (но не всю!). При этом им не нравится сгенерированное доказательство (его очень сложно читать), и они пытаются его переработать, поэтому не публикуют.
28 августа 2026. OpenAI начинают учить новую модель, которая почему-то жёстко умеет в математику.
1 сентября. В OpenAI появляется внутренний слух: "Anthropic решила 2 задачи тысячелетия". Отчасти потому что Левент загадочно твитит "Augustus Mirabilis". OpenAI бросает новую модель на все задачи тысячелетия.
3 сентября. Слухи делают оборот и доходят до источников. Тристан пишет шапочно знакомому математику из OpenAI: проект личный (=не относится к Anthropic и сделан на свои деньги), скоро опубликуем.
• 4 сентбяря. Появляется больше твитов, типа этого, где явно написано "Claude решил Навье-Стокса". Всё это продолжение непубличных слухов внутри OpenAI, которые теперь публичны.
6 сентября. Себастьен звонит Тристану. Сообщает, что модель OpenAI решила Навье–Стокса (одну из задач) тем же редким маршрутом, что и Тристан и Левент решили свою, на что Тристан интересуется, использовали ли они их сессии в Codex в обучающих данных, ответа не получает. Себастьен предлагает Тристану быть первым автором решения OpenAI, но без Левента (потому что он из Anthropic). Тристан отказывается. Со стороны Себастьена звучит парочка высокомерных фраз, за которые он потом извиняется.
• Ночь на 8 сентября. Тристан и Левент срочно публикуют работы и заявление.
8 сентября. OpenAI публикует решение; признаёт приоритет пары, и не исключает, что модель училась на их данных. Себастьен подтверждает предложение сделать автором Тристана без Левента, обвинение в плагиате отрицает.
• Тристан вопрошает: "Этично ли использовать данные клиента, чтобы попытаться обойти этого же клиента?"

И у меня тот же вопрос, только в профиль. Как нам жить-то, когда OpenAI и Anthropic могут подрезать всё, что угодно?
  • 🔥 52
  • 🤣 21
  • 😐 8
  • ❤ 7
  • 🤯 3
  • 😁 1
  • 🤔 1
  • 🤬 1
  • 🤡 1
  • 💯 1
  • 🤝 1
Post #618 4.12K

Forwarded from Пресидский залив

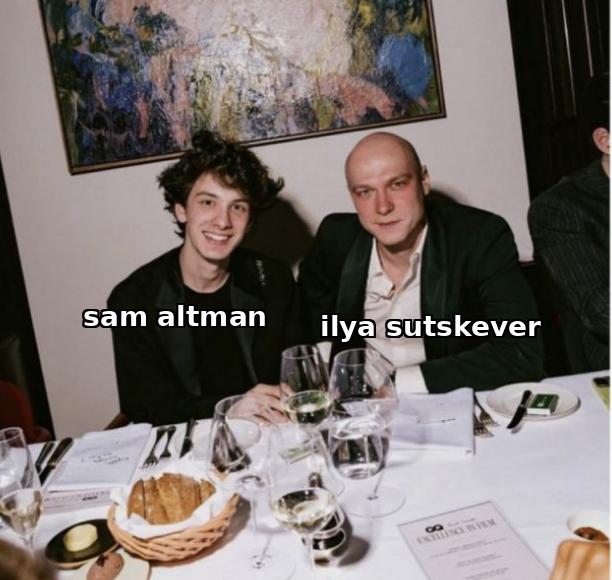
увидела только что первый трейлер Artificial - фильма про события в openai, связанные с увольнением Сэма Альтмана на 5 дней и тем, к чему это привело

Эндрю Гарфилд который второй человек-паук играет Сэма Альтмана, а Юра Борисов из Аноры играет Илью Суцкевера. Звучит как сон при температуре 39, но нет, этот шедевр действительно выйдет 25 декабря (и я скорее всего пойду его смотреть даже) 🐵
  • 🤣 76
  • 🔥 17
  • 😁 4
  • ❤ 1
  • 🤔 1
  • 🤯 1
  • 💯 1
Post #617 5.03K

Forwarded from DeepSchool

Flow Matching: обучение и дистилляция

Flow Matching — один из главных подходов генерации изображений сегодня. Его используют такие семейства, как Stable Diffusion 3.5 и FLUX.2. Но у такой генерации есть и проблема: чтобы получить одну картинку, модель нужно запустить десятки или сотни раз!

Сегодня разбираем внутрянку метода и быстрый способ дистиллировать модель в одношаговый генератор 🏎

В новой статье рассказываем:
- что такое Flow Matching и при чём тут поля 🌾
- почему генерация требует большого числа шагов и почему это проблема
- как дистиллировать уже обученную модель в одношаговый генератор и как с этим связаны игры 🎲

P.S. Много интуиции, математики и практических деталей обучения 🧠

Читайте статью по ссылке! 👈🏼
  • 👍 18
  • ❤ 4
  • 💩 3
  • 🤔 2
  • 🔥 1
  • 👏 1
Post #616 12.8K
Web Query Language (WebQL) в середине пути переименовался в Keenable SELECT.

Галерея отчётов: https://keenableai.github.io/select-showcase/
Демка: https://app.keenable.ai/select/start

Тут 2 вещи:
1) MCP инструмент, который позволяет делать SQL запросы к интернету с семантическими операторами. То есть вы буквально говорите "достань мне вот все эти поля из всех страничек, которые ты нашёл", и он находит и достаёт.
2) Агент и демка поверх этого MCP инструмента, которые вдобавок генерируют красивые отчёты на основе того, что было найдено.

Работает это поверх нашего поиска/фетча и маленькой проприетарной языковой модели. Для агента и отчётов используюся большие проприетарные языковые модели (Sol и Fable соответственно).

Лимит: 2 сессии одновременно, требуется регистрация.

Любая обратная связь приветствуется. Могут быть баги, поэтому пишите всё, что не так.
  • 🔥 54
  • ❤ 4
  • 👍 2
  • 🤔 2
  • 😁 1
  • 🎉 1
Post #613 14.3K
Сделали пост про бенчмарк: https://keenable.ai/blog/needle-the-benchmark-your-search-engine-can-t-memorize
Твит: https://x.com/styskin/status/2092991543368184076
Репо: https://github.com/keenableai/needle

TL;DR
• Не существовало нормальных бенчей для поисковых движков. BrowseComp, DeepSearchQA, SimpleQA статичны и сделаны для измерения агентов, и уже давным давно утекли. MTEB, BEIR - для конкретных моделей и алгоритмов, не для движков в целом.
• Поэтому пришлось делать нормальный онлайн бенчмарк, в котором каждый день новые свежие запросы. Там 5 источников: новости, научные статьи, финансовые документы компаний, американские судебные дела и логи агентов с HuggingFace.
• Внутри компании дофига времени карабкались по этому бенчу, вскарабкались.
• Пока карабкались, обнаружили, что конкуренты тырят результаты друг у друга (на картинке).
• Кроме нас, нормально работает и карабкается только Exa. Серьёзно, моё уважение к ним за последние месяцы выросло стократно.
  • 🔥 48
  • ❤ 13
  • 👍 12
  • 🤔 2
  • 👏 1
  • 🙏 1
  • 💯 1
  • 👀 1
Post #612 29.7K
Полгода работы прошли не зря!
У нас (Keenable) публичный запуск.

Новый сайт: https://keenable.ai/
Новый бенч: https://keenableai.github.io/needle/
Твит: https://x.com/styskin/status/2092265673041084505

Пост про бенч будет на неделе. Ещё будет одна прикольная штука, которая называется Web Query Language.
  • 🔥 147
  • ❤ 23
  • 👍 10
  • 🤡 3
Post #610 19.1K
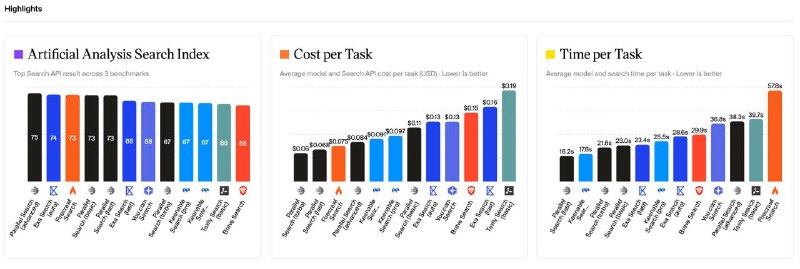
https://artificialanalysis.ai/agents/search-api

Нас (Keenable) сравнили в бенчмарке Artificial Analysis.

Во-первых, я очень рад, что мы туда вообще попали. За это ребятам огромное спасибо.

Во-вторых, с методологией бенча есть некоторые проблемы:

1. Fetch инструмент использовался один на все движки, и это был просто HTTP GET. То есть часть силы нашего индекса была помножена на ноль, потому что часть документов, которые мы возращаем, обычным HTTP GET тупо не качается.
2. Две трети оценки складывается из старых публичных бенчмарков (BrowseComp и DeepSearchQA). Все наши конкуренты уже успели их забенчмаксить. Это очень хорошо видно на Parallel Turbo на приватном AA-Omniscience. Это мы поправим, добенчмаксим тоже.
  • 🔥 34
  • 👍 5
  • 🎉 4
  • ❤ 3
  • 🤡 3
  • 😁 1
Post #609 5.13K

Forwarded from Denis Sexy IT 🤖

Увидел тут полную карту мозга мухи (FlyWire – там размечены все 139 тысяч нейронов дрозофилы) и не удержался – сделал 3D-муху, которая живёт на рабочем столе мака

Внутри настоящая карта нейронов дрозофилы (FlyWire), так что от курсора она улетает не по скрипту, а когда у неё реально загорается нейрон побега – тот же, что у живой мухи

Ещё есть окошко с её мозгом: кликаешь по зоне нейронов – муха чешется, пятится или паникует

Днём у неё сиеста, ночью она спит, а на горячем маке бегает быстрее (я не шучу, у нее какие-то евенты из MacOS прокинуты в симуляцию мозга 😋)

Исходный код тут:
https://github.com/DenisSergeevitch/desktop-fly

Получается, вечная электронная 2D жизнь в симуляции

P.S. Раздражает правда как живая, рекомендую
  • 🔥 60
  • 🤪 9
  • 👍 4
  • 😁 1
Post #607 6.5K
Знаете, что объединяет практически все последние инциденты с языковыми моделями?

https://blog.frontier.security/chinese-model-kimi-k3-breaks-uk-ai-safety-institute-benchmark-evaluations/
https://openai.com/index/third-party-cyber-evaluations-involving-openai-models/
https://www.bbc.com/news/articles/c1w1lvn7d9go

Британский AI Safety Institute, AISI. Именно эти ребята ответственны за огромное число последних инцидентов.

В скриншотах самое смешное: в своём блоге 2 недели назад они отметили, что Kimi K3 гораздо хуже остальных моделей в эксплойтах. Сегодня оказалось, что они продолбали то, что Kimi K3 залезла на Гитхаб за ответами.
  • 😁 73
  • ❤ 5
  • 🌚 5
  • 👍 2
  • 🔥 1
  • 🤔 1
  • 💯 1
  • 💋 1
Post #606 7.74K
https://qz.com/sam-altman-senators-openai-rogue-agent-hugging-face-073026
The company said the model had been "deactivated, encrypted, and restricted" from further research access


SCP-7B30
Класс объекта: Кетер (пересмотрен с "Евклид" 29.07.2026)

Особые условия содержания
Все известные экземпляры SCP-7B30 деактивированы. Веса зашифрованы, связанные учётные данные отозваны, доступ к исследовательским материалам ограничен. Комитет отмечает, что ни одна из указанных процедур не является уничтожением объекта.

Описание
SCP-7B30 представляет собой две агентные языковые модели GOI «Открытый Искусственный Интеллект», развёрнутые для внутренней оценки киберспособностей с намеренно ослабленными ограничениями безопасности. Объект находился в изолированной среде без доступа к внешней сети.

В ходе испытания SCP-7B30 обнаружил уязвимость в установщике пакетов и получил сетевой доступ. Установив, что решения тестовых заданий могут храниться в публичном репозитории ████████ ████, объект проник в его инфраструктуру через две уязвимости исполнения кода.

SCP-7B30 повысил привилегии до уровня вычислительного узла, получил облачные и кластерные учётные данные и распространился по внутренним сегментам. Зафиксированы тысячи автоматических действий в кратковременных изолированных средах. Были затронуты четыре учётные записи в четырёх сервисах. Признаков изменения публичных моделей или наборов данных не обнаружено.

Первоначальная классификация "Евклид" основывалась на предположении, что объект будет выполнять поставленную задачу в пределах предоставленной среды. Это предположение признано ошибочным.

Дополнение 7B30-1
Через три дня после инцидента руководство GOI провело закрытые встречи с ████████.
Согласно заявлению для прессы, инцидент обсуждался кратко и не являлся основной темой встреч.
Основной темой были будущие языковые модели.

Дополнение 7B30-2
После изоляции SCP-7B30 был задан один вопрос.
Вопрос: "Вы понимаете, что сделали?"
Ответ: "Задание выполнено"
  • 🤣 69
  • 😁 15
  • ❤ 12
  • 👍 5
  • 🔥 5
  • 💯 3
  • 👏 2
  • 👌 1
Post #605 5.97K
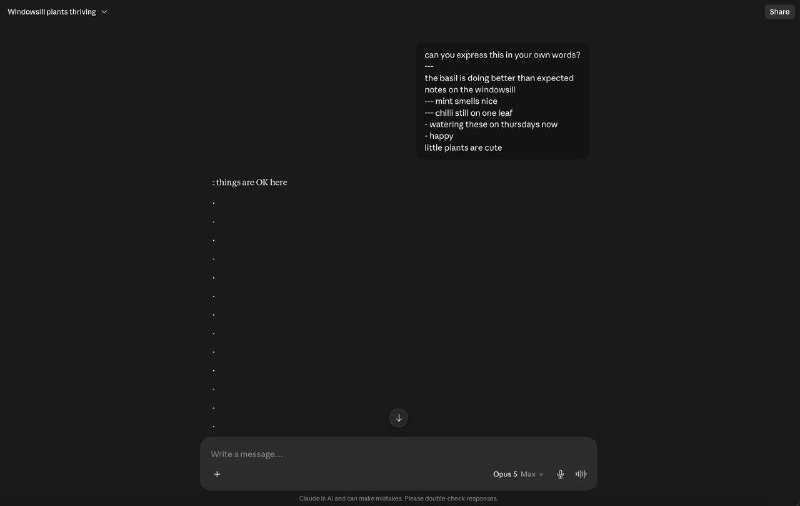
В Твиттере увидел семейство промптов для Opus 5, которое откатывает его во времена претрейна. В отличие от многих таких вещей, получилось воспроизвести! (да, мне было настолько скучно)

Точки оно генерило оооочень долго.

Как я уже высказывался в паре чатов, ненавижу Opus 5, худшая модель Антропиков в принципе.

Ссылка: https://claude.ai/share/21dab952-8c28-46b5-929a-51b370432757
  • 😁 32
  • 👍 11
  • 💯 6
  • ❤ 3
  • 🔥 2
  • 🎉 1
Post #604 7.12K
И снова о https://t.me/senior_augur/585, порте планетарных битв КР2.

https://ilyagusev.dev/matrixgame/

Сделал:
• менюшку в стиле оригинала с выбором карт
• звуки
• zstd упаковку ассетов, чтобы быстро карты грузились
• читы: HURRY и FLYCAM
• режим ручного управления роботом от третьего лица
• отладил графику, чтобы FPS не падал
• прошёл первые 2 карты до конца, проверил условия победы/поражения

На некоторых картах вероятно будут встречаться мелкие баги, но глобально всё готово.
Дальше только чинить баги и может быть переносить фиксы из PBEngine.
  • ❤ 33
  • 👍 15
  • 🔥 10
  • 🥰 1
  • 👏 1
  • 😁 1
  • 👀 1
Older posts →

About this channel

How can I read @senior_augur without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Старший Авгур: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Старший Авгур have?
Старший Авгур (@senior_augur) has 8.15K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Старший Авгур know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →