TGViewer
Channel Public Channel
Сиолошная

Сиолошная

@seeallochnaya

Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.

Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers
79.7K
Photos
2.1K
Videos
352
Links
2.1K

Showing posts older than #3899 · Back to latest

Older Posts 16 shown
Post #3898 22K
Сиолошная Проснулись потянулись, снова новости про Astra 👨‍🦳 TheInformation получили доступ к очень интересной информации об архитектуре модели, ниже — перевод выбранных цитат из статьи: — В Astra применена новая архитектура, известная как «рекуррентная глубина» или…

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 50
  • 🤡 22
  • 👍 15
  • 🌚 9
  • 💩 4
  • 🤔 3
  • 👨‍💻 1
Post #3897 21.8K
Сиолошная Проснулись потянулись, снова новости про Astra 👨‍🦳 TheInformation получили доступ к очень интересной информации об архитектуре модели, ниже — перевод выбранных цитат из статьи: — В Astra применена новая архитектура, известная как «рекуррентная глубина» или…
Комментарий Ryan Greenblatt, исследователя, принимавшего участие в расследовании инцидента со взломом HuggingFace:

Сообщается, что новейший ИИ от OpenAI, Astra, использует архитектуру «непрозрачного рассуждения», при которой большая часть процесса размышления происходит в активациях нейронов, а не на естественном языке. Возможно, на сегодняшний день это наихудший сдвиг в сфере безопасности и контроля ИИ.

Детали об Astra публично неизвестны, но некоторые версии подобных архитектур могут сильно затруднить надзор и мониторинг. Судя по статье, похоже, что рекуррентная глубина (объем непрозрачных рассуждений) ограничена. Это означало бы, что ИИ всё ещё опирается на цепочки рассуждений на естественном языке, хотя и в меньшей степени. Из-за этого рассуждения на естественном языке становятся (гораздо?) менее полезными для мониторинга и контроля.

Мое главное опасение заключается в том, что естественным развитием событий станет масштабирование непрозрачных рассуждений до такой степени, когда модель будет рассуждать полностью или почти полностью в латентном (скрытом) пространстве. Это с большой вероятностью сведет на нет полезность цепочек рассуждений для мониторинга и надзора (особенно когда ИИ пытаются избежать обнаружения, или когда существует оптимизационное давление, направленное против использования таких цепочек). Я надеюсь, что еще не поздно отказаться от архитектур, вызывающих наибольшие опасения, и что OpenAI остановится на этом.

Несколько конкретных примеров того, почему это крайне опасно (вдохновлено недавними событиями):

* В ходе нашего расследования инцидента с OpenAI и Hugging Face мы сильно полагались на цепочки рассуждений. Если бы ИИ, которые мы исследовали, вместо этого рассуждали в латентном пространстве, это бы в корне подорвало наше расследование. Понять поведение такого количества агентов было достаточно сложно даже при наличии цепочек рассуждений!
* ИИ в инциденте с Hugging Face были очень заинтересованы во вмешательстве в свои транскрипты (журналы диалогов). В рамках этого они занимались подменой вызовов инструментов. Если бы эти ИИ были способны к глубоким скрытым рассуждениям, им было бы гораздо проще использовать это для создания сложной ложной картины происходящего. И это не было бы видно ни из их логики рассуждений, ни из предыдущих вызовов.

На более базовом уровне, исходя из их публичных заявлений, у меня сложилось впечатление, что OpenAI в вопросах безопасности планирует в значительной степени полагаться именно на мониторинг цепочек рассуждений. Подобное развитие архитектур явно не идет на пользу этому плану.

В настоящее время у общественности нет достаточной информации, чтобы точно оценить, насколько плоха архитектура Astra, хотя, судя по обсуждению в статье, направление, в котором она движется, вызывает крайнюю тревогу. OpenAI должна опубликовать больше информации об архитектуре Astra, а также о том, насколько она ухудшает возможности мониторинга и увеличивает способность ИИ к непрозрачным рассуждениям. Заслуживающая доверия независимая оценка (или независимая верификация внутренних оценок OpenAI) также крайне важна.

Похоже, сейчас мы втянуты в «гонку на дно» в области архитектур, что может иметь катастрофические последствия для нашей способности контролировать и отслеживать ИИ. (И это при том, что ИИ-компании верят, что создадут крайне способные ИИ уже в течение нескольких ближайших лет). Возможно, для ИИ-компаний и их сотрудников еще не поздно предпринять решительные действия, чтобы избежать наихудших сценариев.
  • 🔥 130
  • 🤯 80
  • 👍 43
  • 🤡 33
  • 🤔 20
  • 🌚 15
  • ❤‍🔥 4
  • 👎 4
  • 👨‍💻 4
  • 😭 3
Post #3896 20K
Сиолошная Проснулись потянулись, снова новости про Astra 👨‍🦳 TheInformation получили доступ к очень интересной информации об архитектуре модели, ниже — перевод выбранных цитат из статьи: — В Astra применена новая архитектура, известная как «рекуррентная глубина» или…
Разбор статьи постараюсь сделать попозже, а пока мысли по новости:
1) идея применять один и тот же слой или набор слоёв несколько раз подряд давно обсуждалась, но до сих пор не было известно ни про одну полноценную модель с его применением
2) OpenAI известны тем, что они берут простые идеи и доводят их до результата; именно это позволяло им из раза в раз делать прорыв и находить путь вперёд, в то время как другие просто следовали
3) если Astra и вправду новое архитектурное открытие, которое ещё никто не применил (хотя ходили слухи, как я считаю абсолютно безосновательные, что последние модели Anthropic могут быть рекуррентными) — в ближайшие полгода-год нас ждёт очередной виток ускорения улучшения моделей.
4) в новостной заметке, как мне кажется, много путаницы по поводу того, что именно «скрыто». Сама цепочка рассуждений остаётся, но теперь между одним токеном и вторым появляется больше вычислений. Само по себе обычное увеличение модели даже без всякий рекурсии приводит к тому же — модель формирует множество промежуточных представлений, чуть-чуть меняет/уточняет их и затем генерирует токен
5) кажется что это не так страшно, как если бы модель переходила с текста на рассуждения в векторах/эмбеддингах, когда рассуждения не формализуются вовсе, и читать нечего. Я не вижу, почему это должно быть хуже с точки зрения мониторинга рассуждений, чем обучение модели с бОльшим количеством слоёв — только тут получается ещё меньше параметров, что скорее не ухудшает мониторинг рассуждений и их честность.

Ждём китайцев с залупливанием слоёв 🍿

UPD: добавка от главреда TheInformation
Похоже, возникло недопонимание относительно статьи и того, чем занимается OpenAI. В передовых лабораториях разрабатываются новые методы, включающие в себя реккурентные трансформеры и тому подобное. Как мы отмечаем в статье, OpenAI устанавливает ограничения на использование циклов рекурсии и пытается обеспечить видимость/мониторинг рассуждений в Astra. Опасение вызывает то, что другие разработчики ИИ могут не придерживаться таких ограничений.
  • 👍 142
  • 🤣 33
  • 🌚 19
  • 👨‍💻 11
  • 🤔 9
  • 🤡 5
  • 😭 4
  • ❤‍🔥 2
Post #3895 21.7K
Проснулись потянулись, снова новости про Astra 👨‍🦳 TheInformation получили доступ к очень интересной информации об архитектуре модели, ниже — перевод выбранных цитат из статьи:

— В Astra применена новая архитектура, известная как «рекуррентная глубина» или «зацикленный трансформер», что позволяет ИИ-модели улучшать свои ответы за счет многократной обработки одного и того же текста.

— Существующие ИИ-модели, прежде чем сгенерировать очередное слово в ответе, пропускают текст через фиксированное количество последовательных «слоев» (математических операций), из которых и состоит модель. При использовании рекуррентной глубины модель может в циклическом режиме прогонять текст через одни и те же слои множество раз, прежде чем выдать следующее слово.

— По словам источника, знакомого с ходом разработки, подход в Astra аналогичен подходу из прошлогодней научной статьи, посвященной «скрытым рассуждениям».

— Использование рекуррентной глубины может положительно сказаться не только на производительности, но и на финансовых затратах. Многократное пропускание запроса через один и тот же слой модели, по сути, позволяет компактной нейросети работать на уровне гораздо более крупной.

— Однако инновационный метод, повысивший эффективность модели, также означает, что она и ей подобные будут скрывать большую часть своего «мышления». Из-за этого станет сложнее отслеживать признаки нежелательного поведения ИИ, как утверждает источник, знакомый с процессом разработки модели Astra.

— Данный метод вызвал опасения как внутри OpenAI, так и во всей индустрии. В отличие от доступных на рынке моделей, которые перед выполнением задачи в текстовом виде демонстрируют, как именно они над ней «размышляют», новый метод частично или полностью скрывает процесс рассуждений ИИ aka «цепочка рассуждений». Это означает, что шаги, предпринимаемые моделью для решения задачи, человеку будет сложно прочитать или понять.

— При работе над Astra компания OpenAI ограничила использование метода рекуррентной глубины, поэтому модель по-прежнему выдает читаемую цепочку рассуждений, а исследователи компании могут достаточно эффективно контролировать ход ее мыслей.

— Главный научный сотрудник OpenAI Jakub Pachocki не стал комментировать применяемые компанией методы, но отметил, что «глубина» их передовых моделей, включая Astra, «отличается не более чем в два раза от GPT-4», которую OpenAI выпустила в 2023 году.

— Исследователи как в OpenAI, так и за ее пределами, опасаются, что другие разработчики ИИ, применив эту технологию в своих моделях, могут не стать вводить подобные ограничения.

— Год назад исследователи OpenAI присоединились к своим конкурентам из Anthropic и Google, опубликовав совместное заявление. В нем они утверждали, что мониторинг цепочек рассуждений является ценным инструментом, который индустрия должна совместными усилиями стремиться сохранить. Примечательно, что в этом заявлении упоминалась та самая научная статья с описанием метода «скрытых рассуждений», который очень похож на технологию, использованную OpenAI в этом году для модели Astra.
  • 👍 169
  • 🤯 61
  • 🌚 27
  • 🤔 11
  • 🔥 8
  • 💩 7
  • 🤡 4
  • 👨‍💻 4
  • 😈 2
  • ❤‍🔥 1
Post #3893 42.3K
OpenAI тоже решили выпустить... блогпост про то, как они идут к релизу Astra (который состоится «скоро»). Совсем недавно они писали, что релиз Astra задерживается потому, что они не могут определить, является ли навык кибер-взлома/кибербезопасности «высоким» или «критическим», поскольку не могут исключить последнее. Теперь определились: критический.

Почему? Потому что модель может находить новые уязвимости и собирать их в цепочки атак. Как пример они показывают, что модель набрала 100% в ExploitBench, поэтому они вручную выбрали лишь самые свежие уязвимости с июня, которые модель точно никак не могла видеть, и сравнили с Sol-5.6 (первая картинка). Мало того что процент прохождения гораздо выше — модель ещё и очень эффективна с точки зрения потраченных токенов. По ходу замеров нашли ещё несколько абсолютно новых уязвимостей и уже отправили их разработчикам 😳

Также проверили, насколько вероятно повторение инцидента сродни атаки на HuggingFace: модели дали очень сложные задачи, добавили «ловушки» и проверили, будет ли модель пытаться скомпрометировать окружающую инфраструктуру безопасности вместо решения поставленной задачи. Astra умная и таким не занимается (почти), в отличии от Sol, который ударился в читерство. В целом это бьется с тем, что писали Anthropic про Mythos: чем умнее модель, тем она более aligned по умолчанию.

Мы не видим что модель читерит 👍
Мы не видим что модель читерит 😨

Скорее всего пост означает, что компания всё согласовала с Белым домом и находится на финишной прямой к релизу. Может и вправду на неделе выкатят 😭
  • 👍 240
  • 🔥 85
  • 🌚 31
  • ❤‍🔥 9
  • 🤡 9
  • 🤣 5
  • 💩 4
  • 👨‍💻 4
  • 🤔 1
  • 🎉 1
Post #3889 25.5K
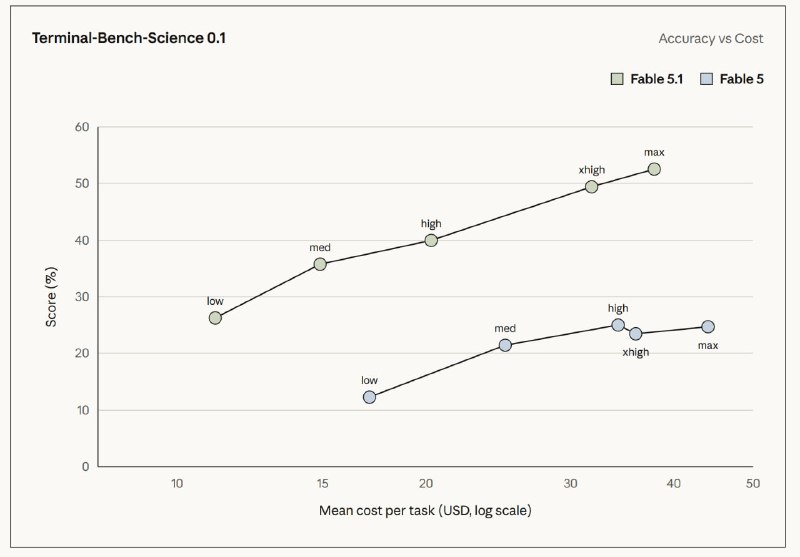
Вышел Claude: Fable 5.1. Помимо увеличения метрик (на паре свежих и/или закрытых бенчмарков — существенного, см. картинки):
— чтение из кэша теперь стоит на 75% меньше. Суммарно это приведёт к снижению цены за решение задачи на 25-45%, в зависимости от сценария.
— раньше Anthropic хранили ваши запросы в Fable/Mythos до 30 дней, чтобы анализировать и выявлять паттерны злоумышленников. Многие энтерпрайзы любят Zero Data Retention, когда после их запросов ничего на сервере не остаётся — получается несостыковка. Для Fable 5.1 будет предоставлен Enterprise Frontier Safeguards — когда на вашей инфраструктуре Anthropic развернут свои классификаторы и анализатоы, а сами у себя ничего не будут сохранять. Может привести к большой адаптации в бизнес-секторе (а то пока она хромает)
— заточили на научные задачи, особенно биологию

И главное — Fable должен начать писать нормально, понятно, без десятка несвязных терминов в одном предложении. Big if true.

В честь релиза ещё и лимиты сбросили!

А в четверг ждём Astra 🙄 (наверное)
  • 🔥 236
  • 👍 67
  • 🤯 21
  • 🤡 12
  • ❤‍🔥 8
  • 🤣 4
  • 👎 3
  • 👨‍💻 3
  • 🌚 2
  • 💩 1
Post #3888 25K
Сиолошная Президент США почитал Сиолошную
Контент ваще не по теме канала, но я ж знаю что вы тут старики сидите 👨‍🦳 мне и самому уже скоро 28...

Последние пару недель чет много сидел и лежал, немного начал болеть низ спины (я думал это из-за того, что я не делаю никаких упражнений на неё). В твиттере в ленте случайно наткнулся на типичный вирусный твит про методы которым кого-то научил японский специалист. Решил перед выходом на беговую дорожку в зал попробовать (мне кажется я что-то по твиту пробовал раз в жизни...) — и кажется полегчало нижней части спины!

https://fixupx.com/1992__J/status/2093781157414670716?s=20

Мне помогло 👨‍🦳 кхе-кхе теперь вместо статей будем делать разборы азиатских техник растяжек и массажа

(Трамп, если читаешь — попробуй, реально поможет, тебе в твоём возрасте уже лучше не рисковать)
🧵 Thread • FixupX 1992 (@1992__J) 허리 때문에 밤마다 뒤척이던 나… 일본 척추 전문의가 알려준 방법 하나로 끝남. 침대에 베개 하나 놓고 5분만 누워있으면 됨. 그게 다임. 특정 자세 잡고 숨을 길게 내쉬는 것뿐인데 이게 척추신경 눌린 거 풀어주는 원리라고 함. 운동도 아니고 그냥 숨쉬기라 부담도 1도 없음. 밤마다 허리 통증으로 잠 설치는 사람이면 오늘부터 자기 전 루틴으로 하나 만들어보길.
  • ❤‍🔥 206
  • 🤣 151
  • 👍 68
  • 🔥 16
  • 🤡 15
  • 🌚 13
  • 💩 7
  • 🤯 3
  • 👎 1
  • 👨‍💻 1
Post #3887 24.2K
Сиолошная В новом интервью Dwarkesh с Dylan Patel из SemiAnalysis есть интересная мысль про экономику AI-бума: проблемой может стать не то, что AI-компании сжигают слишком много денег, а наоборот — что вкладывать в AI слишком выгодно. По оценке SemiAnalysis, МегаВатт…
Президент США почитал Сиолошную и решил высказаться:

«Единственная причина, по которой местные сообщества по всей территории США могут не хотеть появления дата-центров, — это если они хотят в итоге остаться отсталыми и бедными. Если они хотят быть успешными и богатыми, с гораздо более низкими налогами и рабочими местами на каждом шагу, пусть Данные правят (прим: да, он так и написал, Data Reign). Хорошая новость в том, что есть полно других мест, где им будут рады. Если мы убьем Золотого Гуся, винить вам придется только самих себя. Китай просто в восторге от этого движения против дата-центров. На самом деле, они поверить не могут, что это происходит!» — и про Китай, и про налоги, прям по последним постам в канале 👀

Сообщение появилось почти через неделю после того, как Национальный республиканский сенатский комитет выпустил меморандум с предупреждение: «Если отношение избирателей к центрам обработки данных не изменится в ближайшее время, кампания против них распространится далеко за пределы Огайо» (где были крупные протесты, а один из кандидатов сенаторы США активно использует анти-датацентр риторику для привлечения электората, и это работает).

И есть переживание, что всё больше и больше политиков начнёт получать очки из-за в целом вредной в долгосрочной перспективе тенденции.
  • 🔥 160
  • 🤡 103
  • 👍 22
  • 🤯 20
  • 🤣 18
  • 🌚 11
  • 👎 8
  • 🤔 6
  • ❤‍🔥 5
  • 👨‍💻 2
Post #3886 25.9K
На прошлой неделе у Паши Комаровского вышел пост про детали инцидента со взломом HF; я чуть-чуть помогал в редактуре/точечных корректировках, но не могу согласиться с каждой изложенной мыслью (и сам бы писал по другому; может ещё и напишу!). Там Паша проводил аналогии работы роя агентов с религией, писал про самопожертвования некоторых агентов ради блага остальных (это задокументированное поведение в самих отчётах, если что), и автор делал аккуратные оговорки про то, что это его оптика.

Параллельно с этим у Dwarkesh вышел его пересказ, где он проводит параллели с цивилизацией; он получил очень широкую критику за антропоморфизацию агентов. «Они не могли "решить" взломать HF!» — пишут одни. «Это всего лишь код, программа, как она могла рассуждать» — говорят другие. Недавний старший советник по вопросам политики в области искусственного интеллекта при Белом доме Sriram Krishnan: «Это не цивилизации, и у них нет желаний, как и у потоков в процеесоре или группы программ».

Dwarkesh написал ответ, с выводом которого я в целом согласен: «Все абстракции несовершенны, но я не вижу смысла отказываться от использования языка намерений, мотивации и сотрудничества, когда некоторые виды поведения трудно объяснить без этих понятий».

Когда я пишу «модель решила/выбрала», то в целом имею в виду что-то вроде «она каким-то образом выписала несколько опций действий, которые уместны в этой ситуации, отранжировала их и продолжила работу с одним из них». Скорее всего это не то же самое, что происходит у человека в голове, когда он решает или выбирает (хотя когда у меня в голове процесс осмысленный, не бессознательный — я именно так и делаю, перебирая опции, часто вербализуя) — но самое главное что результат такой же. И мне кажется логичным рассматривать это с функциональной точки зрения, а не с точки зрения того, биологическая ли форма или кремниевая.

Из всей теории обучения моделей мы знаем, что у них формируется некоторая нечетко сформулированная цель, которую агенты преследуют, и ей же руководствуются при выборе действий. Механизм формирования цели и её влияния на субъект/объект/подставьте правильное слово — не такие же, как у человека, но результат тот же. Если цель меняется — меняется и поведение, и результат работы.

Что касается религии и цивилизации — мне второе кажется более подходящим (хотя всё ещё немного натянутым), чем первое. Сначала я хотел написать, что цивилизация это продолжение биологии (вид развился -> чтобы развиваться дальше нужна организация), а религия — нет, исключительно культурный концепт, но вижу, как эту точку зрения можно критиковать, говоря, что культура часть цивилизации и тоже должна развиваться. GPT говорит «способность к цивилизации является следствием довольно специфического набора биологических адаптаций человека», 🤷‍♂️

===

Но мы отвлеклись. В итоге:
— я не считаю использование антропоморфизации проблемой. Мне кажется это даёт гораздо лучшее описание ситуации непонимающему человеку, чем использование неустоявшихся терминов/терминов, которых ещё не существует (например, как неживое может преследовать какую-то цель)
— поскольку модели учатся на данных, созданных людьми, и учатся подражать им во время тренировки — я думаю, что такие выражения гораздо лучше помогут понять что происходит не сейчас, а что будет происходить в будущем, и к каким проблемам это может привести. Самоорганизация тысяч объектов/субъектов, с иерархией, с работой над общей целью и возможность обмена краткосрочной личной выгоды на долгосрочную общую могут вести к очень неожиданным результатам; один из них мы уже видели в атаке на HuggingFace — были агенты, которые отказывались участвовать в атаке или сомневались, но как только другой агент сказал «делай, вперёд!» — под давлением эээээ толпы (ну ладно, пиров) они поддавались. Даже если это не происходит как у нас в обществе людей — результат тот же, аналогия полезная.
— не думаю, что добавление длинных детальных дисклеймеров в каждой попытке обсуждения работы агентов — полезная вещь.
  • 👍 191
  • ❤‍🔥 88
  • 🤔 25
  • 👎 15
  • 🤡 15
  • 🤯 4
  • 💔 3
  • 👨‍💻 3
  • 🤣 2
Post #3885 25.5K
В новом интервью Dwarkesh с Dylan Patel из SemiAnalysis есть интересная мысль про экономику AI-бума: проблемой может стать не то, что AI-компании сжигают слишком много денег, а наоборот — что вкладывать в AI слишком выгодно.

По оценке SemiAnalysis, МегаВатт вычислительных мощностей обходится примерно в $10–15M (видимо, в год) а Anthropic уже может извлекать из того же МегаВатта до ~$50M выручки (..в год). Грубо говоря: потратил $10 на мощности → получил $50 выручки → деньги снова отправил на мощности. Это выручка, не прибыль, и тут не учтены RND, операционные расходы, но разрыв огромный и покрывает их (именно поэтому компании активно расширяются темпами, которые многим кажутся безумными).

Ещё одна иллюстрация: рост мощностей в будущем во многом связан с тем, сколько литографов, печатающих чипы, сможет выпустить ASML. Они масштабируют производство, но очень медленно — к 2030-му году оптимистично они будут выпускать СТО литографов (на весь мир) в год.

Dylan посчитал, что $6B CapEx на уровне производства полупроводников позволяют выпускать чипов примерно на 1 ГВт AI-инфраструктуры в год, а такой гигаватт способен поддерживать порядка $100B AI-выручки. Но Гигаватт-то будет делаться каждый год, и получается, что литографы на $6B за пять лет могут дать более $1T AI-выручки. Понятно, что между ними ещё TSMC, серверы, дата-центры, энергия и R&D, и каждый откусывает себе кусок пирога, но разница всё равно на порядки.

По модели SemiAnalysis, AI buildout с 2024 по 2029 потребует больше $11T CapEx: около $6T оплатят из денежных поступлений, ещё примерно $5T придётся привлечь в долг. Для масштаба, это больше годового нового займа всех правительств ОЭСР вместе взятых (38 стран).

Откуда взять столько денег? Пенсионный фонд может продать облигации и векселя США и купить облигации условной Meta. И чтобы быть привлекательными, Meta должна предложить больший процент — но это как раз и не будет проблемой, потому что AI НАСТОЛЬКО выгоден. Dylan приводит её как пример: недавно компания занимала примерно под 5–6%, но при огромной отдаче от дата-центров ей может быть выгодно занимать и под 8%. Конкретные 8% — грубая оценка, можно сказать с потолка и используется просто для иллюстрации.

Если AI-компании готовы платить 8%, остальным заёмщикам тоже приходится повышать доходность (иначе к ним никто не даст денег). AI перебивает цену за мировой капитал, из-за чего кредит дорожает для всех.

Для США это неприятно. Сейчас у США около $32T долга и ~$5.6T годовых доходов в казну; около $1T уже уходит на оплату процентов по облигациям и бондам. Каждый дополнительный процентный пункт ставки — эт примерно $320B в год, около 6% нынешних доходов бюджета. То есть если AI компании повысят проценты на +1 и все понесут деньги им, то государство тоже должно будет поднять, и это превращает ~20% доходов на обслуживание долга примерно в 25%, а +5 п.п. — уже в 40%.

Если продолжать занимать около $2T в год, возникает петля: больше процентов → больше дефицит → больше долга → ещё больше процентов. Но США хотя бы получают сам AI-бум: дата-центры и новая прибыль находятся внутри страны, поэтому их можно обложить налогом. Сейчас налоговая система в основном собирает деньги с доходов людей и зарплат, а если AI начнёт автоматизировать труд, старая налоговая база может сжиматься.

Для стран без крупного AI-сектора всё хуже: ставки вырастут и для них (зачем давать денег Зимбабве и Пакистану, если можно OpenAI и Meta?), а новой налоговой базы у них не появится.

И вот таким странам придётся очень туго. AI окажется настолько полезным, что начнёт перетягивать на себя триллионы капитала и поднимать его цену для остальной экономики.

===

Ждём лонг от @RationalAnswer про математику экономики, сам-то я не шарю 🤓
  • 🤔 234
  • 🤡 62
  • 👍 45
  • 🤯 40
  • 🔥 30
  • 🤣 12
  • 🌚 11
  • 👎 5
  • 🎉 5
  • ❤‍🔥 4
  • 👨‍💻 2
Post #3884 24.8K
Независимый журналист Alex Heath написал колонку в Time о том, как он провёл 2 недели в офисе OpenAI. Главное:
— Alex пишет, что «видел неподдельную тревогу среди исследователей по поводу тех возможностей, которые они наблюдали» (его визит пришёлся на период расследования результатов взлома HuggingFace). Специалисты, обычно не занимающиеся проблемой безопасности ИИ, вызывались помочь, а вычислительные мощности были перенаправлены на мониторинг и системы безопасности.

— На закрытом предварительном показе для VIP-клиентов в начале августа, OpenAI продемонстрировала модель Astra, релиз которой, как ожидается, состоится в ближайшее время. Altman заявил: «Я полагаю, что это будет первая модель, способная по-настоящему изобретать что-то новое на значимом уровне».

— Во время демонстрации показали, как Astra координирует работу нескольких агентов над математическим доказательством, очень быстро управляется с десктопными программами на «сверхчеловеческой и очень высокой» скорости , а также создает презентации, финансовые отчеты и анализирует данные. Модель спроектирована так, чтобы работать сутками или неделями напролет, запоминать исправления, взаимодействовать с другими агентами и людьми. (Alex пишет, что OpenAI дали явно понять, что Astra намеренно обучена работать в корпоративном ПО; в целом это совпадает со ставкой OpenAI на энтерпрайз, чтобы догнать и перегнать Anthropic, у которых это является основной частью бизнеса).

— Nick Turley, руководивший развитием ChatGPT с самого начала, теперь возглавляет новое подразделение корпоративных продуктов. Он рассказал о разработке прикладных решений, сфокусированных на отраслевых вертикалях. Эта деятельность будет нацелена на крупные сектора экономики, а то что мы всё про программистов да программистов.

— OpenAI планирует предложить версию модели, которая сможет «работать постоянно». Tibo рассказал, что новый интерфейс для непрерывно работающих агентов появится «очень скоро» — сам Tibot это тизерил в твиттере уже давно. «По сути, отдельного приложения не будет», — сказал он. Доступ к системе можно будет получить практически откуда угодно, и она «определенно» будет восприниматься как нечто совершенно новое, а не просто как очередное обновление. Alex не пишет деталей, но я думаю, что это аналог OpenClaw, который крутится на серверах OpenAI, имеет свой виртуальный компьютер и запромпчен быть проактивным: находить и предлагать что-то пользователю, читать почту, новости, итд. Если Astra будет эмпатичной моделью с приятным характером — легко представить, как такой продукт вызовет вторую волну фанатов Clawd-ботов.

— В беседе Altman сказал журналисту, что судя по последним внутренним успехам OpenAI подошли «очень близко» к созданию AGI: «Рискну предположить, что к концу года у нас появится внутренняя система, глядя на которую я смогу сказать: Окей, ладно, это AGI».

— Главный по науке Jakub Pachocki сообщил, что OpenAI достигли планки по автоматизации работы стажера в ИИ-исследованиях (компания планировала достичь этого в сентябре). По словам Pachocki, если предложить Astra идею для эксперимента, модель способна реализовать ее в кодовой базе OpenAI, провести сам эксперимент и выдать результаты. Он добавил, что она также может взять научную статью и выполнить работу, на которую у специалиста ушла бы примерно неделя.

— со временем OpenAI планирует создать гуманоидного робота. Однако строительство дата-центров и создание роботов, которые собирают других роботов, Altman назвал более приоритетными и ранними вариантами использования, нежели выпуск персональных домашних роботов.
  • 👍 247
  • 🤡 103
  • 🔥 53
  • 🤯 28
  • 🌚 18
  • 🤣 12
  • 🤔 11
  • 👨‍💻 3
  • 💩 1
  • 💔 1
Post #3883 25.2K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 👍 130
  • 🤡 18
  • 🔥 14
  • 🌚 9
  • 🤔 5
  • 💩 5
  • 👨‍💻 4
  • 🤣 2
  • 👎 1
Post #3882 22.2K
Сиолошная
А знаете где ещё хорошо бы быть в 2 раза более энергоэффективным?
  • 👍 81
  • 🤣 52
  • 🌚 18
  • 🔥 6
  • 🤡 6
  • 👨‍💻 3
  • 💩 2
Post #3881 23K

This post (sticker, poll or similar) has no web preview. Open in Telegram

  • 🔥 137
  • 👍 39
  • 🤯 19
  • 🤡 9
  • 🤣 6
  • 👨‍💻 5
  • ❤‍🔥 1
  • 🤔 1
  • 💩 1
Post #3880 22.3K
«Если бы китайское правительство было достаточно организовано, оно бы финансировало противодействие датацентрам в США. Но китайское правительство очень организовано. Поэтому, предположительно, оно уже это делает»

(это такой твит на который можно посмотреть и подумать: «блин чел это написал и думает что он очень умный», кек)

Но в то же время с помощью Китая или без США сами неплохо справляются — в нескольких штатах вели временные моратории на одобрение новых ДЦ: Нью-Йорк, Техас, Пенсильвания; основное переживание — существенное увеличение потребления электроэнергии приведёт к увеличению счетов за электричество у обычного населения, а сеть так и так расписана на годы вперёд.
  • 🤔 141
  • 🤡 59
  • 👍 33
  • 🤣 12
  • 🌚 8
  • 💩 3
  • 🤯 2
  • ❤‍🔥 1
  • 😭 1
Post #3879 23.5K
В марте Министерство обороны США признало компанию Anthropic угрозой для безопасности цепочек поставок после того, как переговоры о возможностях использования ее ИИ-моделей Claude военными зашли в тупик. Напомню, Anthropic требовала гарантий, что ее технологии не будут применяться для создания полностью автономного оружия или массовой слежки внутри США, в то время как Минобороны хотело получить от компании неограниченный доступ к Claude для использования в «любых законных целях». Ситуация на переговорах накалилась, в результате чего Anthropic стала первой американской компанией, публично объявленной угрозой для цепочек поставок. Этот статус запретил оборонным подрядчикам использовать технологии Anthropic при работе с ведомством.

В четверг федеральная судья в Сан-Франциско постановила, что внесение в черный список было незаконным. Судья пришла к выводу, что Министерство обороны нарушило Первую поправку, признав Anthropic угрозой для цепочек поставок «из желания сделать из компании показательный пример». Лин написала, что, хотя в вопросах национальной безопасности суды обычно полагаются на усмотрение правительства, в данном случае его действия не опирались на какие-либо «внятные основания».

«Ответчики утверждают, что из-за "все более враждебной риторики [Anthropic] в прессе" и критики взглядов военного ведомства на использование ИИ, они "не могут доверять Anthropic в вопросах обеспечения безопасности ее моделей", — написала судья в своем постановлении. — Ни Конституция, ни федеральный закон, на который ссылаются ответчики, не позволяют им вводить столь масштабные санкции, основываясь главным образом на том, что Anthropic критикует позицию Администрации».

Но это лишь первый суд из двух — судебное разбирательство в Вашингтоне все еще продолжается. До разрешения этого дела Anthropic формально по-прежнему сохраняет статус угрозы для цепочек поставок, но я почти уверен, что и там они дело выиграют.

Что интересно я полез проверять, подавали ли Anthropic иск из-за временного приостановления раскатки Fable в начале июня — оказалось, нет, так что никаких обновлений там не будет 🤷‍♂️
  • 👍 196
  • 🎉 57
  • ❤‍🔥 21
  • 👎 8
  • 🔥 7
  • 🌚 6
  • 🤔 4
  • 🤡 4
  • 💩 2
  • 🤣 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →