TGViewer
Channel Public Channel
SЕalytics (SEO-аналитика от Сергея Людкевича)

SЕalytics (SEO-аналитика от Сергея Людкевича)

@sealytics

Мысли по аналитике поисковых машин и сложным вопросам SEO от Сергея Людкевича

SEO-консалтинг, аудиты, onsite и onpage оптимизация.
Связь:
email: ludkiewicz@ya.ru
telegram: @ludkiewicz
skype: ludkiewicz_serge
сайт: https://www.ludkiewicz.ru/
Subscribers
2.88K
Photos
1.5K
Videos
13
Links
4.7K

Showing posts older than #5310 · Back to latest

Older Posts 14 shown
Post #5309 518
SЕalytics (SEO-аналитика от Сергея Людкевича) Сегодня компания Cloudflare анонсировала новую директиву Content-Signal, которая позволит сообщать через robots.txt , можно ли использовать ваш контент в обзорах ИИ от Google (а также для обучения ИИ). Ее значения: • search: разрешение на создание поискового…
Гуглоид Джон Мюллер заявил, что директива Content-Signal для файла robots.txt, введенная компанией Cloudflare, бесполезна:
"Насколько мне известно, ни один из веб-краулеров/LLM не использует директиву "content-signal" в файле robots.txt. Она была разработана CDN и, насколько мне известно, не оказывает никакого влияния ни на один веб-краулер или LLM. Ее использование лишь увеличивает объем и необходимость дальнейшего обслуживания файла robots.txt. Вы также можете добавлять в файл robots.txt другие произвольные параметры; веб-краулеры будут использовать только те директивы, которые они поддерживают, и игнорировать остальные."

Что и следовало доказать.
Reddit johnmu's comment on "Testing whether Content-Signal headers and llms.txt actually help with Person entity disambiguation" Explore this conversation and more from the TechSEO community
Post #5308 545
SЕalytics (SEO-аналитика от Сергея Людкевича) Топвизор сообщает: "Яндекс Директ снял ограничение на ранжирование в ТОП‑20 для Динамических мест на поиске. Это подтвердил Топвизору сотрудник поддержки: теперь при высокой релевантности запросу они рассматривают «гораздо большее количество страниц»." Ну…
Да ну?
Небольшой оксюморончик. 😄
  • 😁 10
Post #5307 464
SЕalytics (SEO-аналитика от Сергея Людкевича) Буржуйский сеошник Крис Грин немного покопался под капотом ChatGPT: "Основные источники информации, использованные в поиске: • Labrador: 88.1% • Bright: 9.9% • Oxylabs: 1.7% • SERP: 0.3% ... • Как правило, Labrador возвращает меньшие по размеру и более целенаправленные…
P.S. Немножно объяснений про источники поиска в ChatGPT от буржуйского сеошника Сугантана Моханадасана:
"serp — Базовый уровень открытого интернета, в основном используется в новостях (Yahoo, StreetInsider)

labrador — Список разрешенных издателей. Reuters, The Guardian, WSJ, FT, Wikipedia, даже arXiv. Сниппеты достигают ~1080 символов, по сути, это выдержки из целых статей.

bright — Bright Data, коммерческий веб-скрейпер. Доминирует в сфере покупок, финансов, погоды, местных новостей.

oxylabs — Oxylabs, конкурирующий скрейпер. Региональная и местная пресса, некоторые издания открытого интернета.

labrador выглядит как лицензионный уровень, несколько издателей заключили соглашения о контенте с OpenAI, и попасть туда можно только в том случае, если вы владеете национальной газетой.
bright и oxylabs — интересная пара. Названия указывают на Bright Data и Oxylabs, две коммерческие компании, занимающиеся скрейпингом, которые являются прямыми конкурентами. Я не вижу контракта в трафике, поэтому не буду утверждать, что ChatGPT им платит, но их открытая веб-загрузка проходит через обе платформы, и в поле указано, какая из них загрузила каждый результат. (Мы давно являемся клиентами Oxylabs для нашего SaaS-сервиса Keyword Insights.)
Во всех зарегистрированных мною запросах основную часть загрузки выполнял Bright, особенно по запросам, связанным с коммерцией, покупками, финансами и погодой. Oxylabs ориентировался на региональные и местные источники, Labrador — на новости и справочную информацию, а SERP — в основном на новости. Если говорить о категориях, то Labrador обрабатывал Reuters, WSJ, Wikipedia и TechRadar, Bright — Reddit, Forbes и rtings, а Oxylabs — прессу стран Персидского залива, такую ​​как Khaleej Times и Gulf News.
Я даже заметил разделение внутри одного запроса, связанного с погодой: Bright обрабатывал глобальные сайты данных, такие как Met Office, а Oxylabs — местную прессу стран Персидского залива. (Кстати, я живу в Дубае)"
Suganthan Mohanadasan How ChatGPT Actually Picks Sources (I Read the Network Traffic, Not the Outputs) — Suganthan I read 2 days of ChatGPT's raw network traffic to see how it picks sources, which domains get cited, and how to rank in and get cited by ChatGPT.
  • 🤝 2
  • 🤔 1
Post #5306 461
Буржуйский сеошник Крис Грин немного покопался под капотом ChatGPT:
"Основные источники информации, использованные в поиске:
• Labrador: 88.1%
• Bright: 9.9%
• Oxylabs: 1.7%
• SERP: 0.3%
...
• Как правило, Labrador возвращает меньшие по размеру и более целенаправленные наборы данных.
• Bright извлекает больше URL-адресов, больше цитирований и охватывает более широкий спектр доменов.
• Oxylabs встречается относительно редко, но демонстрирует сравнительно разнообразный выбор доменов.
...
• Поисковая выдача (SERP) появляется редко и тесно связана с новостными запросами.
...
Названия источников поиска, такие как Labrador, Bright, Oxylabs и SERP, по-видимому, представляют собой источники поиска, а не поисковые системы конечных пользователей. Их точная роль в архитектуре поиска OpenAI публично не задокументирована.
...
Для небольшого теста можно рассмотреть несколько довольно значимых реализаций.
• Источник поиска должен стать еще одним параметром, регистрируемым в ходе исследований видимости ИИ, везде, где это позволяет телеметрия. Игнорирование источника поиска чревато тем, что существенно различающиеся процессы поиска будут рассматриваться как идентичные.
• Оптимизация для ChatGPT отличается от оптимизации для других чат-ботов — это мы уже знали — но мы вводим еще один элемент оптимизации (или, по крайней мере,) понимания различных источников поиска внутри инструмента. Как мы можем оптимизировать их?
• Возможно, существуют еще более существенные различия между отслеживанием незарегистрированных пользователей бесплатных версий ChatGPT и пользователей, зарегистрированных и/или оплативших подписку."
Substack What can we learn from ChatGPT Search Sources? Can we learn/infer anything about the prompt/inner workings of ChatGPT’s search when sources change?
Post #5300 394

Forwarded from Канал / Яндекс Вебмастер

Как усилить органическое продвижение с помощью Яндекс Директа и Яндекс Метрики

Органическое и платное продвижение в Поиске лучше всего работают в связке. Пока SEO даёт долгосрочный результат, Яндекс Директ позволяет получать результат здесь и сейчас, не дожидаясь обновлений выдачи, а Яндекс Метрика позволяет проанализировать эффективность продвижения.

С помощью Яндекс Директа можно быстро проверить, какие заголовки лучше привлекают пользователей, и найти неочевидные ключевые слова, которые приносят конверсии.

Эти знания позволяют точечно доработать контент, чтобы сайт естественным образом рос в органической выдаче.


В карточках разобрали, как использовать возможности Яндекс Директа и Яндекс Метрики для развития вашего ресурса.

Если у вас возникнут вопросы по работе инструментов продвижения — задавайте их в комментариях. Наши коллеги из команды Яндекс Директа помогут во всём разобраться

📌Запустить кампанию в Директе
  • ❤ 1
  • 👍 1
Post #5299 584
Яндексоиды открытым текстом заявляют, что клики из Директа учитываются в алгоритме ранжирования. Не то, что бы это был большой секрет, но официальный пруф я вижу впервые:
  • 👍 2
Post #5297 537
SЕalytics (SEO-аналитика от Сергея Людкевича) Буржуйский сеошник Педро Диас раскрывает методику работы жалоб по DMCA в Google: "Сейчас вы можете удалить ЛЮБОГО из ваших конкурентов, просто используя фальшивые уведомления о нарушении авторских прав (DMCA). Google не проверяет личность уведомителя или достоверность…
Буржуйский сеошник Гленн Гейб предупреждает:
"Мошеннические запросы на удаление контента по DMCA — сейчас очень актуальная тема, и, похоже, многие люди, впервые сталкивающиеся с этой проблемой, не знакомы с ней. Вот ещё один интересный факт об удалении контента. Когда URL-адрес удаляется, кажется, что он удалён из индекса (поскольку он удаляется из результатов поиска), но если вы проверите URL-адрес в Google Search Console, он на самом деле проиндексирован. Это ещё одна запутанная ситуация для владельцев сайтов, которые могут подвергаться атакам. Если вы пропустите письмо от Google (если оно придёт), вы можете даже не заметить, что ваш сайт исчез из результатов поиска..."

Будьте внимательны.
  • 😢 4
  • 👍 2
Post #5296 529
SЕalytics (SEO-аналитика от Сергея Людкевича) Буржуйская сеошница Алейда Солис делится результатами опроса своих подписчиков, кто отвечает за поисковую оптимизацию с использованием искусственного интеллекта в компании, в которой вы работаете: "Набрав более 1212 голосов, мы пришли к выводу, что спор окончен:…
Кстати, многие новоявленные сервисы по GEO/AEO ничуть не лучше новоиспечённых экспертов. Буржуйский сеошник Тейлор Шер сетует:
"HubSpot, я тебя люблю, но что, чёрт возьми, это за рекомендации? Вы действительно советуете владельцам сайтов создавать 3 версии одного и того же списка, сгенерированного с помощью ИИ? И вы даёте подобные советы десяткам тысяч компаний, которые ничего не смыслят в этом? Извините, но это просто вопиющая халатность. HubSpot, вы даёте действительно вредные советы. Хотелось бы думать, что ваша команда должна была бы знать лучше, но я не уверен, раз вы, видимо, стали бы предлагать такую глупость своим клиентам. И моим клиентам и всем, кто меня читает, категорически запрещается использовать инструменты AEO от HubSpot. Эти рекомендации обесценят ваш сайт и никак не повлияют на видимость в LLM. Честно говоря, HubSpot, вы даёте опасные советы компаниям, которые ничего не смыслят в этом и доверяют вам как проверенной платформе. Действуйте лучше."

Похоже, в команде HubSpot нет сеошников. 😁
  • 👍 3
Post #5295 502
Буржуйская сеошница Алейда Солис делится результатами опроса своих подписчиков, кто отвечает за поисковую оптимизацию с использованием искусственного интеллекта в компании, в которой вы работаете:
"Набрав более 1212 голосов, мы пришли к выводу, что спор окончен:
* 86% - команда SEO-специалистов
* 9% - Поисковая команда с использованием искусственного интеллекта и оптимизаторов
* 1% - Поисковая команда с ИИ, не имеющая оптимизаторов
* 2% - другая команда по цифровому маркетингу
Это 95% компаний, где оптимизаторы руководят поиском с ИИ или непосредственно участвуют в нем. Только 1% доверили это команде без оптимизаторов.
Да, моя аудитория склоняется к поисковой оптимизации, но даже с этим предубеждением трудно поспорить с соотношением 95 к 1!
Реальность такова, что поисковая оптимизация с использованием искусственного интеллекта выполняется людьми, которые уже понимают, что поиск - это канал поиска и маркетинга... основные принципы были расширены, а не заменены."

А я вам так скажу. Если новоиспеченный GEO-эксперт не имеет серьезного бэкграунда в SEO, то настоятельно рекомендую держаться от него как можно дальше.
X (formerly Twitter) Aleyda Solis 🕊️ (@aleyda) on X While some still debate what AI search optimization should be called (GEO, AEO, LLMO…), companies have already answered the question that actually matters: who does the work 👇 I did a poll askin…
  • 👍 5
  • 😁 3
  • 🤣 1
Post #5294 529
Отличный пост буржуйского сеошника Дэвида МакСуини:
"Столько постов о том, как сделать ваш контент «машинно-читаемым» для LLM. Генеральные директора платформ отслеживания запросов в подкастах заявляют: «Впервые мы пишем не для людей, а для машин». С оговоркой, что я, как и всегда, рекомендую, чтобы контент был хорошо структурирован и понятен (потому что это просто хороший текст), но, на мой взгляд, всё это наоборот. Весь смысл LLM заключается в том, что они очень хорошо моделируют естественный язык. Они создают структуру из неструктурированного текста (и находят в нём смысл/закономерности). Это буквально то, чем они занимаются. В этом и заключался прорыв. Вот почему мы здесь об этом говорим. Вот как вы можете общаться со своим компьютером. В этом и заключается «магия». Проблема со структурой (если она есть) возникает буквально на уровне поиска/анализа/парсинга. Поскольку вывод данных обходится дорого, а контекстные окна конечны, LLM не увидит ваш документ целиком при широком поиске (т.е. при веб-поиске). Оптимизация заключается в том, чтобы убедиться, что извлеченная из вашего документа информация соответствует запросу (это математические вычисления и эвристика, прежде чем LLM что-либо увидит). Но это никак не связано с тем, что LLM не может «понять» и «прочитать» ваш текст. Это оптимизация для поиска. Для поиска. То, чем мы занимаемся десятилетиями. Более того, можно утверждать, что сейчас это проще, потому что LLM может работать со смыслом, а не только со строками. И да, иногда возникают реальные структурные проблемы. Таблицы трудно извлечь. Контент, сгенерированный JavaScript, может быть пропущен. PDF-файлы могут плохо обрабатываться. Краулеры могут блокироваться. Разметка может быть некорректной. Фрагменты могут быть выбраны неправильно. Но это не проблемы типа «LLM не может понять ваш текст». Это проблемы сканирования, анализа, извлечения, индексирования и поиска. Конечно, вы хотите убедиться, что ваш текст не противоречит сам себе, что факты и утверждения согласуются, и что вы доносите свои мысли. Внешне вы хотите убедиться, что ваше фирменное сообщение последовательно. Но это не имеет ничего общего с оптимизацией для машин. Вы должны были делать это и для людей в любом случае. Возможно, сейчас вас за это немного больше наказывают, но это всегда была проблема, которую вы должны были решать. Если кто-то говорит вам, что для понимания вашей статьи LLM нужно добавить микроразметку, вы должны серьезно усомниться в его понимании того, как работают LLM. Если кто-то говорит вам, что для GEO нужно разбить контент на части с заголовками, попросите его прочитать любое руководство по SEO, опубликованное за последние 30 лет. Мы всегда оптимизировали как для машин, так и для людей. Мы делаем это и сейчас. Но, как ни парадоксально, несмотря на океан инфографики LinkedIn, часть, касающаяся LLM, на самом деле больше связана с человеческой частью. Машинная часть — это поиск. Именно это вы и оптимизируете. Именно это мы всегда и оптимизировали. И именно это мы будем продолжать оптимизировать."

Полностью поддерживаю
X (formerly Twitter) David McSweeney (@top5seo) on X So many posts about making your content "machine readable" for LLMs. CEOs of the prompt tracking platforms going on podcasts saying "for the first time we're not writing for humans, we're writing…
  • 👍 6
Post #5293 543
Techcrunch сообщает:
"Компания Cloudflare установила для индустрии искусственного интеллекта новый крайний срок для разделения веб-краулеров, используемых для традиционного поиска, например, Google Search, от тех, которые используются для работы с ИИ-агентами и обучения. Начиная с 15 сентября 2026 года, настройки Cloudflare по умолчанию будут блокировать «смешанные» краулеры на любых страницах, где размещается реклама"

Интересно, а почему только на страницах с рекламой?
TechCrunch Cloudflare's new policy pushes AI companies to pay for publishers' content | TechCrunch Cloudflare is giving AI companies until September 15 to separate web crawlers used for search from those used for AI training and agents, or risk being blocked by default on many publisher sites.
Post #5292 596
Буржуйская сеошница Лили Рэй докладывает, как обстоят дела с масштабированием контента с помощью ИИ в выдаче Google:
"Только что обновила свою личную панель мониторинга, которая активно отслеживает показатели органического трафика всех публично опубликованных примеров 16 компаний, занимающихся масштабированием контента с помощью ИИ, в сравнении с пиковыми значениями трафика. Я скрыла названия компаний внизу... но тенденции довольно очевидны."

Как говорится, результат на табло.
Post #5291 627
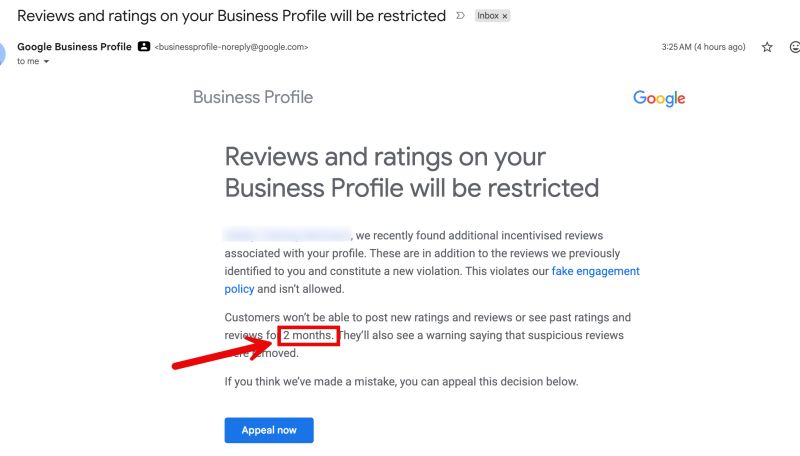
Гуглоиды начали увеличивать период отключения отзывов и оценок в Google Business Profile за рецидивы нарушений.
Буржуйский эксперт по продукту Google Business Profile Бен Фишер публикует сообщение о санкциях, в котором срок их действия увеличен со стандартного одного месяца до двух:
"Отзывы и оценки в вашем бизнес-профиле будут ограничены.
Недавно мы обнаружили дополнительные отзывы, полученные за вознаграждение, связанные с вашим профилем. Эти отзывы дополняют те, которые мы уже вам ранее сообщили, и представляют собой новое нарушение. Это противоречит нашей политике в отношении фальшивого взаимодействия и недопустимо.
В течение 2 месяцев клиенты не смогут оставлять новые оценки и отзывы, а также просматривать предыдущие оценки и отзывы. Кроме того, они увидят предупреждение о том, что подозрительные отзывы были удалены.
Если вы считаете, что мы допустили ошибку, вы можете обжаловать это решение ниже."
Post #5290 744
Топвизор сообщает:
"Яндекс Директ снял ограничение на ранжирование в ТОП‑20 для Динамических мест на поиске.
Это подтвердил Топвизору сотрудник поддержки: теперь при высокой релевантности запросу они рассматривают «гораздо большее количество страниц»."

Ну, теперь продажа позиций в органике Яндекса стала очевидным фактом. Поиск, который мы заслужили...
  • 😢 5
  • 👎 3
  • 😁 2
  • 🤬 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →