TGViewer
Channel Public Channel
AI Scope
Subscribers
143
Photos
226
Videos
25
Links
205

Showing posts older than #560 · Back to latest

Older Posts 20 shown
Post #559 147
AI Scope گرادیان
گرادیان چی هست اصلا؟


گرادیان تو یادگیری عمیق همون جهت و اندازه‌ی شیبِ خطاست.
یعنی به ما می‌گه اگه وزن‌های شبکه رو یک ذره کم یا زیاد کنیم، خطا چطور تغییر می‌کنه. مدل بعد از هر بار پیش‌بینی، خطا رو حساب می‌کنه و با گرفتن گرادیان می‌فهمه برای کمتر کردن این خطا باید وزن‌ها رو به کدوم سمت حرکت بده.

هرچی مقدار گرادیان بزرگ‌تر باشه یعنی خطا نسبت به اون وزن حساس‌تره و باید تغییر بیشتری بدیم، هرچی کوچک‌تر باشه یعنی نزدیکیم به نقطه‌ای که خطا کمینه‌ست.

کلِ فرایند یادگیری درواقع همین دنبال کردن و درس گرفتن از گرادیانه تا شبکه کم‌کم بهتر و دقیق‌تر بشه.

Gradients are essentially vectors of partial derivatives of the neural network's loss function concerning its weights and biases. The loss function quantifies the difference between the predicted output of the neural network and the actual target values


🦴 @scopeofai | #concepts
  • ❤ 1
  • 👍 1
Post #558 170
محوشدگی گرادیان (Gradient Vanish)

محوشدگی گرادیان یعنی وقتی شبکه‌ٔ عصبی عمیق رو آموزش می‌دیم، سیگنالِ یادگیری (گرادیان) موقع برگشت از لایه‌های آخر به لایه‌های اول اونقدر ضعیف می‌شه که تقریباً به صفر می‌رسه.
در نتیجه لایه‌های ابتدایی که باید مهم‌ترین ویژگی‌ها رو یاد بگیرن عملاً هیچ تغییری نمی‌کنن و مدل پیشرفت نمی‌کنه.
این مشکل معمولاً به خاطر عمق زیاد شبکه و وزن‌های اولیه‌ی نامناسب رخ می‌ده که راه‌حل داره و بعدا بهشون می‌پردازم

Gradient vanishing happens when a deep neural network tries to learn, but the learning signal (the gradient) becomes extremely small as it flows backward through many layers. By the time it reaches the early layers . the ones responsible for learning fundamental features the gradient is almost zero, so those layers barely update and the model stops improving. This usually comes from very deep architectures, bad weight initialization, or activation functions that squash values too much. AI engineers handle it with techniques like skip connections, LayerNorm, and modern activations that keep the gradient alive.
  • ❤ 1
  • 👍 1
Post #557 152
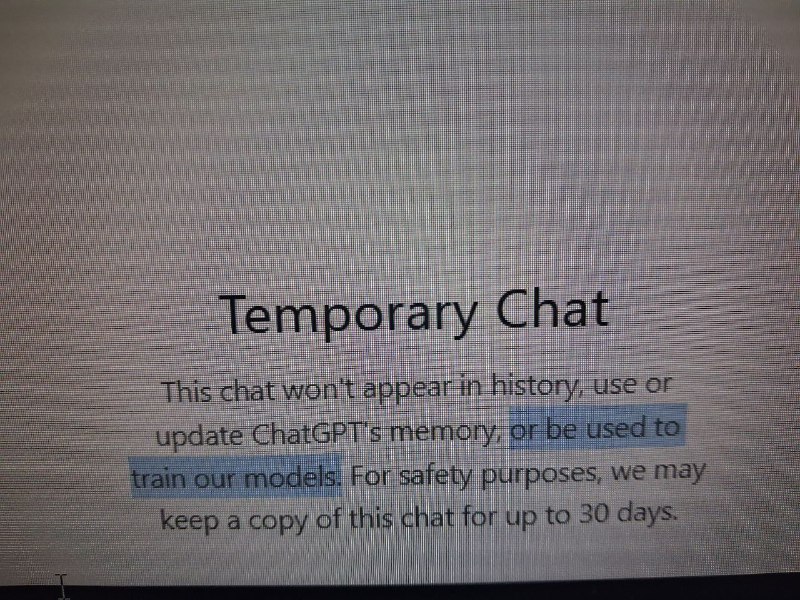
تنها وقتی چت‌های شما برای ترین کردن مدل‌های OpenAI مورد استفاده قرار نمی‌گیره که حالت "Temporary Chat" رو فعال کنید.

بقیه مواقع از تمام کلمات و ورودی‌های شما استفاده تکنولوژیک مي‌شه.

There's a cost for everything
  • ❤ 2
  • 👍 1
  • 😱 1
  • 💅 1
Post #556 125
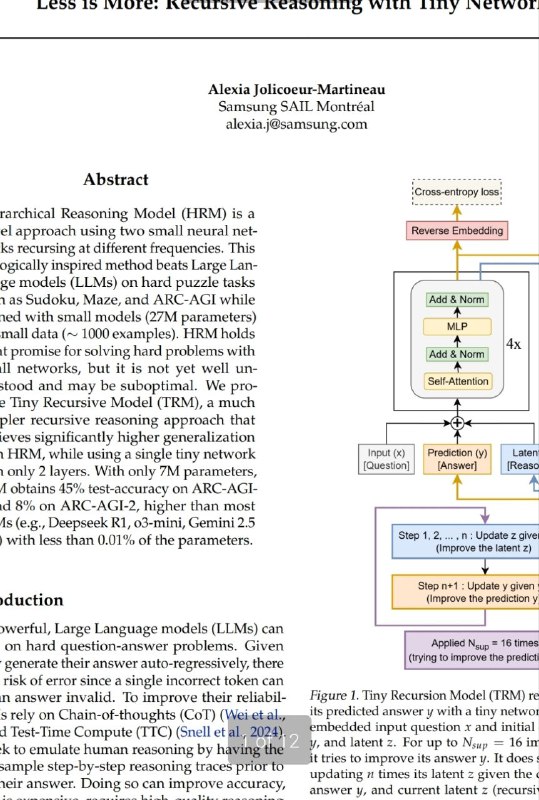
جالبه که این همه مقاله روزانه توی arxiv منتشر می‌شه ولی یهو مقاله‌ای که کلا دوازده صفحه و یک نویسنده داره میوفته روی زبون‌ها
خیلی رویکرد هوشمندانه‌ایه. دقیقا اسمش با ماهیت مدل و تعداد صفحاتش جور در میاد:
Less Is More
  • ❤ 2
  • 👍 2
  • 🔥 1
Post #555 102
AI Scope 2510-1.04871.pdf
باید حتما تحلیلش کنم
  • ❤ 2
  • 👍 1
Post #552 132
عملکرد خوبش از نظر آماری کاملا غیرممکنه
  • 👍 1
Post #551 141
فقط هم ۷ میلیون پارامتر داره و با ۱۰۰۰ نمونه آزمایشی ترین شده
  • 👍 1
Post #550 147
اما با عملکرد عجیب و نزدیک به همون مدل‌ها
  • 👍 1
Post #549 141
مدلی داده بیرون با یک صدم درصد اندازه مدل‌های فعلی
  • 👍 1
Post #548 136
سامسونگ دیر ولی قوی وارد مسابقه شده
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #547 184
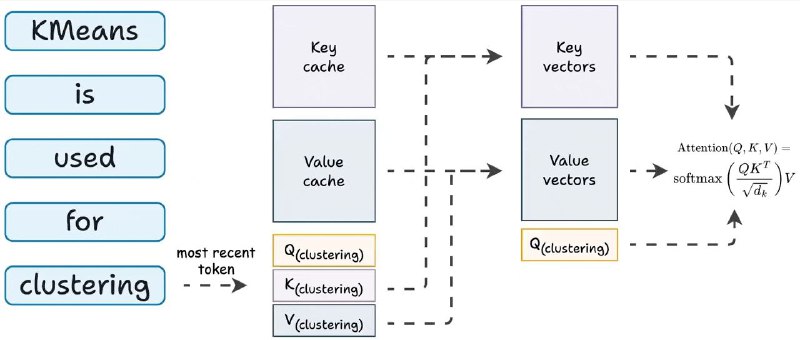
💡چت جی پی تی هم دقیقاً از همین ترفند استفاده می‌کنه.

وقتی باهاش حرف می‌زنی، لازم نیست کل مکالمه رو هر بار از اول بررسی کنه.
همون کلیدها و مقدارهای قبلی رو نگه می‌داره و فقط چیزای جدید رو بهش اضافه می‌کنه.

برای همینه که حتی وقتی گفت‌وگو طولانی میشه، چت جی پی تی بازم سریع جواب می‌ده و کند نمیشه.

خلاصه بخواییم بگیم:

کش KV یعنی حافظه‌ی موقتی که باعث میشه مدل لازم نباشه هر بار همه چی رو از اول حساب کنه.
  • ❤ 4
Post #546 139
کش KV توی ترنسفورمرها

🧠 مدل‌های زبانی بزرگ وقتی می‌خوان یه جمله رو بنویسن، باید برای هر کلمه‌ی جدید همه‌ی کلمه‌های قبلی رو هم دوباره بررسی کنن تا معنی درست دربیاد.
این کار اگه هر بار از اول انجام بشه، خیلی کند میشه.

اینجاست که کش KV کمک می‌کنه.
مدل وقتی بار اول جمله رو می‌خونه، برای هر کلمه دو تا چیز درست می‌کنه:

▫️Key (کلید) که نشون میده اون کلمه چه اطلاعاتی داره

▫️Value (مقدار) که مشخص می‌کنه اون اطلاعات چطوری باید استفاده بشن

مدل اینا رو نگه می‌داره توی حافظه،
و دفعه‌ی بعد فقط برای کلمه‌ی جدید محاسبه می‌کنه، نه برای همه‌ی قبلیا.

نتیجه اینه که مدل خیلی سریع‌تر کار می‌کنه و منابعش کمتر درگیر می‌شن مخصوصاً وقتی متن طولانیه.
  • ❤ 2
Post #545 126
کولب GPU واقعی می‌ده بهت


جی‌پی‌یوهایی که کولب می‌ده واقعی‌ان، نه شبیه‌سازی‌شده. معمولاً مدل‌هایی مثل Tesla T4
، P100 یا در نسخهٔ Pro+ مدل A100 هستن.
می‌تونی ببینی چه GPU بهت داده با دستور:

!nvidia-smi


ولی یه محدودیت داره. حافظهٔ GPU معمولاً بین ۱۲ تا ۱۶ گیگابایته. اگه موقع آموزش مدل با خطای “CUDA out of memory” روبه‌رو شدی (یعنی حافظه پر شده)، باید این کارو کنی:

import torch, gc
gc.collect()
torch.cuda.empty_cache()


این دستورها حافظهٔ اضافی GPU رو پاک می‌کنن تا دوباره بتونی آموزش رو ادامه بدی.
همچنین مهندسین حرفه‌ای معمولاً اندازهٔ batch size رو کمتر می‌کنن (تعداد نمونه‌هایی که هم‌زمان پردازش می‌شن) یا از قابلیت precision ترکیبی استفاده می‌کنن:

with torch.cuda.amp.autocast():
...


این باعث می‌شه حافظهٔ GPU کمتر مصرف بشه ولی سرعت آموزش تقریباً همون بمونه.


Colab gives real GPUs, but you have to manage memory smartl

yColab’s free GPU isn’t fake — it’s an actual NVIDIA card like Tesla T4, P100, or A100 (Pro + only). You can check which one you got with

:!nvidia-sm


iBut VRAM is limited (12–16 GB). So if your model crashes with “CUDA out of memory,” pros do this

:import torch, g
cgc.collect(
)torch.cuda.empty_cache(


That clears leftover memory.
They also lower the batch size (how many samples are processed at once) or use torch.cuda.amp.autocast() for mixed precision to save VRAM while training large models
  • ❤ 5
Post #544 101
⚠️ ماشین‌های کولب موقتی هستن

وقتی یه نوت‌بوک جدید توی گوگل کولب باز می‌کنی، گوگل یه ماشین مجازی (Virtual Machine) بهت می‌ده که فقط تا وقتی فعالی وجود داره.

اگه تب رو ببندی یا چند دقیقه کاری نکنی، اون ماشین پاک می‌شه. یعنی هرچیزی که نصب کردی یا دانلود کردی از بین می‌ره.

اما مهندسین هوش مصنوعی یه راه‌حل دارن:

درایو گوگل خودشون رو وصل می‌کنن و فایل‌های مهم مثل مدل یا داده‌ها رو اون‌جا ذخیره می‌کنن:

from google.colab import drive
drive.mount('/content/drive')

یه اسکریپت آماده دارن که هر بار نوت‌بوک اجرا می‌شه، خودش به‌صورت خودکار کتابخونه‌ها رو نصب کنه:

!pip install -q torch transformers datasets

به این ترتیب، هر بار که ماشین کولب از نو شروع بشه، فقط چند ثانیه طول می‌کشه تا دوباره مثل قبل آمادهٔ کار بشه.


Colab’s machines are temporary

When you open a Colab notebook, Google gives you a virtual machine (VM) that exists only while your session is active. Once you close the tab or stay idle too long, it gets deleted — including everything you installed or downloaded.
But AI engineers bypass that:

They connect their Google Drive and store checkpoints or model weights there (drive.mount('/content/drive')).

They also create setup scripts that reinstall all dependencies automatically each time the notebook starts (!pip install -q torch transformers datasets).
So every time the VM restarts, it rebuilds itself in seconds.
  • ❤ 3
Post #543 92
گوگل کولب چیه؟

گوگل کولَب مثل یه دفترچه آنلاین رایگانه که می‌تونی توی مرورگر خودت باهاش کد پایتون بنویسی و اجرا کنی. بدون اینکه لازم باشه چیزی نصب کنی.

کافیه با اکانت گوگل وارد بشی، یه "notebook" جدید باز کنی، کد بنویسی، روی اجرا بزنی و همون‌جا نتیجه رو ببینی.
چیزی که کولب رو خاص می‌کنه اینه:

1⃣ رایگان بهت GPU یا TPU می‌ده
2⃣ همه‌چیز روی Google Drive ذخیره می‌شه و می‌تونی دفترت رو مثل یه فایل Google Docs با بقیه به اشتراک بذاری.


Think of Google Colab like a free online notebook where you can write and run Python code in your browser — no installation needed.

You log in with your Google account, open a new “notebook”, type code into a cell, hit run, and see results immediately.

What makes it really helpful: (1) It gives you access to faster hardware (GPUs/TPUs) for free, so you can experiment with heavier tasks than your
(2) Everything is saved in your Google Drive and you can share the notebook with someone else like you share a Google Doc.
  • ❤ 3
Post #542 206
🕹 کتابخونه Numpy یه کتابخونه قدرتمند و پراستفاده پایتونه برای محاسبات عددی و کار با آرایه‌ها.
توی یادگیری ماشین هم استفاده ميشه زیاد.

برای آشنایی باهاش و کاربردش توی یادگیری ماشین این مقاله رو می‌تونید بخونید:

https://madewithml.com/courses/foundations/numpy/
Madewithml NumPy for Machine Learning - Made With ML by Anyscale Numerical analysis with the NumPy computing package.
  • 👍 3
  • ❤ 1
Post #540 158
پارامترها چطور یاد می‌گیرن و چرا مهمن

🅾 وقتی یک مدل هوش مصنوعی آموزش می‌بینه، داده‌ها رو حفظ نمی‌کنه بلکه پارامترهاش رو تنظیم می‌کنه.

💡هر پارامتر بسته به اینکه پیش‌بینی مدل چقدر درست یا غلط بوده، کمی تغییر می‌کنه. با میلیون‌ها یا حتی میلیاردها بار تکرار این فرایند، مدل یاد می‌گیره روابط پیچیده بین کلمات، تصویرها یا صداها رو درک کنه.

به همین دلیل معمولاً به پارامترها می‌گن «حافظه» یا «دانش» مدل.

هرچقدر مدل پارامترهای بیشتری داشته باشه (و بهتر آموزش دیده باشه)، درک عمیق‌تری از الگوهای ظریف مثل لحن، مفهوم، یا حتی احساسات در متن پیدا می‌کنه.


How Parameters Learn and Why They Matter

When an AI model trains, it doesn’t memorize data — it adjusts its parameters.
Each parameter slightly changes based on how correct or wrong the model’s predictions are. Through millions or even billions of these small adjustments, the model learns complex relationships between words, images, or sounds.

That’s why parameters are often called the “memory” or “knowledge” of a model. The more parameters a model has (and the better it’s trained), the more subtle patterns it can understand — like tone, context, and even emotions in text.
  • ❤ 1
  • 🔥 1
Post #539 159
دو نوع اصلی پارامتر

1⃣پارامترهای ساختاری: اینا مشخص می‌کنن مدل چه شکلی ساخته بشه؛ یعنی لایه‌های نورون‌های مصنوعی چطور چیده و به هم وصل بشن. می‌شه گفت مثل نقشه یا اسکلت اصلی مدلن

2⃣پارامترهای رفتاری: اینا تعیین می‌کنن مدل وقتی داده می‌گیره چطور رفتار کنه؛ مثل میزان واکنش‌پذیری، انعطاف و نوع جواب‌هایی که می‌ده. این پارامترها باعث می‌شن مدل بسته به نوع داده ورودی یا حتی اتصال به اینترنت، رفتار متفاوتی نشون بده

Two Key Types of Parameters

Construction Parameters – These define the model’s architecture: how layers of artificial neurons are arranged, connected, and weighted. Think of them as the blueprint or skeleton that gives the model its structure.
Behavior Parameters – These govern how the model acts when given input. They control responsiveness, adaptability, and output style. Behavior parameters influence whether a model gives concise answers, creative dialogue, or factual recall, depending on the data it receives and how it’s connected to external sources.
  • ❤ 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →