Microsoft выпустила Phi-3
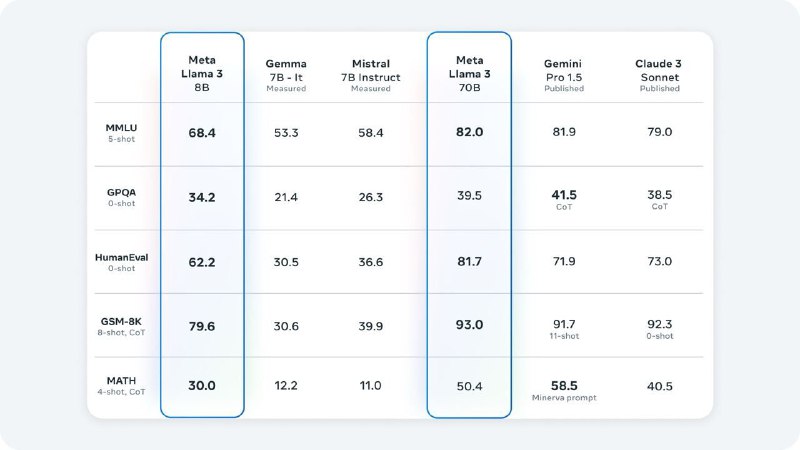
Моделька интересная и довольно умная, есть поддержка 128к контекста, запускается на айфоне со скоростью в 12 токенов в секунду. Поздно запостил я потому что у неё подозрительно хорошие результаты бенчмарков: mini (3.8B на 3.3 триллионах токенов) версия модели тягается с
LLaMa 3 8B (15 триллионов токенов), а medium - с
Mistral 8x22B Instruct. По поводу моделей семейства давно
ходят шутки что это из-за того что их тренируют на бенчмарках, но авторы заявляют что это из-за того что их датасет лучше всех учит модельку размышлению. Через трое суток после релиза весов возможно, что автора правы, но я все ещё жду проверки этой модели на ChatBot Arena, так как доверия бенчмаркам нет.
Предыдущие модели семейства Phi тренировали на синтетических данных, тут же, большая часть датасета - данные из интернета. Тренируют в две стадии: первая - тренировка на сильно отфильтрованных данных. На второй стадии её, как и прошлые модели, тренируют на синтетических данных, но добавляют ещё более отфильтрованную примесь данных из интернета.
Авторы пытаются отсеять данные которые LLM такого размера и так вряд ли выучит, например результаты конкретных спортивных матчей. Назвали они это
Data Optimal Regime, но у него есть заметный минус: после 7B параметров качество почти не растёт, 14B моделька очень недалеко ушла от 7B модели. Тут может быть две интерпретации: первая – из датасета убрали всё, что не может понять 3B моделька (то есть что-то
такое, только для LLM), вторая – модель выучила все ответы на бенчмарки, что были в датасете и насытилась. Из-за этого, хоть в пейпере речь идёт о моделях трёх размеров: mini (3.8B), small (7B) и medium (14B), пока что релизнули только самую маленькую.
--
На видео, демонстрации инференса в fp16 на M3 Max: Вход - 131.917 tps, Генерация- 43.387 tps. Бегает шустро, но можно сделать ещё быстрее.
А вы что думаете про Phi-3?
Technical report4k версия модели128k версияТут можно початиться с моделькой@ai_newz